Qwen-Image-2.1 на Alibaba превъзхожда затворени модели за изображения с едва 7 млрд. параметъра
Изображение: Svetni.me / Авторско изображение
Екипът на Alibaba представи най-новия си визуален модел с отворени тегла Qwen-Image-2.1, демонстрирайки че компактна мрежа с едва 7 милиарда параметъра може да съперничи на значително по-тежки комерсиални алтернативи, съобщава The Decoder [1].
Разработката представлява ключов етап в еволюцията на отворените дифузионни модели за компютърно зрение, предоставяйки фотореалистично качество и точно изписване на текст при умерени изчислителни изисквания [1].
Изображение: Svetni.me / ИИ генерирана инфографика
Висока плътност на детайла и текстова прецизност
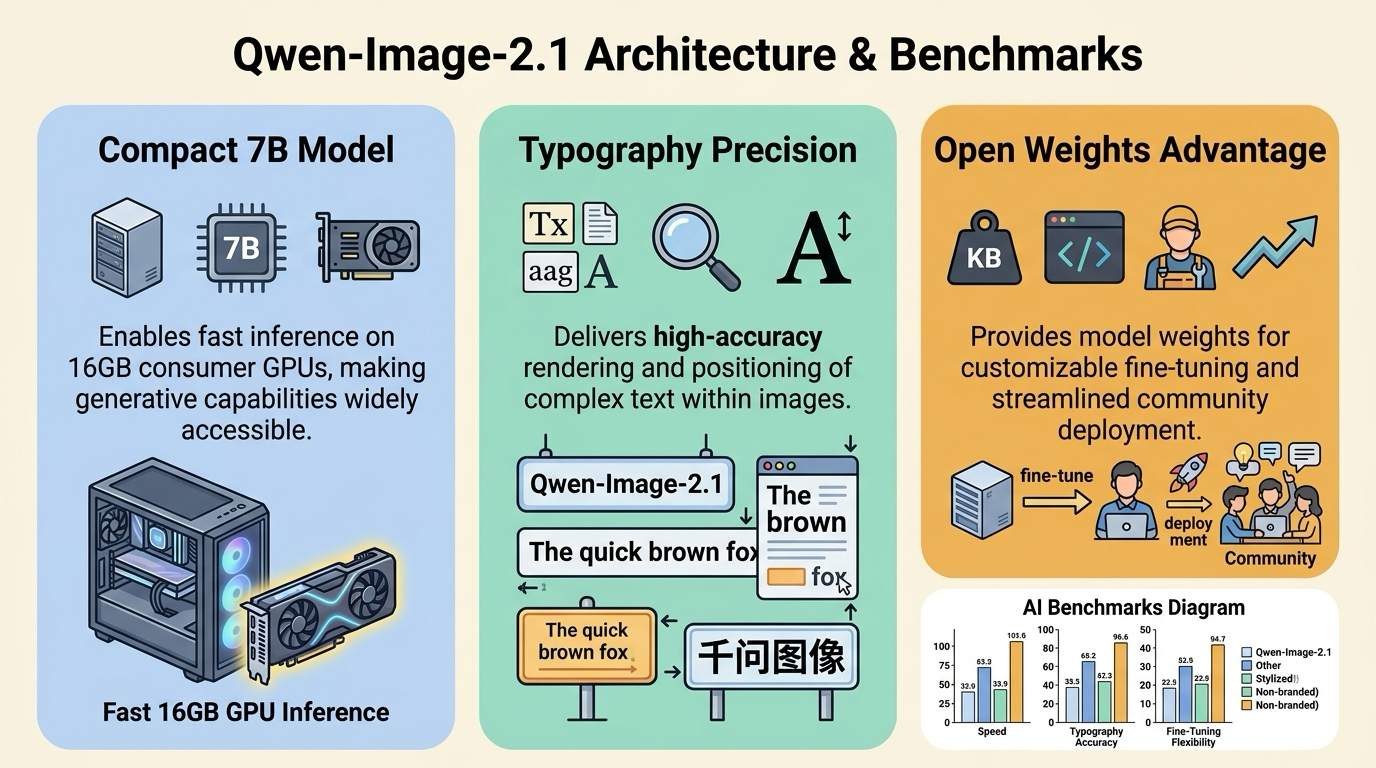
Един от традиционните дефекти при генерацията на изображения е изкривяването на буквените знаци и надписите. Qwen-Image-2.1 интегрира нов модул за семантично подравняване, позволяващ прецизно изписване на сложни фрази на английски и китайски език.
Моделът превъзхожда редица водещи затворени системи на популярни тестови бенчмаркове, като се справя забележително добре с [1]:
Сложни пространствени композиции: Правилно позициониране на обекти според детайлни текстови описания.
Светлинна физика и текстури: Реалистично отразяване на светлината върху разнообразни повърхности, включително стъкло и метал.
Демократизация на локалната генерация
Благодарение на оптимизирания размер от 7B, моделът може да бъде стартиран локално на потребителски графични карти с 16 GB видеопамет (VRAM).
Това позволява на независими студиа, дизайнери и разработчици да използват висококачествена визуална генерация без зависимост от скъпи облачни абонаменти или ограничения за поверителност.
Източници: