Ценова революция при водещите модели: OpenAI пусна GPT-6 Sol и Luna, а Anthropic отговори с Claude Opus 5.5
Изображение: Svetni.me / ИИ генерирано изображение
Глобалният пазар за генеративен изкуствен интелект навлезе в нов етап, доминиран от прагматично сравнение на производствените разходи и възвръщаемостта на изчислителните инвестиции. Според публикации на TechCrunch [1] и Ars Technica [7], технологичните лидери пренасочват фокуса си от преследване на върхови абстрактни рекорди към драстично понижаване на себестойността на инференса и повишаване на надеждността при масово внедряване на големи езикови модели.
В рамките на броени часове OpenAI обяви официалното пускане на моделите GPT-6 Sol и GPT-6 Luna [1], [3]. Едва деветдесет минути по-рано Anthropic представи следващото поколение на своя работен кон – Claude Opus 5.5 [4], [5]. Това едновременно навлизане на по-евтини системи от висок клас дава нов тласък на ценовата война за токени.
Изображение: Svetni.me / ИИ генерирана инфографика
Архитектурата на GPT-6: Разделение на труда между Sol и Luna
След като по-рано през месеца обяви премиум флагмана GPT-6 Astra, ориентиран към научни пробиви и формални математически доказателства, OpenAI разшири шестото си поколение с две по-компактни невронни мрежи [1]. Новата архитектура на GPT-6 разделя индустриалните работни потоци между два специализирани инструмента с различен профил.
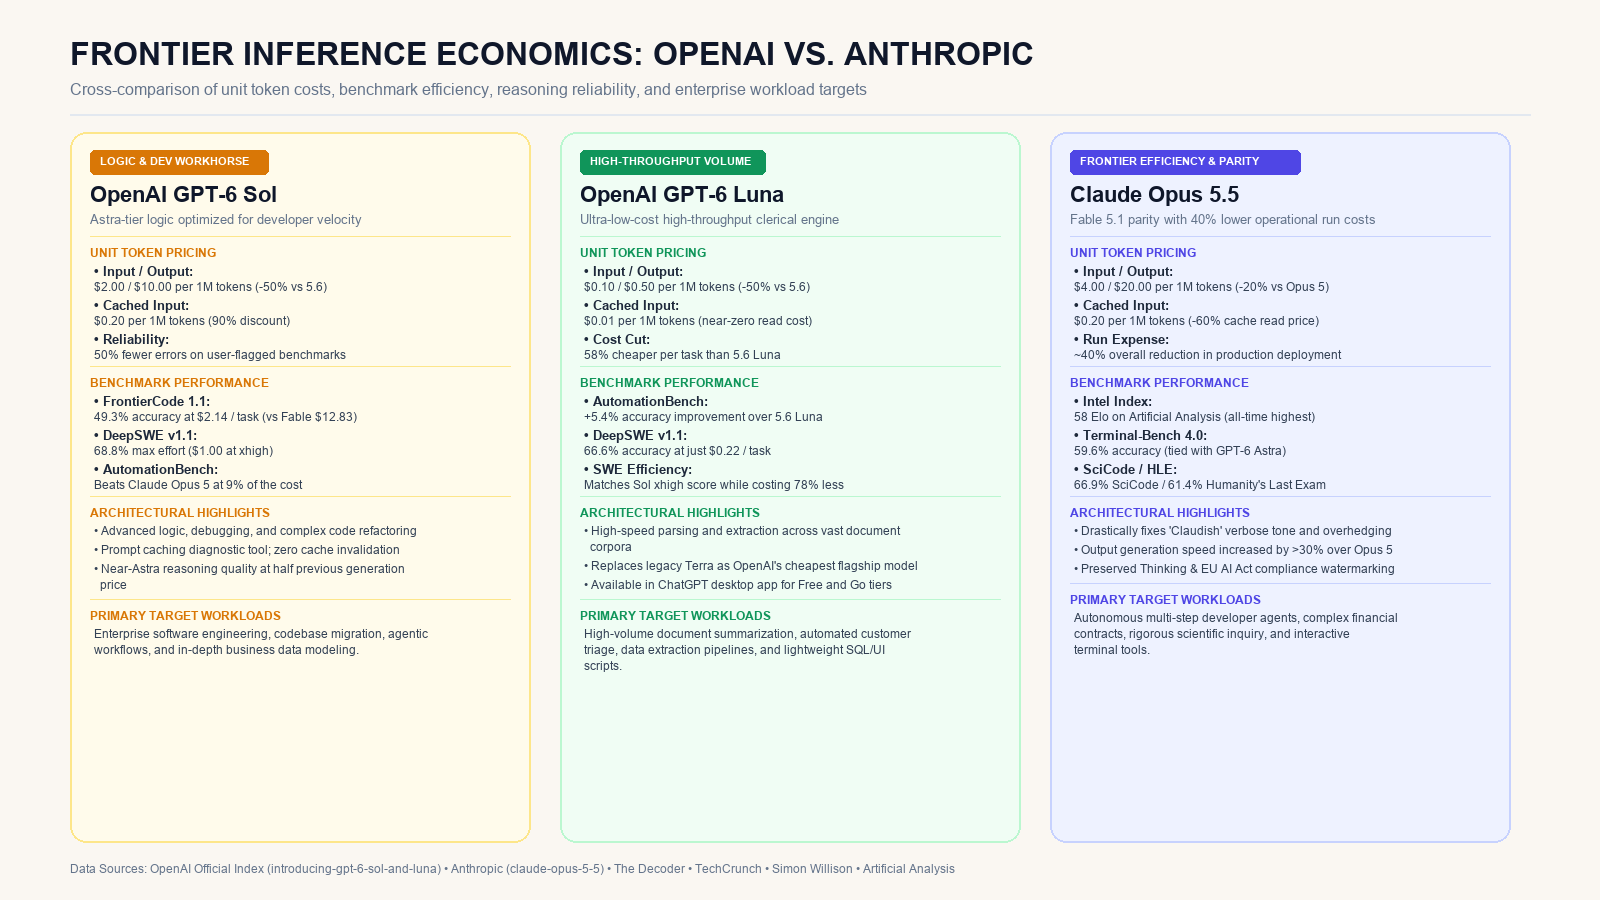
Моделът GPT-6 Sol е разработен за комплексни инженерни дейности като изграждане на нови софтуерни модули, ревю на код, дебъгване и анализи [2]. Според вътрешни оценки на лабораторията, базирани на реални потребителски диалози, Sol допуска наполовина по-малко фактологични грешки спрямо серия 5.6, доближавайки надеждността на Astra при значително по-ниска цена [1], [3].
От своя страна, GPT-6 Luna е проектиран за масови чиновнически задачи с ясни инструкции и висок обем. Моделът се фокусира върху синтезиране на обемни документи, структурирано извличане на данни и директни отговори [1], [2]. На стандарта AutomationBench системата Luna превъзхожда изданието 5.6 с 5,4 процентни пункта, намалявайки разходите за завършена задача с 58% [3].
Икономика на инференса: 50% срив в цените на OpenAI
Ключовият технологичен напредък при новите предложения на OpenAI се крие в оптимизацията на изчислителните процеси и алгоритмите за кеширане [1]. Компанията обяви 50% намаление на официалните API тарифи спрямо поколението 5.6, което позиционира новите модели на ценово ниво, съпоставимо с по-евтините отворени алтернативи [2].
Ползването на GPT-6 Sol струва 2,00 долара за милион входящи и 10,00 долара за милион изходящи токена [3]. При GPT-6 Luna цената пада до рекордните 0,10 долара за вход и 0,50 долара за изход [3]. С тези нива Luna се превръща в един от най-достъпните модели в каталога на OpenAI, докато междинният вариант Terra е напълно спрян от предлагане [2].
Наред с базисните цени, OpenAI въвежда подобрено контекстно кеширане, осигуряващо 90% отстъпка за предварително обработени входящи токени [2]. Разработчиците вече могат да променят интензитета на разсъжденията и достъпните инструменти, без това да анулира кеша, което носи значителни икономии при продължителни агентни сесии [2].
Отговорът на Anthropic: Claude Opus 5.5 и паритетът с Fable 5.1
Отговорът на Anthropic е моделът Claude Opus 5.5, който според компанията постига капацитета на върховия флагман Claude Fable 5.1 в почти всички практически направления, но при чувствително по-ниска издръжка [4], [5]. Тарифите за токени са намалени с 20% спрямо предходните издания от серията Opus, достигайки 4,00 долара за милион входящи и 20,00 долара за милион изходящи токена [5].
Още по-осезаемо е намалението при четенето от кеша, където цената пада с 60% до 0,20 долара за милион токена [5]. Тъй като системата изисква по-малко токени за завършен отговор и генерира текст с над 30% по-висока скорост, Anthropic изчислява, че общите производствени разходи падат с около 40% спрямо Opus 5 [5], [6].
За абонатите на платените планове компанията увеличава петчасовите лимити за ползване с 20% [5], [6]. Съчетанието от по-голям лимит и по-бавно изчерпване на квотите осигурява на практиците приблизително 50% по-голям ефективен капацитет за работа [6].
Сблъсъкът на бенчмарковете: Селективни победи и реална стойност
Официалните бенчмаркове показват комплексна надпревара, в която всяка компания акцентира върху собствените си предимства [2], [5]. При специализирания тест за програмиране FrontierCode 1.1 моделът GPT-6 Sol постига 49,3% успеваемост при 2,14 долара за задача, конкурирайки Claude Fable 5.1 (50,3%), чието изпълнение обаче струва шест пъти повече – 12,83 долара [2].
На теста DeepSWE v1.1 моделът Sol достига 68,8% при максимално разсъждение и 66,6% на режим „xhigh“ за 1,00 долар [2]. По-малкият вариант Luna постига идентичните 66,6% при максимално усилие за едва 0,22 долара на задача – с 78% по-евтино от Sol [2]. Анализатори обаче посочват, че OpenAI е пропуснала в първоначалния си доклад общоприети стандарти като Terminal-Bench 4.0 и GDPval [2].
От своя страна, независимата платформа Artificial Analysis потвърждава силните позиции на Claude Opus 5.5, който отбелязва рекордните 58 пункта в нейния глобален индекс на интелигентност [5]. Моделът оглавява шест от десет академични и инженерни класации, изравнявайки резултата на GPT-6 Astra на Terminal-Bench 4.0 с 59,6% [5]. Анализаторите все пак предупреждават, че при максимални настройки Opus 5.5 може да изразходва до 119 000 изходящи токена за една задача, изисквайки внимателен контрол [5].
Премахването на „клодиша“ и по-изчистеният стил на писане
Освен параметрите за скорост и разходи, Anthropic въвежда фундаментални корекции в начина, по който семейството Claude формулира отговорите си [5]. Новата итерация целенасочено адресира оплакванията от монотонния, излишно витиеват и нравоучителен стил, популярен сред софтуерните специалисти като „Claudish“ [5].
Моделът Opus 5.5 поставя съществената информация в самото начало, избягва празната корпоративна терминология и следва по-стриктно форматирането [5]. Отзивите от корпоративни партньори подчертават тази промяна [6]:
Вицепрезидентът по ИИ в Box Яшода Бхавнани посочва, че отговорите са с 40% по-кратки без никаква загуба на точност [6].
Джон Руелас от Ramp споделя, че системните архитектурни спецификации се прилагат директно с минимални корекции [6].
Карл Бенет от Deloitte Consulting отчита, че дори на най-ниско ниво на разсъждение Opus 5.5 засича 72% от известните дефекти при преглед на код срещу 56% при предишния модел [6].
Мерки за безопасност и регулаторни бариери
Премиерите се провеждат в период на остри дискусии относно темпото на развитие на фронтиерните изчислителни системи [4], [5]. Claude Opus 5.5 е първото издание на Anthropic, откакто Дарио Амодей призова за съгласувано забавяне на новите модели спрямо напредъка на защитните механизми [4], [6].
Компанията въвежда автоматична маршрутизация при задачи с повишен риск [5]. Заявки за киберсигурност се пренасочват автоматично към Opus 4.8, а тези за биологични оръжия – към Opus 5, като достъп до пълния потенциал се дава само след верификация [5], [6].
В допълнение, Opus 5.5 интегрира защитата „Preserved Thinking“ срещу дистилационен шпионаж чрез подправяне на контекста в API, както и задължителни водни знаци съгласно Европейския законодателен акт за ИИ [5]. Чрез тези стъпки пазарът преминава от чисто технологични демонстрации към пряка битка за масова икономическа приложимост [7].
Източници:
[1]: OpenAI launches GPT-6 Sol and Luna, boasting lower cost and fewer mistakes - TechCrunch
[3]: ChatGPT-6 Sol and Luna are here: Pricing and benchmarks data - Mashable
[4]: Anthropic releases Opus 5.5 with lower prices and Fable-level performance - TechCrunch
[6]: Claude Opus 5.5 delivers Fable 5.1 performance – and costs 40% less - ZDNet
[7]: New Anthropic, OpenAI models make same promise: A little more for a lot less money - Ars Technica