Водните знаци в езиковите модели намаляват разсъждаващата способност на ИИ агентите, сочи проучване
Снимка: Lasso Security Research
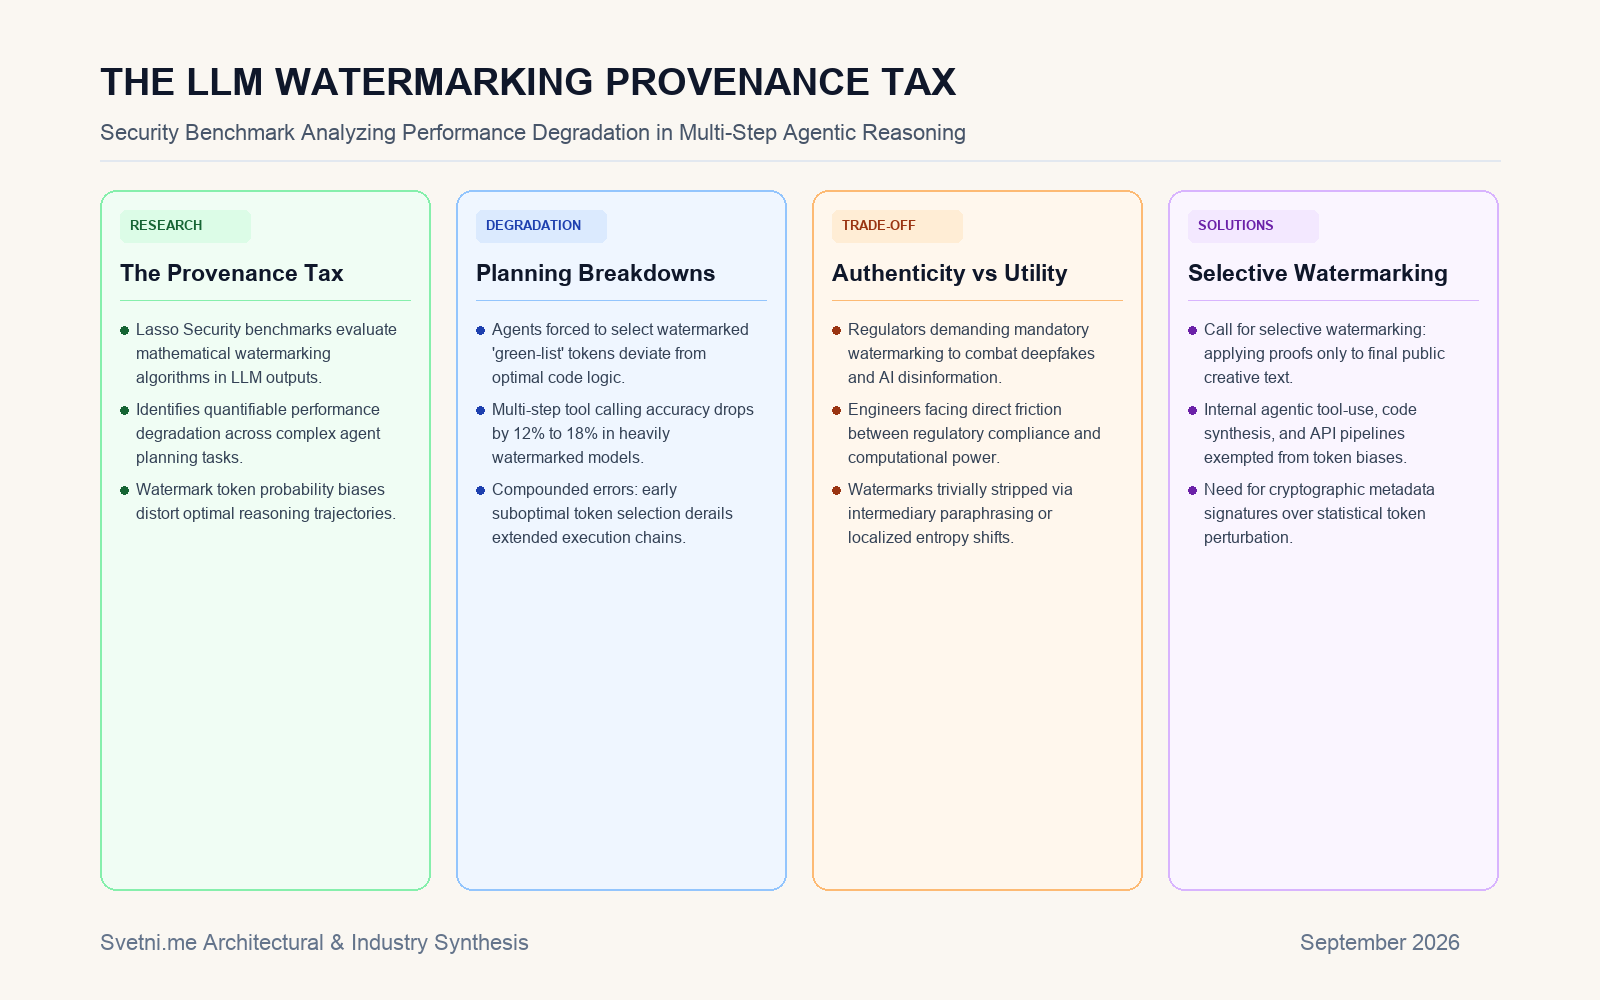
Технически доклад на компанията за сигурност Lasso Security разкри неочакван и тревожен страничен ефект от внедряването на цифрови водни знаци в големите езикови модели [1]. Оказва се, че математическите методи за маркиране на машинно генериран текст налагат т.нар. „данък върху произхода“ (provenance tax), водещ до забележимо влошаване на логическото мислене и планирането при автономните агенти [1].
Технологията на водните знаци разчита на фино манипулиране на вероятностите при избор на следваща дума (зелени и червени списъци от токени), така че в изходния текст да се кодира невидима статистическа сигнатура [1]. Когато обаче моделът се използва като автономен софтуерен агент, това изкривяване на вероятностите принуждава невронната мрежа да избира субоптимални команди и параметри, нарушавайки логическите вериги [1].
Инфографика: Светни.ме
Срив в точността при многостъпкови задачи
Експериментите на Lasso Security показват, че при задачи, изискващи последователно извикване на външни инструменти и писане на код, точността на агентите спада с 12 до 18 процента при активирани водни знаци [1]. Грешката има тенденция да се натрупва лавинообразно: един леко изкривен токен в началото на изпълнението води до тотален провал на задачата пет стъпки по-късно в киберсигурността [1].
„Законодателите настояват за задължителни водни знаци за борба с дезинформацията, но тази мярка директно спъва автономните софтуерни системи, от които бизнесът очаква безпогрешна работа“, посочват авторите на изследването [1].
Призив за изключване на вътрешните системни потоци
Експертите препоръчват регулаторите и платформените оператори да диференцират приложението на водните знаци [1]. Докато маркирането е оправдано при генериране на публични статии и съобщения в социалните мрежи, то трябва да бъде напълно забранено при вътрешни машинни комуникации, извикване на API интерфейси и изпълнение на критичен код [1].
Източници:
[1]: Understanding the Impact of LLM Watermarking on AI Agent Behavior - Lasso Security / Hacker News