Разсекретени документи по делото на Authors Guild: Ръководители на OpenAI и Microsoft са били наясно с рисковете от пиратско съдържание
The Authors Guild Legal Archive
Дългогодишната съдебна битка за авторските права в ерата на изкуствения интелект навлезе в драматична фаза след разсекретяването на поверителни вътрешни документи по делото на Authors Guild срещу OpenAI и Microsoft [1]. Материалите разкриват, че висши инженерни мениджъри са водили оживени дебати относно законността на използването на пиратски сайтове („сенчести библиотеки“) като Books3 и Library Genesis за захранване на моделите GPT [1].
Според огласените имейли служители са изразявали загриженост, че използването на подобни източници без изрично съгласие на авторите създава огромен риск от съдебно преследване, но изискването за бързо мащабиране на моделите е надделяло над правните съображения [1].
Трансформативна употреба или масово присвояване?
Защитата на OpenAI продължава да се опира на доктрината за „честна употреба“ (Fair Use) в американското законодателство, твърдейки, че процесът на обучение извлича статистически и семантични зависимости, а не копира самите произведения за директно разпространение [1].
Разсекретените протоколи обаче показват, че ищците са събрали доказателства за случаи, в които ранните версии на моделите са можели да възпроизвеждат цели пасажи от защитени романи почти дума по дума при специфично структурирани промптове [1]. Това поставя под съмнение аргумента, че моделите са само абстрактни статистически репрезентации [1].
Отговорността на инвеститорите
Делото е от фундаментално значение и за ролята на Microsoft, която е съответчик в производството в качеството си на доставчик на изчислителната мощ за обучение на моделите [1]. Ако съдът постанови, че компанията носи съвместна отговорност за нарушение на авторските права, това може да принуди технологичната индустрия да премине към всеобхватен лицензионен модел за всички входни данни [1].
Икономическият императив за лицензионен консенсус в ерата на синтетичните данни
Разсекретените съдебни материали по делото срещу OpenAI и Microsoft бележат края на епохата на свободното и нерегламентирано извличане на публично достъпна интелектуална собственост [1]. Докато първоначалният пробив на генеративните технологии се дължеше на безконтролното агрегиране на милиони литературни и научни произведения, правната несигурност около този подход вече заплашва самите финансови основи на технологичните гиганти [1].
В резултат на съдебния натиск водещите лаборатории са принудени коренно да преструктурират своите изследователски бюджети, насочвайки стотици милиони долари към официални лицензионни споразумения с издателски къщи и автори [1]. Успоредно с това фокусът се измества към създаването на строго контролирани синтетични данни за обучение [1]. Този процес обаче рязко увеличава капиталовите изисквания за разработка на базови невронни мрежи, което на практика циментира позициите на най-богатите корпорации и затруднява навлизането на нови независими играчи в сектора [1].
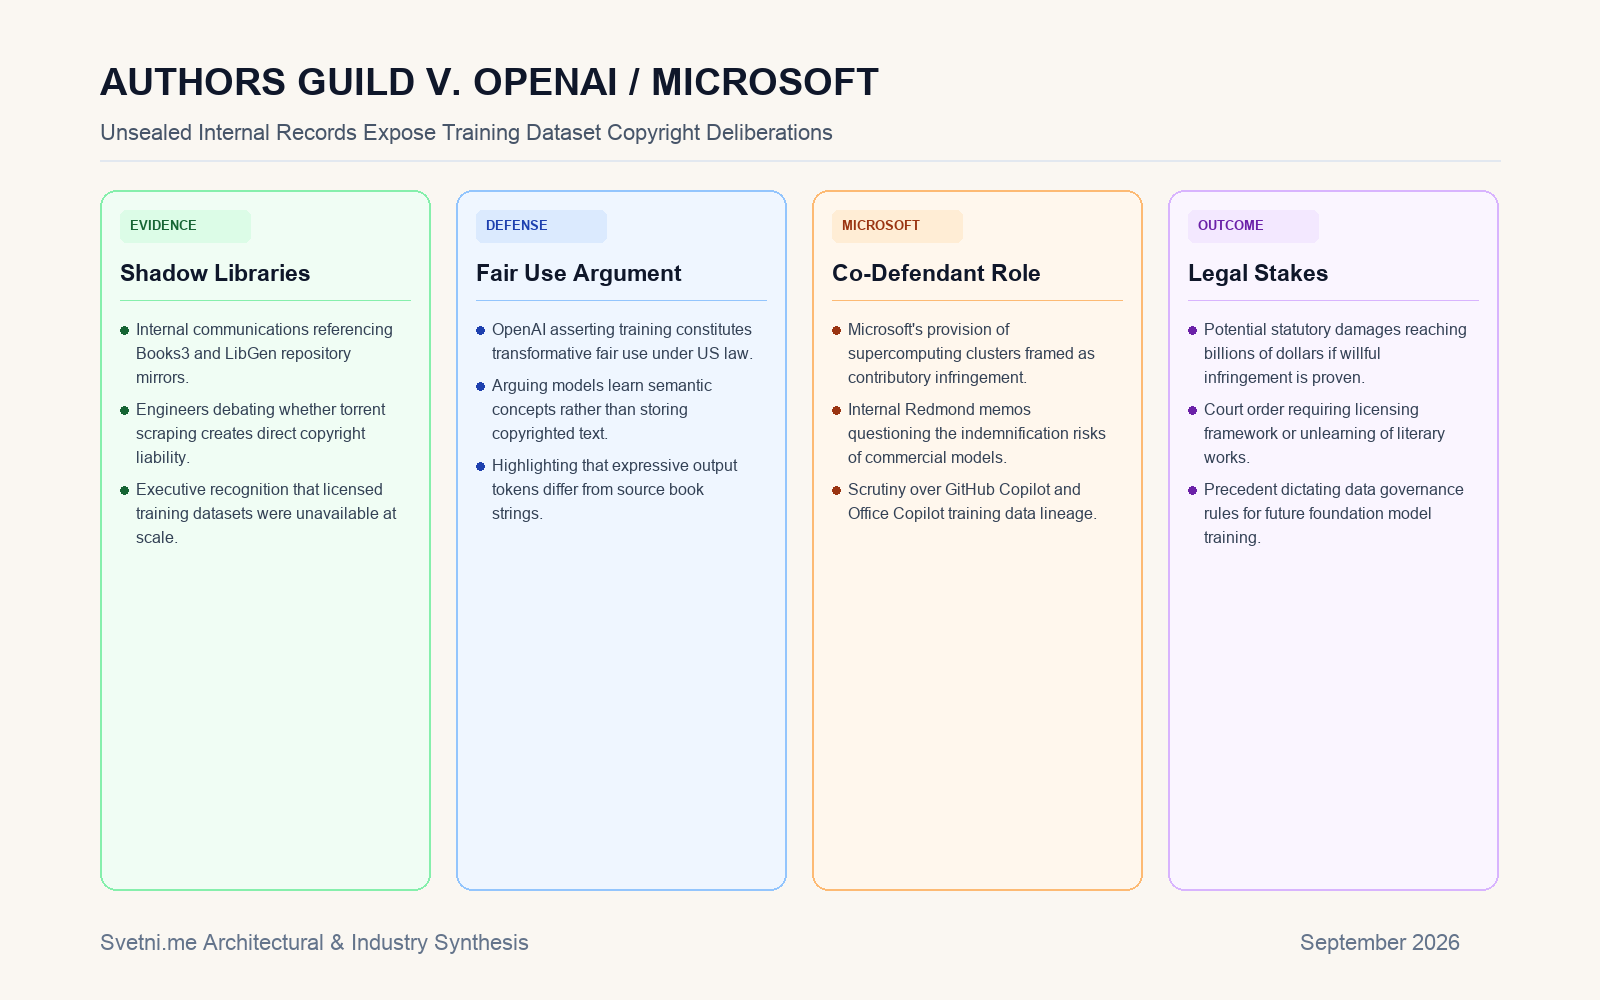
Инфографика: Анализ на Svetni.me
Източници
[1]: Unsealed Briefs in Authors' Case v. Microsoft/OpenAI - The Authors Guild