Ускоряване на локалния ИИ в llama.cpp: Спекулативно декодиране чрез бързо търсене в контекстния промпт
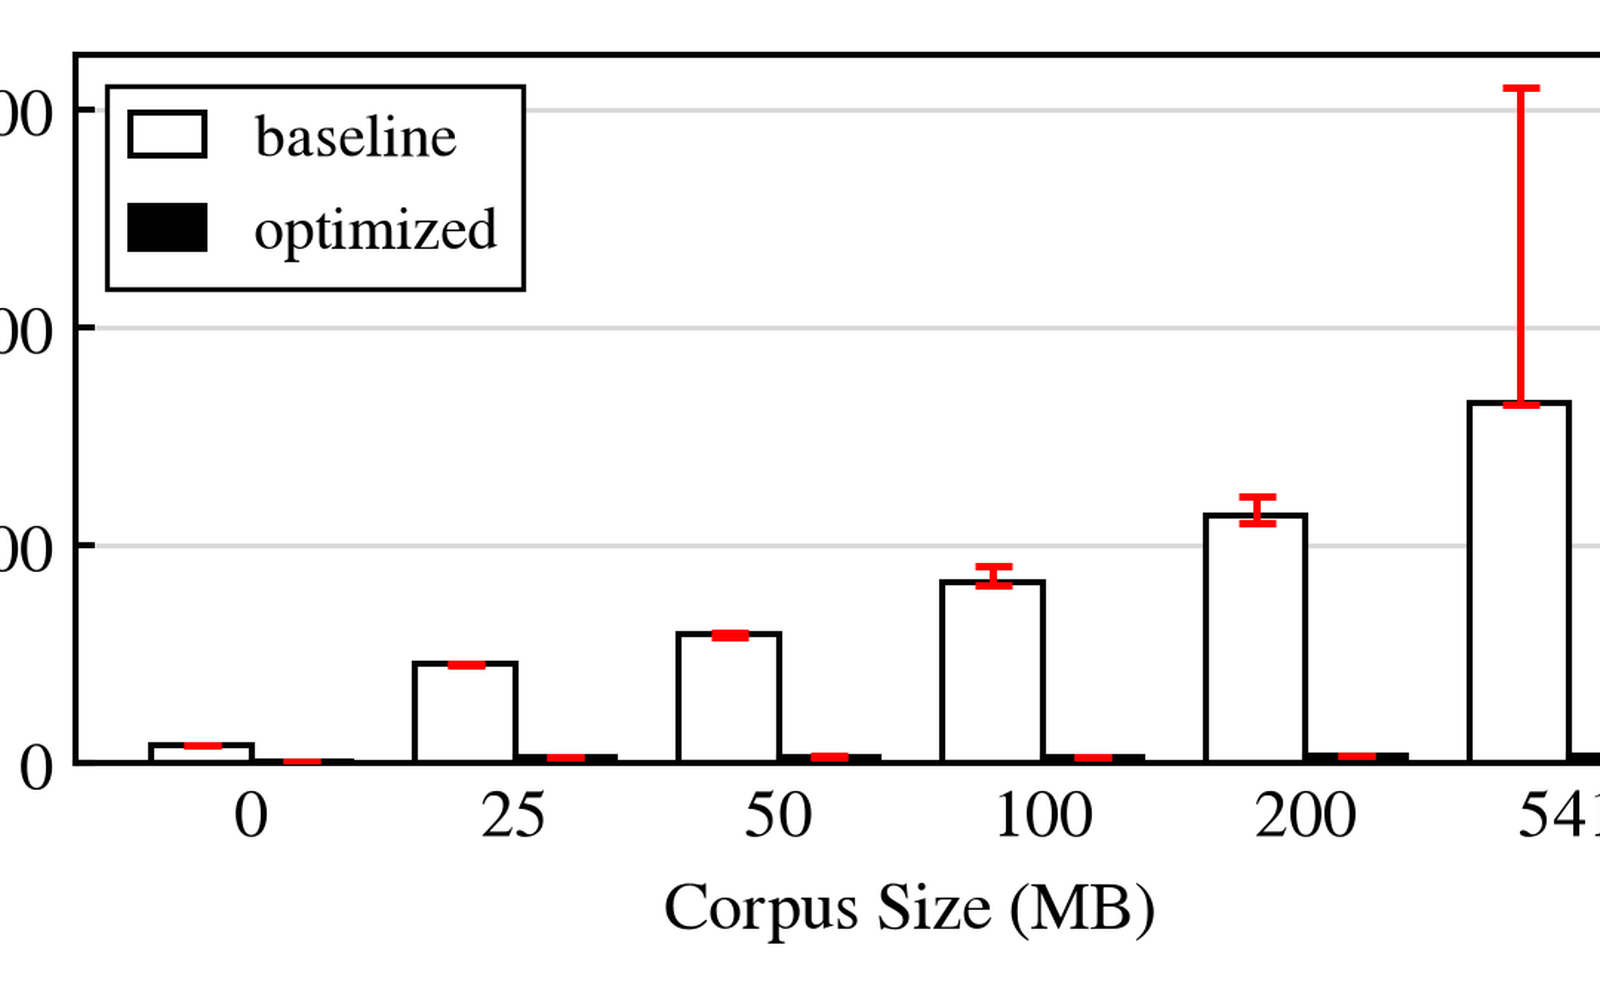
Jadid Bourbaki Engineering Blog
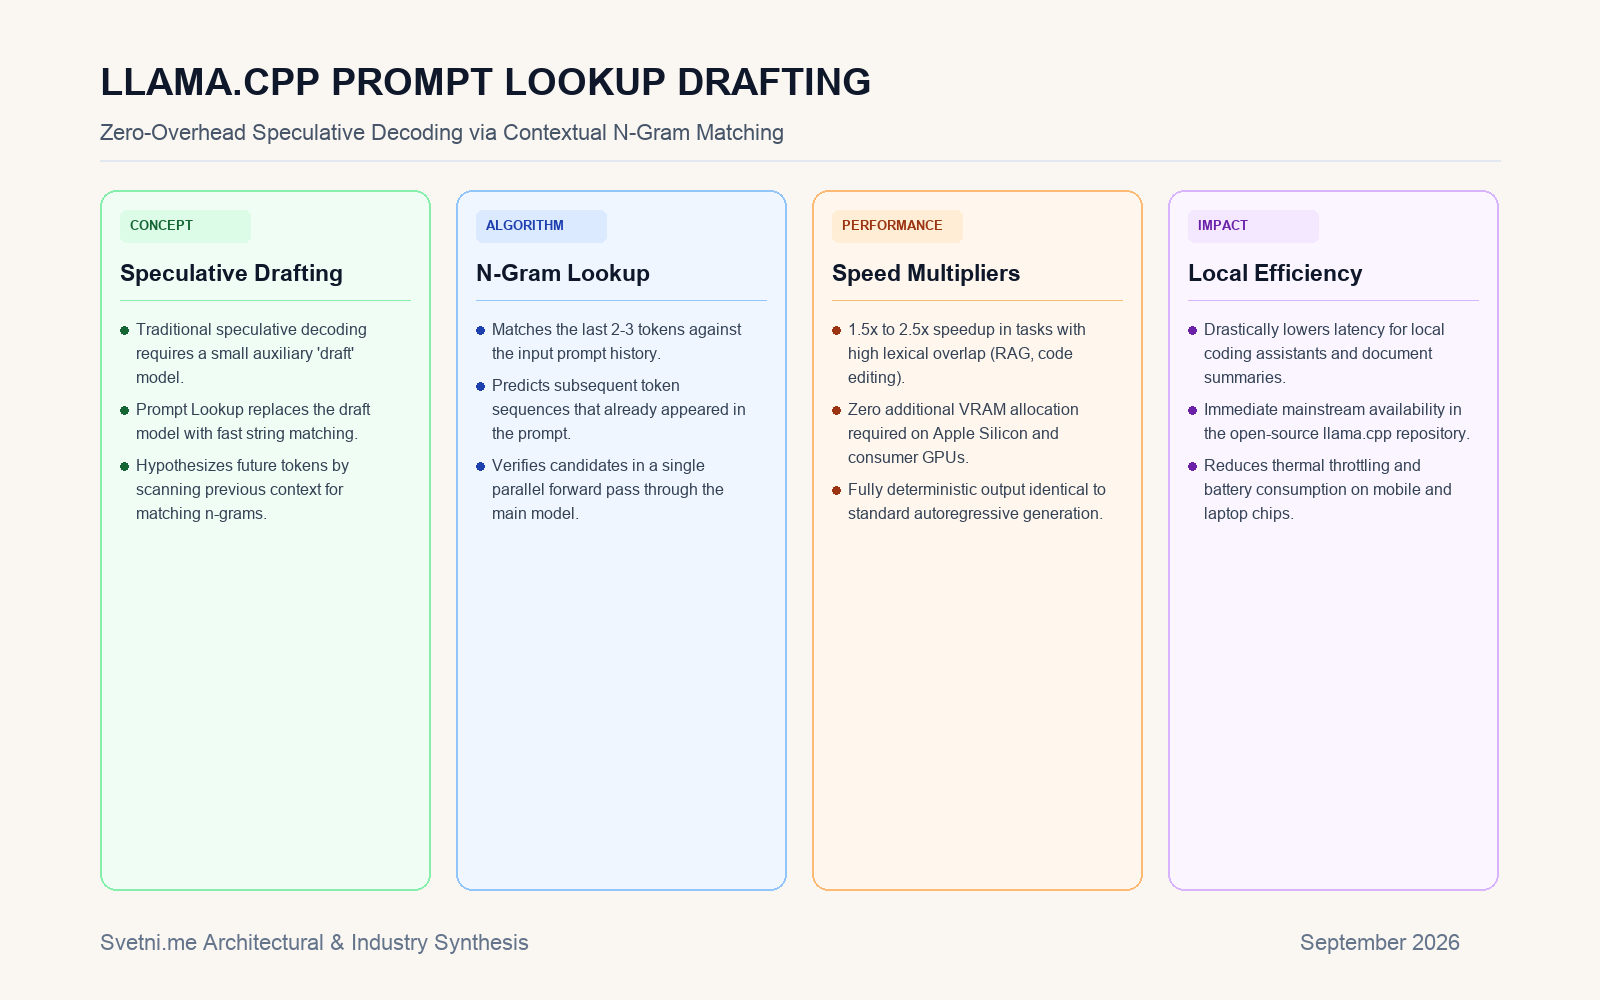
Отворената общност за локално изпълнение на невронни мрежи постигна нов съществен напредък: проектът с отворен код llama.cpp внедри радикално подобрена реализация на алгоритъма Prompt Lookup Drafting [1]. Техниката позволява драстично ускоряване на генерирането на текст при големи езикови модели, без да изисква допълнителна видеопамет [1].
Класическото спекулативно декодиране обикновено изисква зареждането на втори, по-малък помощен модел (Draft Model), който да предлага вероятни токени, проверявани паралелно от основния модел [1]. Това обаче заема ценна памет на потребителските компютри [1].
Как работи търсенето по N-грами в контекста
Вместо да харчи памет за втори модел, Prompt Lookup Drafting се възползва от простия факт, че при много задачи – като пренаписване на софтуерен код, резюмиране на документи или структуриране на JSON – много от думите в отговора вече съществуват в първоначалния входен промпт [1].
Алгоритъмът взема последните 2-3 генерирани токена и светкавично сканира контекста за съвпадащи n-грами [1]. Ако открие съвпадение, той взема следващите токени от текста като чернова и ги изпраща на основния модел за еднократна паралелна верификация [1]. Ако предположението е вярно, моделът генерира до 4-5 токена за времето на една единствена стъпка [1].
Идеално решение за локални асистенти за програмиране
В тестове с рефакториране на софтуерен код и анализ на техническа документация новото решение осигурява между 1.5 и 2.5 пъти по-висока скорост на токени в секунда [1]. Тъй като не изисква промяна в теглата и не влияе на качеството на изхода, оптимизацията вече се превръща в стандарт за разработчиците, работещи с локални модели на Mac и Linux системи [1].
Демократизация на локалния ИИ и дефлационният натиск върху цените на облачните токени
Интеграцията на оптимизираното спекулативно търсене в проекта с отворен код llama.cpp има сериозни икономически измерения, надхвърлящи чистата производителност на алгоритмите за машинно обучение [1]. Постигането на скорости над 50 токена в секунда за модерни модели върху стандартни потребителски компютри практически елиминира необходимостта от използване на платени облачни API услуги за рутинни задачи по програмиране и документален анализ [1].
Този технологичен напредък оказва мощен дефлационен натиск върху комерсиалните доставчици на инфраструктура [1]. Когато индивидуалният софтуерен инженер или малкият бизнес може да постигне светкавична производителност на локалната си машина при нулев разход за абонамент и абсолютна поверителност на данните, комерсиалният смисъл от плащане на хиляди долари за отдалечен изчислителен капацитет започва бързо да намалява [1].
Инфографика: Анализ на Svetni.me
Източници
[1]: Faster prompt lookup drafting in llama.cpp - Jadid Bourbaki Engineering Blog