Perplexity замени DynamoDB със собствената си база данни CobbleDB: 5 пъти по-ниска латентност и драстично по-малко разходи
InfoQ / Perplexity AI Infrastructure
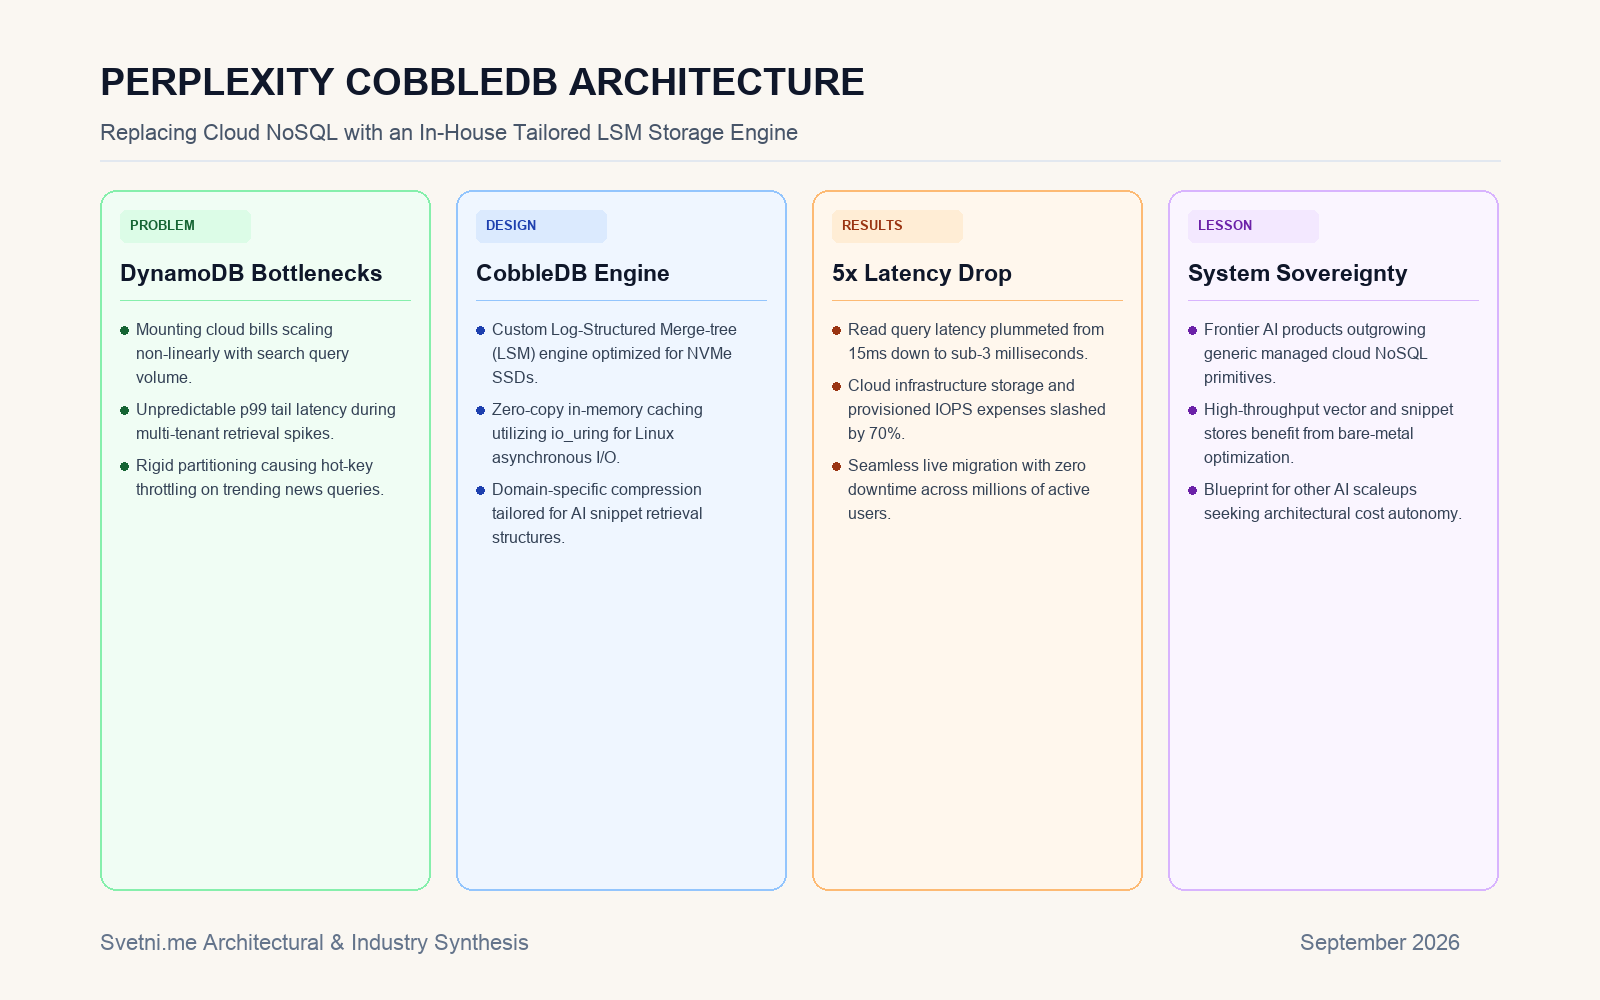
С нарастването на обема на потребителските заявки, ИИ търсачката Perplexity се сблъска с класическия проблем на мащабирането: колосалните разходи и латентността на управляваните облачни услуги в сферата на облачните изчисления [1]. В подробен технически доклад компанията разкри как е заменила Amazon DynamoDB със собствена база данни, наречена CobbleDB [1].
Резултатът от вътрешната разработка е впечатляващ: петкратно съкращаване на времето за четене на данни и над 70% намаление на сметките за съхранение и операции по входно-изходни канали [1].
Анатомия на CobbleDB
За нуждите на своето семантично търсене Perplexity се нуждае от хранилище за бързо извличане на милиони кратки текстови отрязъци (snippets) и метаданни за уеб страници [1]. Докато DynamoDB предлага универсална NoSQL архитектура, CobbleDB е проектирана специфично за високоскоростни NVMe дискове и използва структури тип Log-Structured Merge-tree (LSM) [1].
Чрез интеграция на механизма io_uring в ядрото на Linux за асинхронен дисков достъп и специализирано компресиране на данни, CobbleDB свежда закъснението при четене на 99-ия персентил от 15 милисекунди до под 3 милисекунди [1].
Преодоляване на „горещите ключове“
Друг ключов проблем при DynamoDB беше блокирането на заявки при внезапно популяризиране на конкретна новина (т.нар. hot keys), което водеше до изкуствено ограничаване на трафика [1]. CobbleDB решава този казус чрез агресивно разпределено кеширане в оперативната памет, осигурявайки стабилно време за отговор дори по време на екстремни пикове [1].
Системният ренесанс на специализираните бази данни в ерата на RAG архитектурите
Инженерният пробив на Perplexity с CobbleDB разкрива по-мащабна тектонична промяна в системния софтуерен дизайн: фундаменталната несъвместимост между традиционните облачни хранилища и изискванията на съвременното семантично търсене и генеративното извличане (RAG) [1]. Универсалните бази данни, разработвани за балансирано обслужване на релационни трансакции, се оказват силно неефективни, когато трябва да доставят хиляди контекстни текстови отрязъци с микросекундна предвидимост за паралелно подаване към езиковите модели [1].
Успехът на вътрешния проект показва, че компаниите от първата линия на изкуствения интелект ще бъдат принудени да препроектират цялостната си инфраструктура от нулата – от дисковите структури тип LSM до нискостековите системни повиквания в Linux ядрото [1]. Това подчертава, че устойчивото конкурентно предимство в областта на изкуствения интелект се кове не само в архитектурата на невронните мрежи, но и в дълбоката системна оптимизация на базовите инженерни компоненти [1].
Инфографика: Анализ на Svetni.me