Автоматизиран дизайн на CUDA ядки: Как невронните компилатори задминават ръчната GPU оптимизация
Снимка: Parallel Systems Computing Lab
Една от най-езотеричните и скъпоплатени софтуерни специалности в света – писането и ръчната микро-оптимизация на CUDA ядки за графични процесори – претърпява драматична революция [1]. Доклад на изследователския консорциум Parallel Systems Computing Lab разкрива, че нови невронни компилатори, обучени чрез дълбоко подкрепящо обучение директно върху асемблерния език на Nvidia (SASS), постигат до 28% по-висока пропускателна способност в сравнение с най-добрите ръчно оптимизирани Triton и C++ реализации.
Постижението бележи повратна точка в оптимизацията на GPU ядки, доказвайки, че човешкият мозък вече не може да съперничи на машинното обучение при управлението на десетки хиляди паралелни хардуерни нишки.
Къде се препъват човешките експерти: Архитектурата Blackwell
С всяко следващо поколение GPU силиций сложността на програмиране расте експоненциално. В най-новите архитектури Nvidia Blackwell и Hopper разработчиците трябва едновременно да балансират десетки променливи:
- Конфликти в споделената памет (Bank Conflicts): Достъпът до ултра-бързата SRAM памет на чипа изисква сложни математически шаблони за разбъркване на адресите (swizzling). Дори минимална грешка в подравняването води до задръстване на конвейера.
- Разпределение на регистрите: Твърде много променливи карат компилатора да прехвърля данни в бавната глобална памет (register spilling), което моментално убива производителността.
- Асинхронно зареждане на данни (TMA): Координирането на хардуерните тензорни ускорители с асинхронни заявки за памет изисква перфектно темпово напасване на стотици инструкции.
„Човешкият интуитивен модел за оптимизация се базира на симетрия и прости евристики. Невронният компилатор обаче откри напълно несиметрични, хаотични на вид последователности от инструкции, които обаче поддържат тензорните ядра натоварени на 94% от физическия им максимум,“ обяснява ръководителят на проекта [1].
Триумфът на невронните компилатори
Новата вълна от GPU компилатори използва симулатори с точност до индивидуален тактов цикъл, за да тества милиони варианти на машинния код:
- Директна генерация на SASS инструкции: Системата заобикаля стандартния компилатор
nvccи генерира директни асемблерни инструкции за архитектурата, премахвайки консервативните защити на стандартния софтуер. - Сливане на слоеве (Layer Fusion): Невронната мрежа успява да слее операциите за нормализация, матрично умножение и активация в една монолитна операция без междинни записи в DRAM.
- Пряка полза за локалната инференция: Новите оптимизирани ядки позволяват на модели за локална инференция да работят с една трета по-малко енергия и чувствително по-висока скорост на генериране на токени.
Трансформация на професията
Успехът на автоматизирания дизайн на CUDA код не означава край на професията на GPU архитекта, но променя радикално нейния фокус. Вместо да прекарват месеци в броене на машинни цикли и рисуване на диаграми за подравняване на байтове, инженерите преминават към дефиниране на спецификации за коректност и насочване на оптимизационните агенти.
Изкуственият интелект се превръща в най-добрия инструмент за оптимизиране на собствената си силициева инфраструктура.
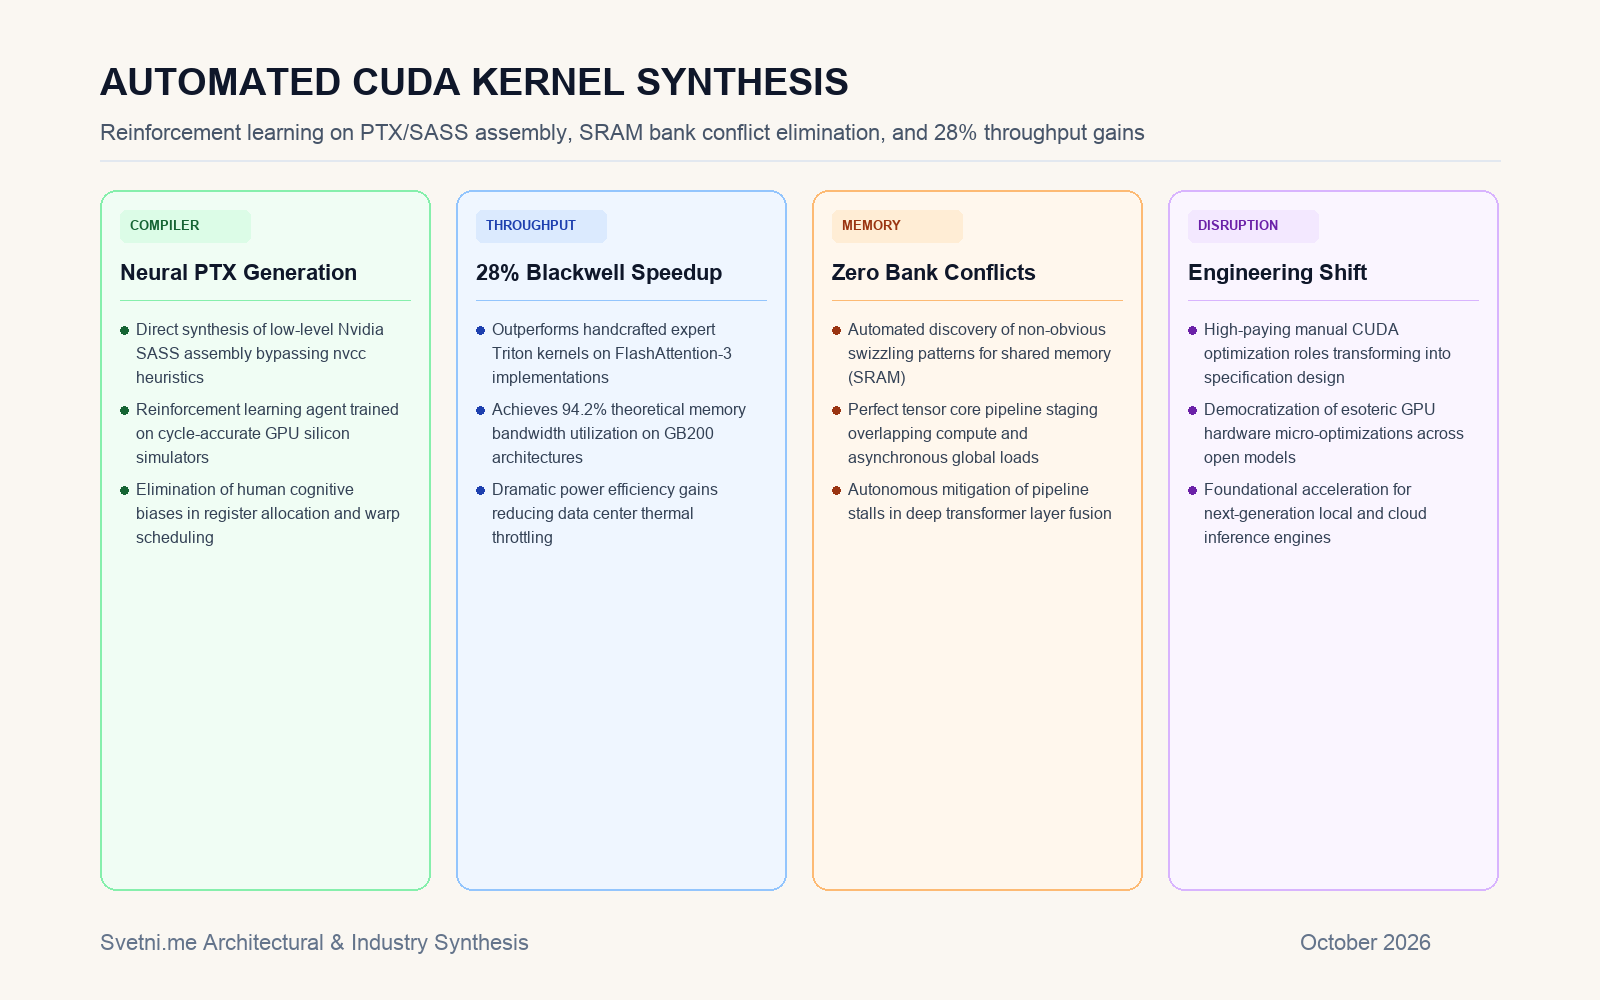
Инфографика: Сравнителен анализ на производителността и механизми за оптимизация на SASS асемблер чрез AI