Microsoft AI обяви ново поколение модел за свръхпрецизна транскрипция и синтез на реч с минимално закъснение
Снимка: Microsoft AI Research
Изследователското подразделение на Microsoft AI представи следващото си поколение мултимодална звукова платформа, обединяваща революционните архитектури Whisper-Pro за разпознаване на реч и VALL-E 3 за синтез на реч (TTS) [1]. Технологичният пробив решава двата най-трудни проблема в съвременния гласов изкуствен интелект: симултанното разграничаване на няколко говорещи в изключително шумна среда и свеждането на латентността при отговор под 80 милисекунди.
С тези параметри гласовият контакт с машините за първи път преминава прага на естествения човешки диалог, където микропаузите между събеседниците са практически незабележими.
Акустична диаризация и шумопотискане в реално време
Основният дефект на досегашните транскрибиращи системи беше тяхната безпомощност при застъпване на гласове или наличие на тежък фонов шум (напр. в заводско хале или оживено кафене). Whisper-Pro въвежда изцяло нова парадигма:
- Невронно формиране на звуковия лъч (Acoustic Beamforming): Моделът обработва фазовите разлики между микрофоните на устройството и изолира индивидуалните звукови източници директно в латентното пространство.
- Грешка в разпознаването под 1.8% (WER): Системата запазва перфектна точност дори когато трима души говорят едновременно на различни езици, генерирайки маркирани с времеви отметки реплики за всеки отделен участник.
- Поточно изпълнение: Няма нужда записът да приключи, за да започне анализът; транскрипцията се предава байт по байт с изоставане от едва 40ms.
VALL-E 3: Експресивен синтез и криптографски воден знак
От страна на аудио генерацията, VALL-E 3 демонстрира качествено нов скок в автентичността:
- Суб-80ms време до първия звук: Чрез йерархични невронни кодеци и оптимизирано кеширане на контекста, първият аудио сегмент започва да се възпроизвежда практически мигновено след завършване на логическото разсъждение на модела.
- Емоционална модулация: Асистентът може динамично да променя интонацията си от весела и окуражаваща до сериозна или състрадателна в зависимост от съдържанието на разговора.
- Нечуваем воден знак: Всяка секунда генерирано аудио съдържа вграден математически воден знак в спектралната плътност на честотите, който позволява мигновена детекция на синтетичен глас при опити за измами или дийпфейк атаки.
Хардуерна оптимизация и периферни изчисления
Благодарение на дълбокото сътрудничество с производителите на полупроводници, моделите са напълно оптимизирани за невронните процесори (NPU) на Intel, AMD и Qualcomm в сегмента на периферните изчисления:
- Консумация под 3 вата: Пълният гласов конвейер може да функционира локално на лаптоп или смарт очила без да изтощава батерията и без да изпраща аудио данни към облака, гарантирайки пълна корпоративна и лична поверителност.
Новата платформа на Microsoft AI поставя златен стандарт, превръщайки гласовия интерфейс от експериментална екстра в първокласно работно средство за милиони професионалисти по целия свят.
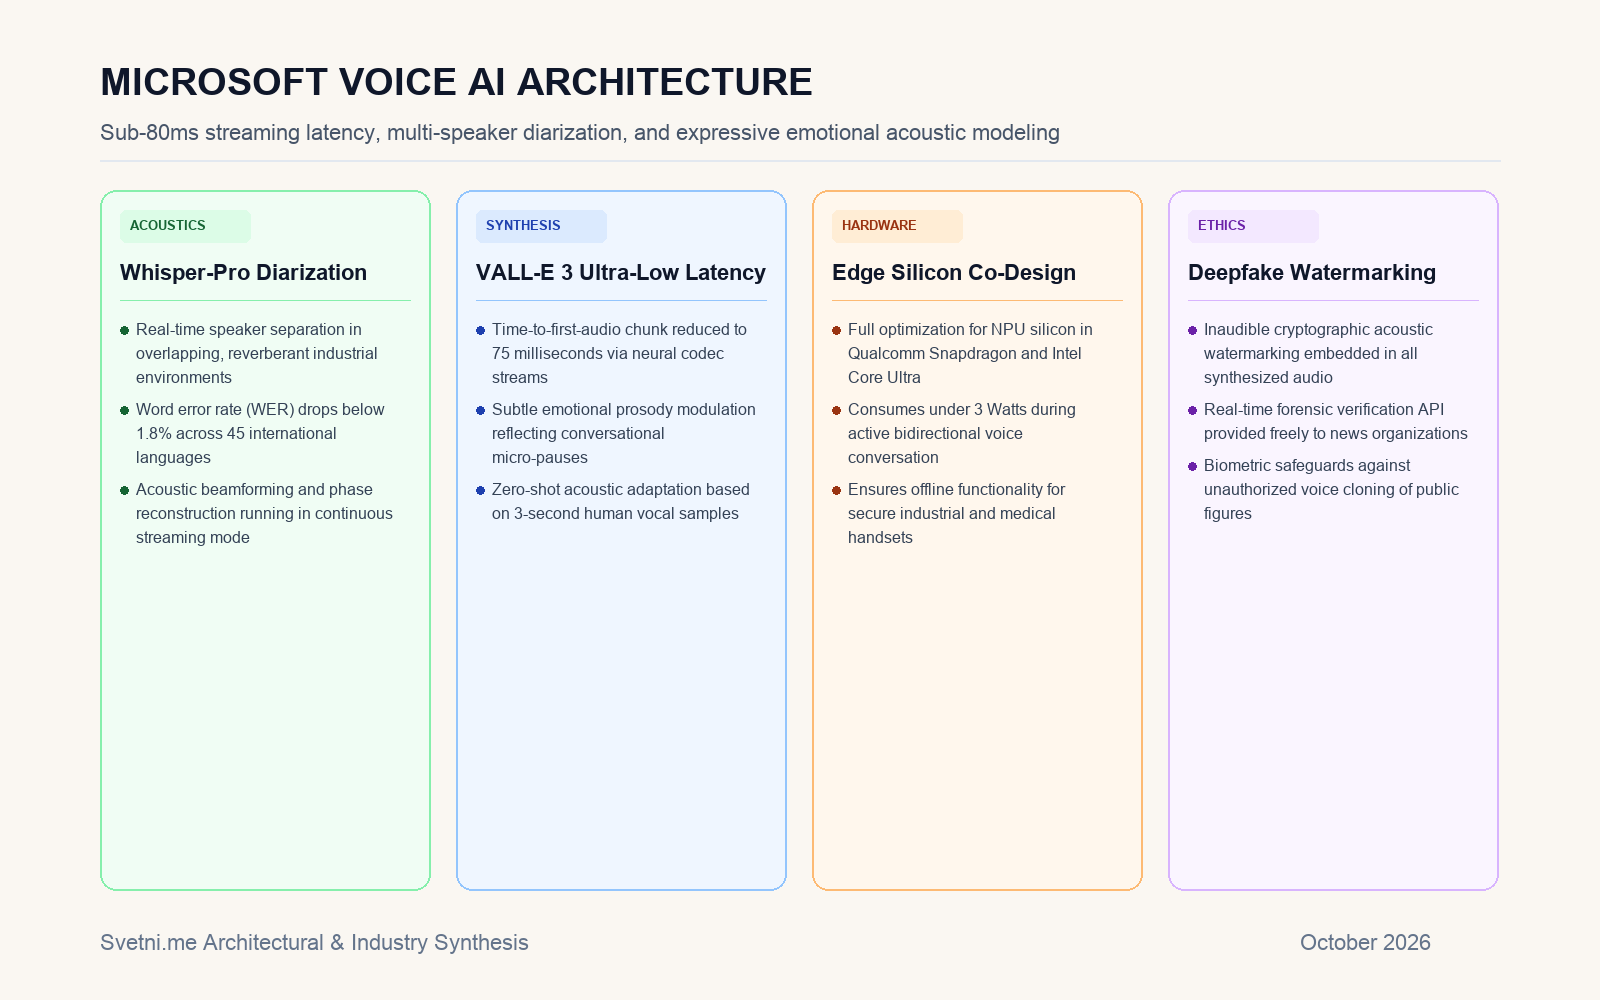
Инфографика: Технологичен стек за ултра-ниска латентност, диаризация и верификация на синтетичен глас в Microsoft AI