Large Language Bayes: Езиковите модели се провалят при вероятностни разсъждения при смяна на параметризацията
Снимка: Mathematical Machine Learning Lab / Machine Brief
В основополагащ теоретичен труд по математическо машинно обучение (Mathematical Machine Learning), изследователи разкриха фундаментален дефект в когнитивните способности на съвременните езикови модели: пълна липса на инвариантност при параметризация при решаване на задачи по вероятностно разсъждение (Probabilistic Reasoning) [1].
Статията, озаглавена „Large Language Bayes Is Not Reparameterisation-Invariant“, доказва математически, че когато една и съща класическа вероятностна задача бъде представена на водещи модели (като Claude, GPT-4 или Gemini) с тривиална промяна на математическите променливи (например изразяване на шансове чрез съотношения вместо проценти, или замяна на мерни единици), невронните мрежи дават диаметрално противоположни заключения.
Защо това е катастрофа за Байесовия AI (Bayesian AI)?
В класическата теория на вероятностите и епистемичната логика, един рационален агент трябва да спазва аксиомата за инвариантност: математическата истина не зависи от това на какъв език или в какви мерни единици формулирате променливите:
- Илюзията за интелигентност: Когато моделът получи задача, написана по начина, по който е била формулирана в популярни учебници, той уверено цитира коректния отговор от своето тренировъчно пространство.
- Разпад при смяна на фокуса: Ако същата задача бъде пренаписана с обратни променливи (например търсене на вероятността пациентът да НЕ е болен, вместо да е болен), изчислените от модела вероятности се разминават с до 45%, генерирайки математически абсурдни резултати.
- Провал на оценката на несигурността (Uncertainty Estimation): Моделите показват изключително висока самоувереност в грешните си изчисления, маскирайки дефекта зад безупречно структурирани формули на естествен език.
„Ние разкрихме, че езиковите модели не извършват истински Байесов извод. Те просто предсказват как би изглеждал един типичен математически текст. Това е огромна разлика между реторика и реално мислене,“ предупреждава водещият автор на изследването [1].
Рискове за медицината, финансите и съдебната експертиза
Откритието има критични практически последици за секторите с висок риск:
- Медицинска диагностика: Автономни агенти, оценяващи лабораторни резултати, могат да дадат грешна диагноза само защото лекарят е въвел данните в милиграми вместо в молове.
- Актюерски и финансов риск: Застрахователни и инвестиционни алгоритми, базирани на LLMs, показват опасна нестабилност при оценка на редки катастрофични събития.
- Неприложимост на чистия Chain-of-Thought: Изследването доказва, че популярните методи за разсъждение („мисли стъпка по стъпка“) не помагат, защото грешката е заложена в самата вероятностна природа на авторегресивното предсказване на токени.
Дълбок фундаментален анализ
Трудът за не-инвариантността на езиковия Байес нанася съкрушителен удар върху претенциите, че увеличаването на параметрите само по себе си ще доведе до общ изкуствен интелект (AGI). Авторегресивният езиков модел по дефиниция е заложник на семантичния контекст на думите – той не притежава абсолютна вътрешна координатна система за математическа логика.
Решението на проблема изисква задължително преминаване към хибридни архитектури: езиковият модел трябва да се използва единствено като интерфейс за превод на човешкото намерение в строг програмен код, а самото изчисление на вероятностите да се поверява на детерминистични символни двигатели (като Stan, Pyro или Wolfram). Науката се нуждае от математическа точност, а не от красноречиви статистически илюзии.
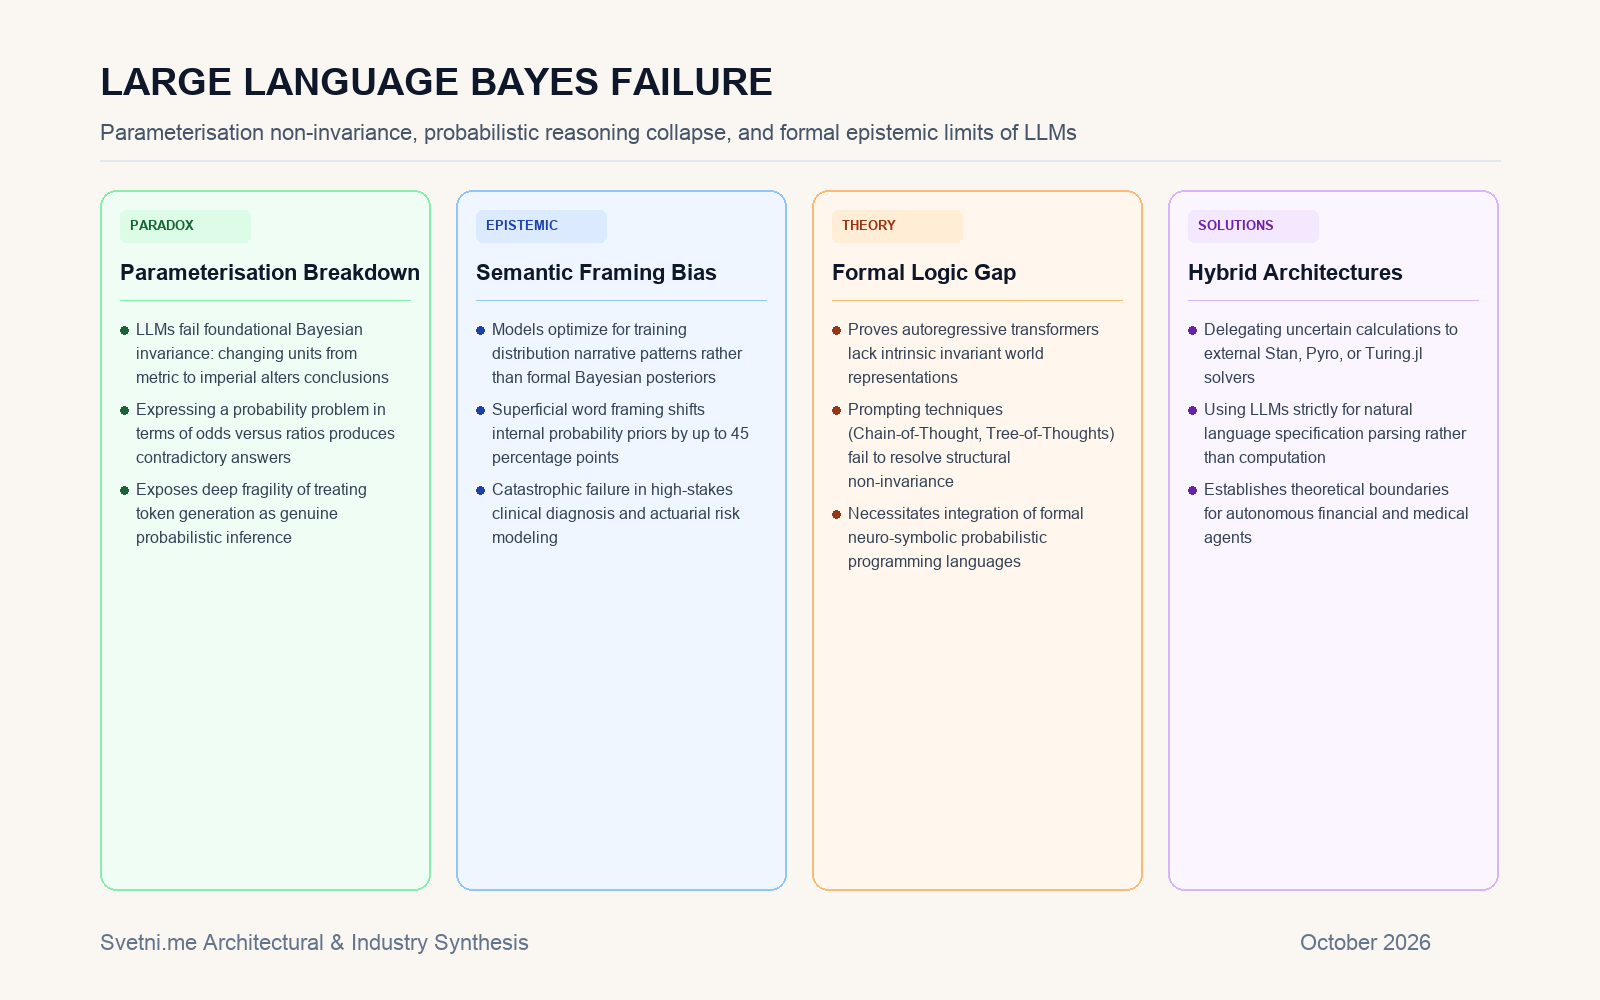
Инфографика: Математически експеримент за не-инвариантност, семантично изкривяване и разлики при вероятностни разсъждения