Как би изглеждал изкуствен интелект със скорост 1 000 000 токена в секунда: Архитектурен анализ
Снимка: Echohive / Machine Brief Archive
В провокативен и дълбоко инженерен анализ технологичният изследователски екип на Echohive публикува цялостно симулационно проучване, отговарящо на въпроса: как би изглеждал светът и каква компютърна архитектура е необходима за постигане на невъобразимата пропускателна способност при инференция (Inference Throughput) от 1 000 000 токена в секунда за един потребител [1]?
Анализът изследва пределите на физиката на полупроводниците, алгоритмите за спекулативно декодиране (Speculative Decoding) и гигантските монолитни пластинни чипове (Wafer-Scale Chips), очертавайки бъдещето на машинното мислене отвъд ограниченията на съвременните графични карти.
Физическите граници: Защо днешните GPU спират на 100 токена в секунда?
Днес най-добрите търговски клъстери обслужват единичен потребител със скорост между 30 и 100 токена в секунда – приблизително скоростта, с която човек чете или говори. Тази бариера се дължи на т.нар. „стена на паметта“ (Memory Wall):
- Ограничение на пропускателната способност: За да генерира един-единствен следващ токен, авторегресивният модел трябва да прочете всичките си милиарди тегла от паметта (HBM). Дори най-мощните чипове на Nvidia са ограничени от физическата скорост на пренос на байтове от DRAM към изчислителните ядра.
- Латентност на мрежата: При разпределяне на модел върху множество сървъри, забавянето от комутацията на пакети през оптични кабели спира паралелния прогрес.
Рецептата за милион токена в секунда
За да се прескочи прагът от $10^6$ токена/сек (което се равнява на генериране на цял том на „Война и мир“ за под една секунда), анализът очертава три фундаментални технологични стълба за скалиране на езикови модели (LLM Scaling):
- Пластинен силиций (Wafer-Scale Integration): Премахване на отделните чипове. Моделът се разполага изцяло върху една гигантска неделима силициева пластина (подобно на архитектурата на Cerebras), където 40 гигабайта свръхбърза SRAM памет комуникират с ядрата със скорост от десетки петабайта в секунда.
- Масирани спекулативни дървета: Йерархия от ултра-бързи малки модели генерира дървовидни хипотези за следващите 64 токена едновременно. Големият модел валидира целия клон в рамките на един-единствен изчислителен такт за хардуерно ускорение.
- Едновременна симулация на паралелни реалности: При скорост от 1 000 000 токена/сек изкуственият интелект спира да бъде чатбот; той се превръща в машина за симулация на милиони алтернативни сценарии чрез метода Монте Карло в реално време.
„При милион токена в секунда концепцията за въпрос и отговор умира. Вие подавате на системата сложен проблем – например проектиране на нов реактивен двигател, и тя генерира, симулира, тества и документира 50 000 алтернативни чертежа преди да сте успели да мигнете,“ се посочва в доклада [1].
Дълбок цивилизационен коментар
Възможността за мислене със скорост милион токена в секунда бележи качествена фазова промяна в историята на разума. За първи път изкуствената система ще може да извърши за един ден когнитивната работа, която на цял изследователски институт отнема десетилетия.
Този скок обаче поставя фундаментален въпрос пред човечеството: ако машината мисли милион пъти по-бързо от нас, човекът неизбежно се превръща в най-бавното, спиращо прогреса тясно място в системата. Бъдещето ще изисква нови интерфейси за директна невронна комуникация, способни да поемат океана от знание, генериран със скоростта на светлината.
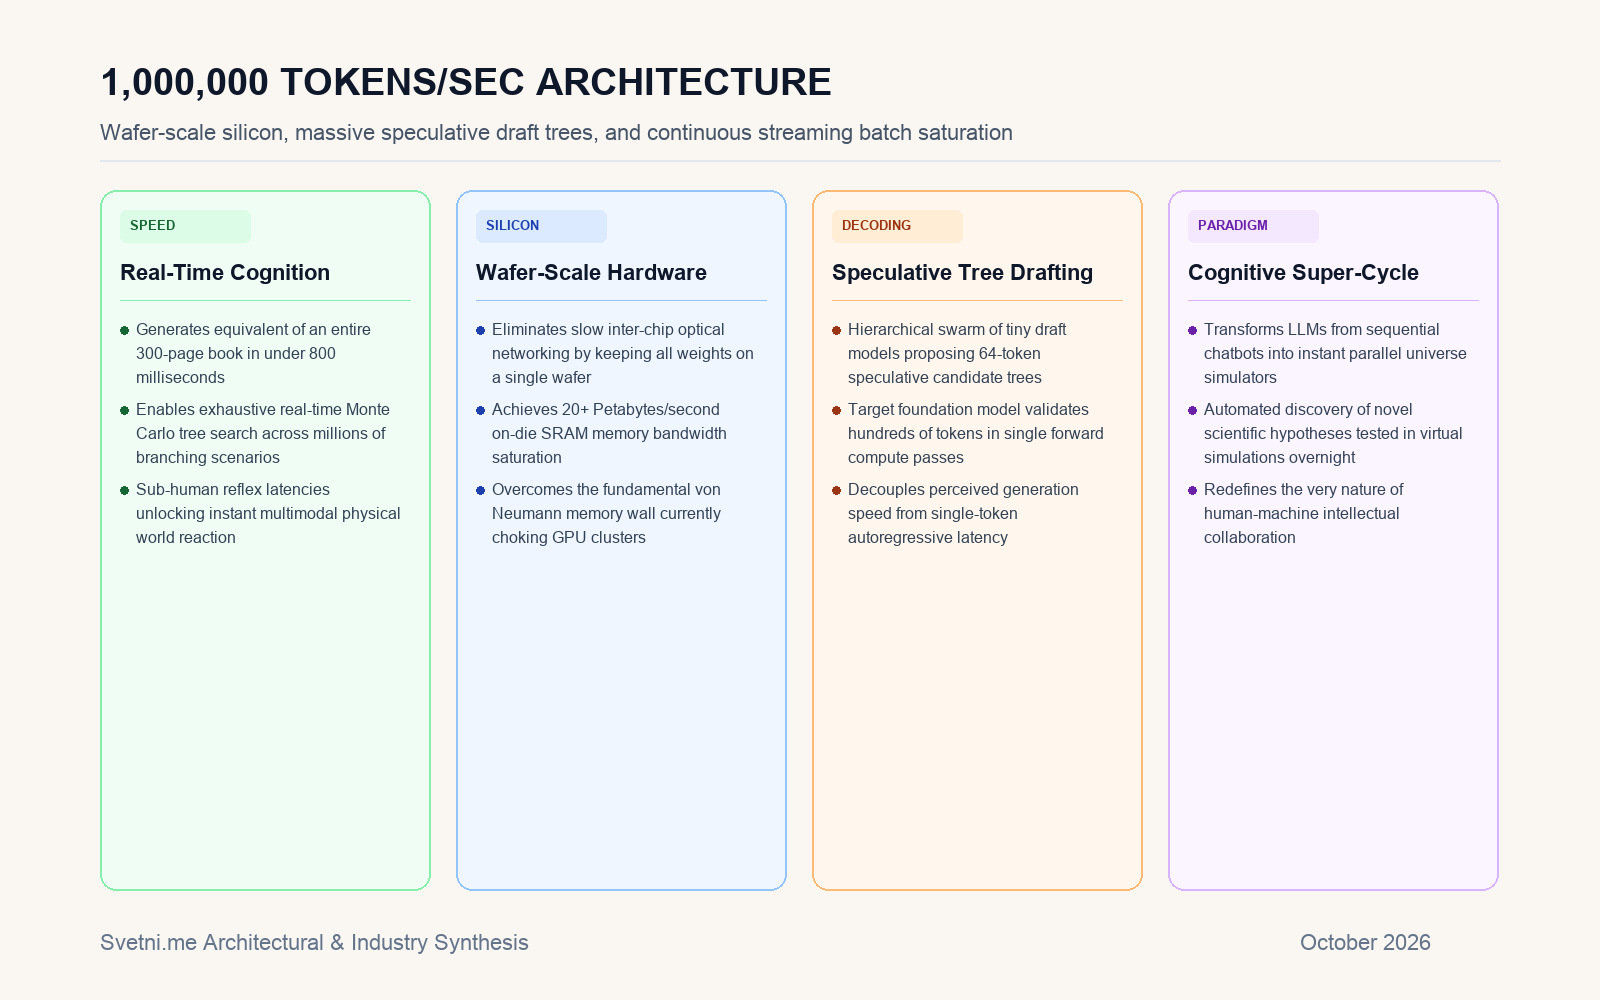
Инфографика: Пластинен силиций, йерархично спекулативно декодиране и паралелна симулация при скорост 1M токена/сек