Защо AI агентите се нуждаят от йерархична документация, а не от векторна памет
Снимка: The Decoder / Systems Architecture
В софтуерната инженерна общност се разгръща ключов архитектурен дебат след публикуването на провокативно техническо есе на софтуерния архитект Кевин Ляо, озаглавено „Агентите нямат нужда от памет, те имат нужда от документация“ [1]. В него авторът прави безпощадна дисекция на манията по внедряване на сложни векторни бази данни за дългосрочна памет на моделите, доказвайки, че те представляват архитектурен анти-шаблон за сериозни задачи.
Според анализа опитите за симулиране на „човешка памет“ при автономните системи чрез извличане на фрагменти по семантично подобие (cosine similarity) често водят до непредвидим хаос, замърсяване на контекста и регресии при програмиране.
Провалът на векторното семантично търсене в сложни кодови бази
В рамките на популярните архитектури от тип генерация с добавено извличане (/pages/rag.html) и векторни хранилища (/pages/vector-databases.html), заявката на потребителя се превръща във вектор, след което базата връща топ 5 или 10 най-близки текстови блока.
Този механизъм страда от три критични дефекта:
- Загуба на времева йерархия: Един стар, отдавна отхвърлен архитектурен дизайн може да има по-висока семантична близост до въпроса от новата актуална инструкция, принуждавайки агента да пише код по остарели правила.
- Липса на системен контекст: Векторният фрагмент изважда 50 реда от файл, лишавайки модела от знанието за модулните зависимости и структурата на директориите.
- Недетерминираност: Минимална промяна в текста на задачата води до извличане на напълно различен набор от фрагменти, правейки поведението на системата нестабилно.
Вместо това Ляо аргументира предимството на строго организираната йерархична документация (/pages/documentation.html) във файловата система.
Триумфът на контекстното инженерство и дървовидните манифести
Решението на проблема се крие в прецизното /pages/context-engineering.html. Когато една кодова база или корпоративна система разполага с добре структурирани файлове с правила (като AGENTS.md или SKILL.md), моделът не разчита на случайни търсения. Той разполага с ясна карта: преглежда съдържанието, открива точния файл със спецификации и прочита само необходимия раздел.
Този подход превръща софтуерния агент в прецизен детерминиран изпълнител, който може да бъде контролиран през стандартната система за контрол на версиите Git. Ако дадено правило бъде променено, агентът автоматично възприема новата инструкция в следващия комит.
Дългосрочни системни и архитектурни последици
Критичният анализ на Кевин Ляо ознаменува прехода на индустрията от „магическо мислене“ към класически софтуерен реализъм в областта на цялостната /pages/agent-architecture.html. В първите години на генеративния AI стартъпите се опитваха да решат всеки проблем с още невронни слоеве, още ембединги и по-големи векторни индекси, надявайки се вероятностната статистика да замести инженерната дисциплина.
Реалността в корпоративните ИТ отдели доказа точно обратното: колкото по-мощен е един модел, толкова по-критично е той да стъпва върху ясни, логически неопровержими и йерархично структурирани текстови документи. В близко бъдеще векторните бази данни ще запазят ролята си на помощен инструмент за първоначално търсене сред неструктурирани масиви от данни, но гръбнакът на агентната автоматизация ще се гради върху прецизно форматирана, версионирана и проверена от човека архитектурна документация.
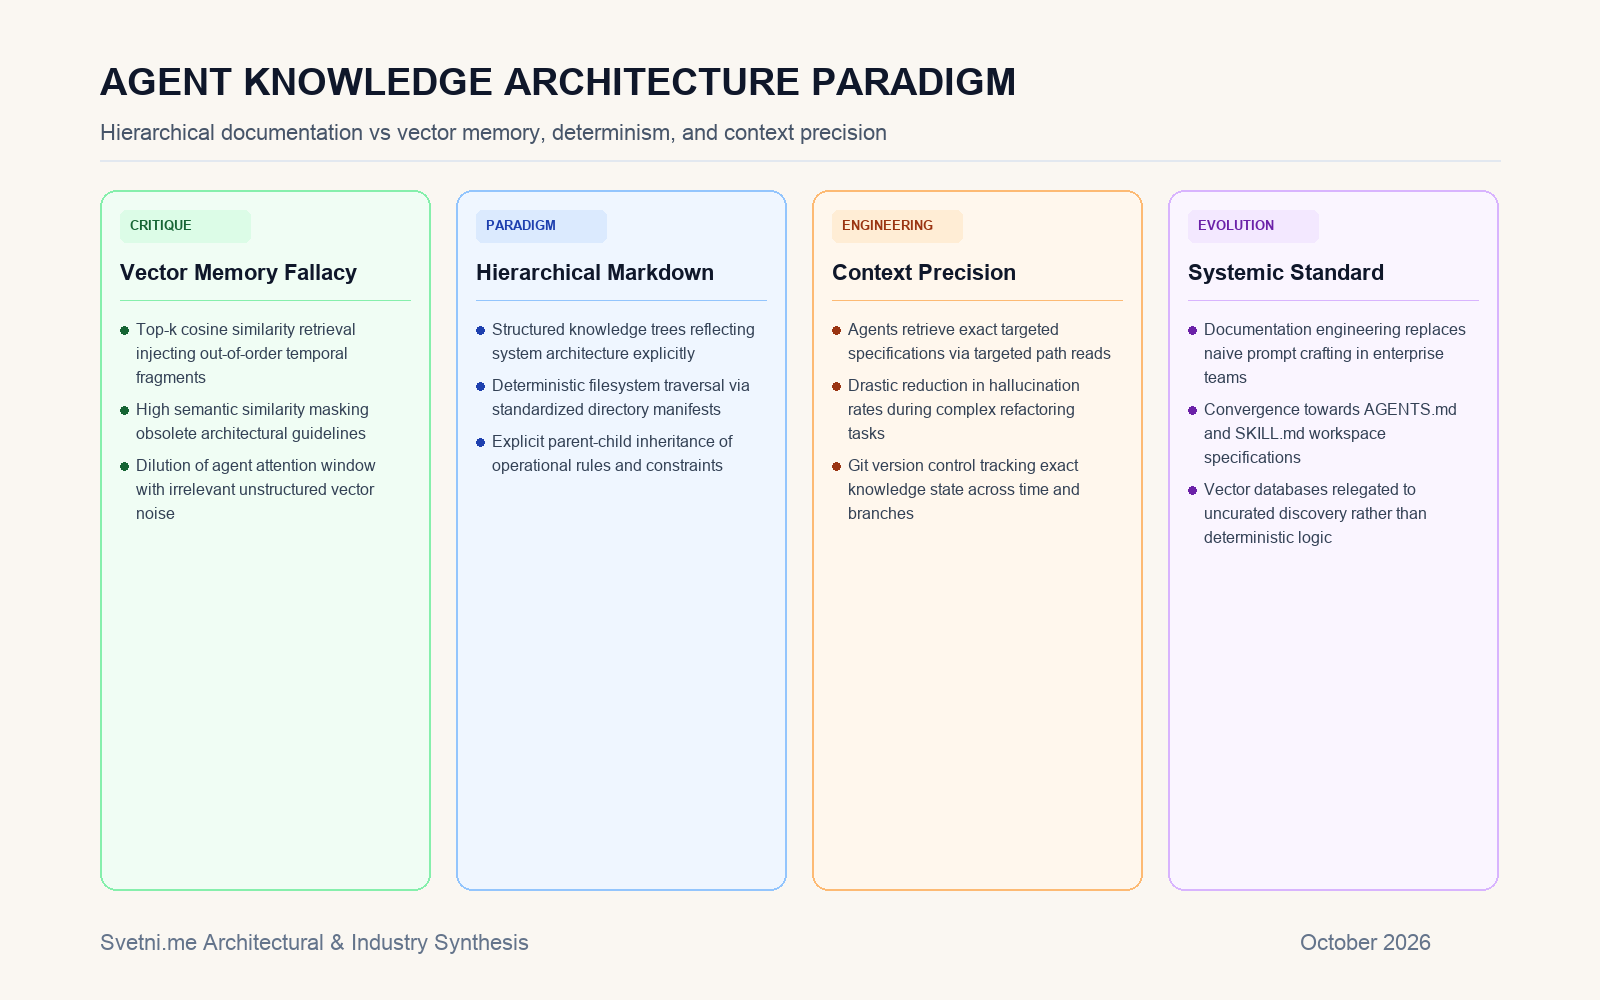
Инфографика: Сравнителен анализ на детерминизма, контекстния шум и контрола на версиите.