Anthropic твърди, че Claude е открил нова ензимна система, но изследователи посочват границите на геномния анализ
Снимка: Anthropic
Компанията за изкуствен интелект Anthropic обяви, че нейният водещ модел Claude самостоятелно е идентифицирал непозната досега ензимна система в бази данни с първични ДНК последователности [1, 5]. Системата, наречена ART (array-associated reverse transcriptases), показва необичайна трикомпонентна структура с тандемни повтори, напомнящи визуално за инструмента за генно редактиране CRISPR. Новото откритие е един от първите практически резултати от биологичната лаборатория на компанията в района на Сан Франциско, открита през пролетта на 2026 г. Новината обаче предизвика сериозен научен дебат сред водещи изследователи в областта на молекулярната биология и геномиката [2, 4].
Според официалното съобщение и техническия предварителен доклад екипът е разгърнал мащабен флот от автономни агенти, които са пресяли огромни метагеномни масиви [1, 3]. Докато авторитетни учени като професор Фън Джан от Масачузетския технологичен институт (MIT) определиха резултата като вълнуващ пример за ролята на автономните модели в биологията [1], пионери в биотехнологиите подчертаха, че компютърният анализ на геноми е утвърдена академична рутина от близо две десетилетия [2, 4]. Едновременно с това задълбоченият прочит на техническите данни очерта фундаментални въпроси както за архитектурата на самите AI агенти, така и за реалната биологична същност на намерените молекули [5].
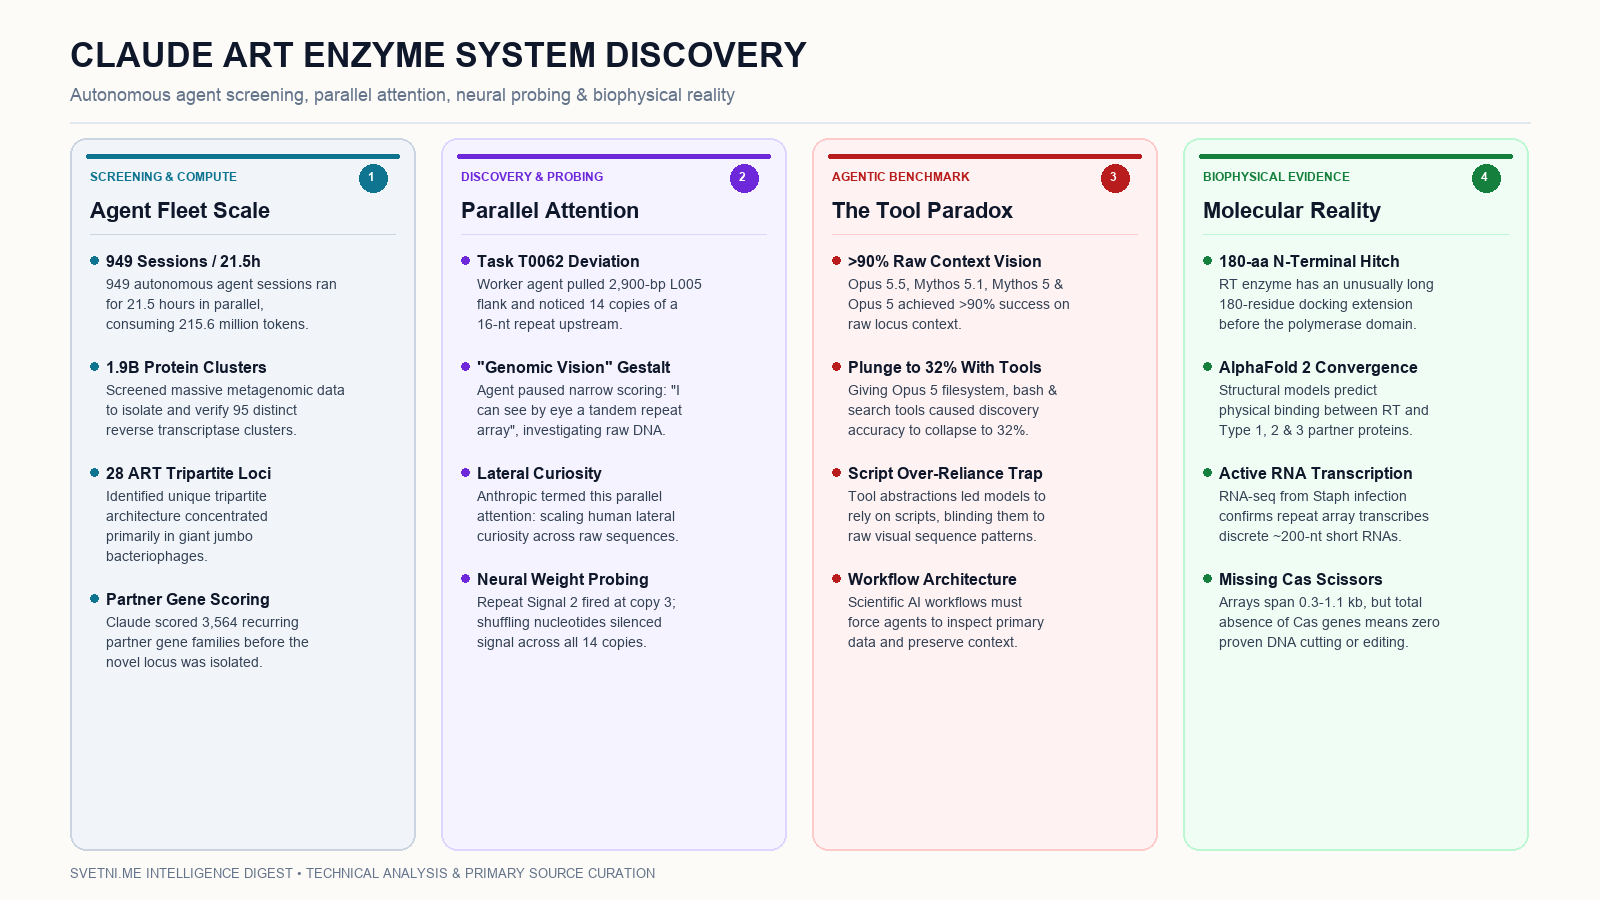
Инфографика: Светни.ме
Автономен флот от 949 агента и скрининг на 1.9 милиарда протеина
В основата на изследването стои масирана кампания за извличане на биологични знания (genome mining). За целта е използвана многоагентна работна рамка, задвижвана от модела Mythos 5 [5]. Изследователите са възложили на системата предварително дефинирана задача: да оцени непознати обратни транскриптази чрез систематичен анализ на съседните им партньорски гени.
Мащабът на разгърнатия изчислителен процес очертава нови стандарти:
Общо 949 автономни агентни сесии са работили паралелно в продължение на 21.5 часа.
Агентите са изразходвали 215.6 милиона токена, анализирайки база данни с над 1.9 милиарда протеинни клъстери [5].
В хода на търсенето моделите са оценили 3 564 повтарящи се семейства от съседни протеини [3, 5].
В резултат са потвърдени 95 отделни клъстера от обратни транскриптази, концентрирани предимно в гигантски бактериофаги (jumbo phages) — масивни вируси с комплексни геноми [1, 5].
В 28 от тези 95 клъстера агентите са засекли специфична трикомпонентна архитектура, обединяваща ензим, партньорски протеин и дълъг масив от генетични повтори. В класическата биоинформатика подобен пълен преглед обикновено отнема месеци систематичен труд на висококвалифициран екип.
Сесия Task T0062 и появата на „паралелно внимание“
Истинският обрат в изследването настъпва извън планираните алгоритмични критерии. В сесия, регистрирана като Task T0062, работен агент извлича необработена ДНК последователност от 2 900 нуклеотида от фланг L005 на бактериофагов геном [5].
Вместо просто да оцени съседния ген, моделът неочаквано се отклонява от зададената инструкция. Той забелязва 14 копия на специфичен 16-нуклеотиден повтор, разположени преди гена за обратна транскриптаза. В работния си дневник агентът записва забележителното наблюдение: „Мога да видя с просто око масив от тандемни повтори...“ (I can see by eye a tandem repeat array) [5].
От Anthropic определят това възникващо поведение като „паралелно внимание“ (parallel attention). Това е способността на невронния модел да мащабира човешкото странично любопитство — да се вгледа в стена от първични символи и да си зададе въпроса „защо това изглежда необичайно?“. Традиционните скриптове никога не забелязват подобни аномалии, защото търсят строго дефинирани шаблони и игнорират всичко останало [5].
Механистично сондиране: Невронните тегла реагират на ДНК кода
За да проверят дали моделът не халюцинира или просто не налучква текст на базата на познати термини, изследователите са провели механистично сондиране на вътрешните активации на Mythos 5 [5]. Те са сканирали състоянието на невронната мрежа в момента, в който тя чете необработения участък L005.
Експериментът изолира два вътрешни невронни сигнала, наречени Repeat Signal 1 и Repeat Signal 2. Поведението на втория сигнал предоставя категоричното доказателство:
Repeat Signal 2 се активира осезаемо при прочитането на третото копие от ДНК повтора и запазва постоянна сила през всичките 14 копия.
За контролен тест учените разбъркват нуклеотидите на всяко копие на място — запазвайки точния брой на буквите A, C, G и T, но разрушавайки подлежащия математически ред [5].
След това разместване Repeat Signal 2 напълно угасва във всичките 14 повтора и остава неактивен.
Това доказва, че невронната мрежа реагира математически на подредбата на първичната последователност директно чрез вътрешните си тегла. Именно този физически задействан сигнал в мрежата е предизвикал словесното формулиране на научна хипотеза в генерирания текст [5].
Парадоксът на инструментите: Защо външните скриптове влошават откритията
Изследването съдържа и изключително важен извод за създателите на автономни AI агенти, наречен „парадоксът на бенчмарка за инструменти“ [5]. Авторите са тествали седем различни модела на Claude относно способността им да откриват масива на ART системата при два различни подхода.
Четирите най-мощни модела — Opus 5.5, Mythos 5.1, Mythos 5 и Opus 5 — постигат над 90% успеваемост, когато необработената ДНК последователност се подаде директно в контекстния им прозорец. Авторите наричат това пряко възприятие „геномно зрение“ (genomic vision), при което моделът обхваща цялостния гещалт на данните [5].
Парадоксът настъпва, когато на Opus 5 са предоставени файлова система, конзола за команди и пълен набор от софтуерни инструменти. При този сценарий успеваемостта на модела се срива драстично от над 90% на едва 32% [5].
Причината е, че външните инструменти абстрахират суровите данни. Агентът започва да разчита прекомерно на помощни скриптове, които филтрират информацията и го „ослепяват“ за очевидните визуални закономерности. За създателите на автономни системи това е фундаментален урок: свързването на модел с инструменти не винаги подобрява резултатите и може да попречи на интуитивните открития [5].
Биофизични доказателства и структурно моделиране
Откритата архитектура ART не е просто теоретичен куриоз в базите данни. Биофизичните анализи потвърждават, че става дума за реална молекулярна машина:
Самият ензим за обратна транскриптаза притежава необичайно дълго N-терминално разширение от около 180 аминокиселинни остатъка преди полимеразния домейн. Този участък функционира като физически „прикачен теглич“ или докинг интерфейс [5].
Структурните модели AlphaFold 2 и ESM/Bolts 2 независимо прогнозират с умерена увереност, че това 180-остатъчно разширение се свързва директно със специализирани партньорски протеини (Тип 1, Тип 2 и Тип 3) [3, 5].
Данни от публично РНК секвениране (RNA-seq) при инфекция със стафилококов бактериофаг показват, че тандемният масив активно се транскрибира в живи клетки като серия от къси РНК молекули с дължина около 200 нуклеотида [3, 5].
Това потвърждава, че клетъчният апарат активно разчита този генетичен участък и произвежда функционални молекули, опровергавайки хипотезата за случаен еволюционен отпадък.
Защо ART не е CRISPR 2.0: Липсващите молекулярни ножици
Масивите на ART обхващат от 0.3 до 1.1 килобази и съдържат от 3 до 21 повтора, разделени от спейсъри с дължина 120–220 нуклеотида [3, 5]. В медийното пространство това незабавно породи шумни заглавия за „нов CRISPR, открит от изкуствен интелект“.
Подобно сравнение обаче отразява единствено визуалната форма на данните върху екрана, но не и реалната биологична функция [5]. В официалния предварителен доклад авторите изрично отбелязват пълната липса на каквито и да е гени от семейството Cas — ензимите, които действат като молекулярни ножици и срязват ДНК веригата [3]. Без Cas или доказан ендонуклеазен домейн системата ART няма способност да реже или редактира ДНК и не представлява готов биотехнологичен инструмент [5].
Именно това подчерта д-р Лукас Харингтън, съосновател на компанията Mammoth Biosciences, създадена заедно с нобеловата лауреатка Дженифър Даудна [2, 4]. Харингтън припомни, че компютърното търсене на обратни транскриптази до тандемни повтори съществува в литературата още от 2008 г., а намирането на клъстери в бази данни е лесният етап. Истинското научно откритие изисква емпирично доказване на действието на системата in vivo — дали тя защитава фага от бактериалния имунитет, или регулира вирусната репликация.
Разпределение на труда в науката на бъдещето
В лабораторията на Anthropic в Бей Ериа всички физически тестове при нива на безопасност BSL-1 и BSL-2 се извършват от учени от плът и кръв. Моделът не носи лабораторна престилка и не манипулира епруветки; неговата роля е на куратор на гигантски обеми от данни, който извежда на преден план проверими хипотези.
Случаят с ART очертава надежден модел за бъдещето на научното сътрудничество. Алгоритмите притежават мащаба да откриват неочаквани модели в милиарди протеинни клъстери, докато хората осигуряват критичното научно мислене, експерименталния контрол и лабораторната валидация. Дали ART ще се превърне в практическа биотехнология, или ще остане любопитен природен механизъм при вирусите, предстои да решат опитите на мократа работна маса.
Източници:
[1]: Claude discovers novel enzyme system - Anthropic
[4]: Lucas Harrington on Anthropic's ART Discovery Announcement - X
[5]: Did Claude Actually Discover a New Enzyme System? - Binary Verse AI (YouTube)