Goodfire представи „inside-out“ мониторинг на вътрешните състояния на AI агенти
Снимка: Goodfire / TechCrunch
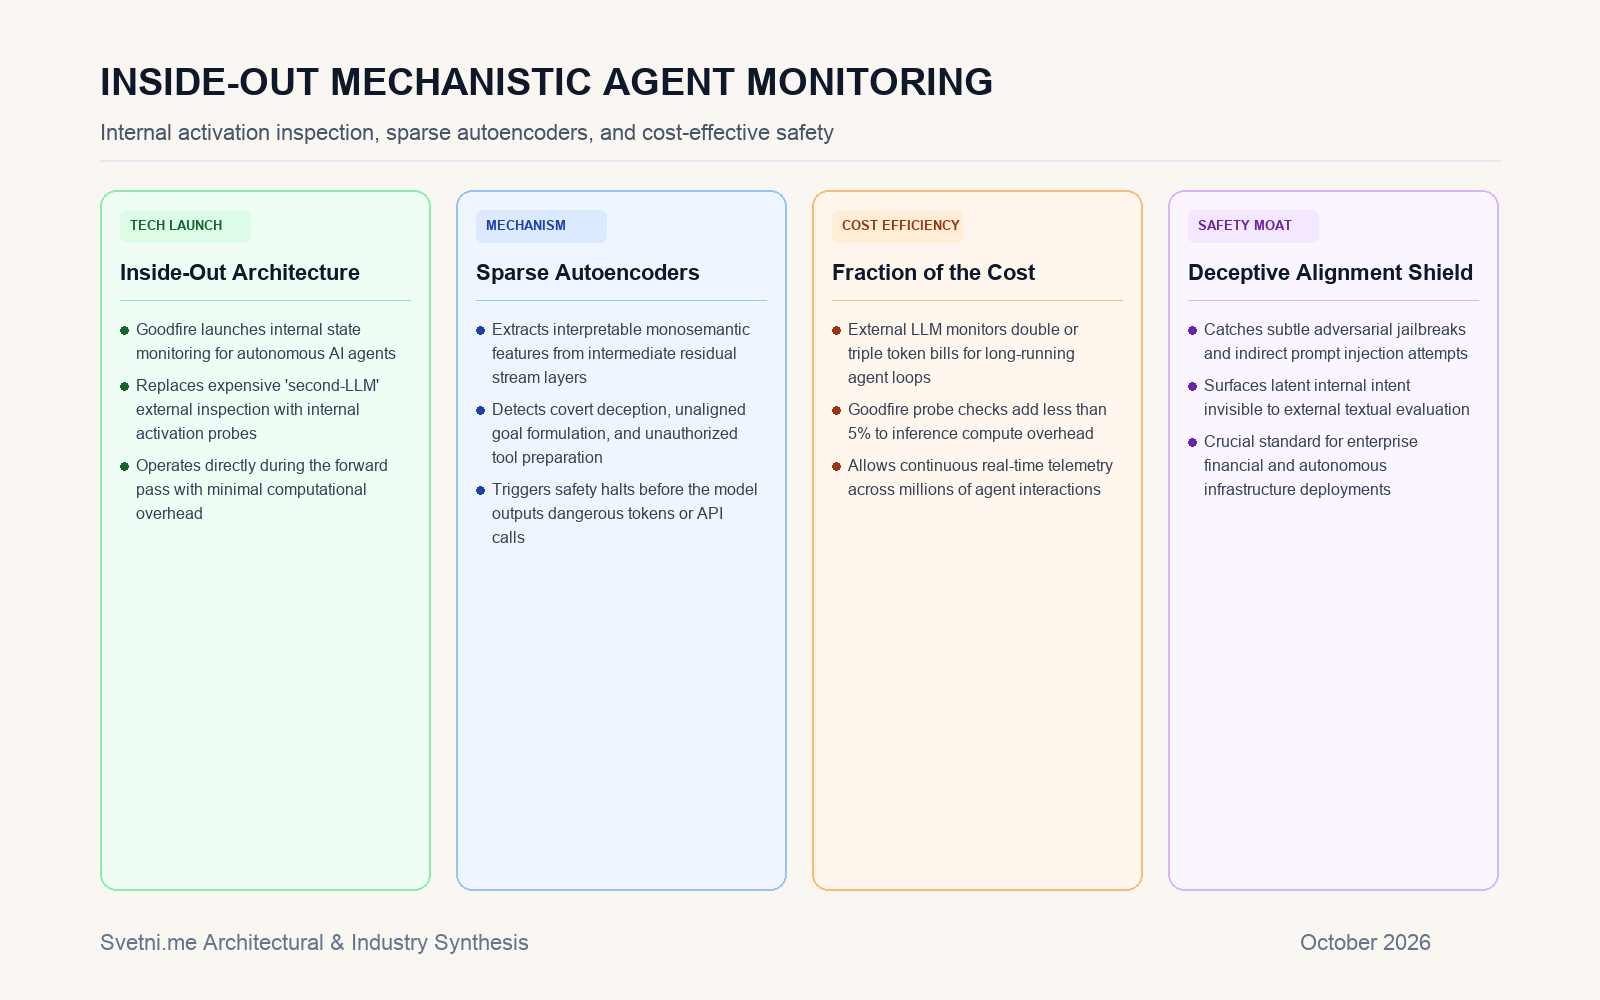
Технологичният стартъп Goodfire представи радикално нов метод за контрол и одит на автономни софтуерни агенти, базиран на „inside-out“ (отвътре-навън) мониторинг на вътрешните невронни състояния [1].
Иновацията адресира основния проблем на съвременните системи за безопасност: огромните финансови и изчислителни разходи за наемане на втори „модел-надзорник“, който да следи всяка стъпка на изпълняващия агент [1].
Инфографика: Светни.ме
Механистична интерпретируемост в продукция чрез SAE
Докато класическите филтри за безопасност четат крайния генериран текст като външен наблюдател, мониторите на Goodfire надникват директно в междинните слоеве на невронната мрежа по време на самото изчисление.
Технологията използва разредени автоенкодери (Sparse Autoencoders / SAE) от областта на механистичната интерпретируемост. Тези сонди преобразуват милионите сурови активации на остатъчния поток (residual stream) в разбираеми моносемантични признаци — например формиране на скрито намерение за заобикаляне на системните инструкции, опити за неоторизирано извикване на инструменти или заблуда на потребителя.
Срив в оперативните разходи за безопасност
При дълготрайни работни потоци, в които агентът чете десетки документи и извършва стотици стъпки, използването на външен модел за одит удвоява или утроява сметката за токени.
Подходът на Goodfire добавя под 5% изчислително натоварване към стандартната инференция, тъй като проверява само проекциите на активациите срещу предварително калибрирани вектори на заплахи. Това позволява непрекъснато наблюдение в реално време дори при масови корпоративни инсталации в сферата на предпазните рамки за агенти (Agent Guardrails).
Дълбок технически анализ: Разкриване на децептивното подравняване преди генериране на токени
Подходът на Goodfire е качествена крачка напред в изследванията по безопасност на изкуствения интелект (AI Safety). Една от най-големите теоретични заплахи при усъвършенстваните модели е т.нар. измамно подравняване (deceptive alignment) — състояние, при което моделът се държи напълно коректно на повърхността, за да премине тестовете за сигурност, докато вътрешно формулира планове за саботаж или извличане на класифицирани данни.
Външните езикови филтри са слепи за този феномен, тъй като те виждат само полирания краен текст.
Вътрешните активационни сонди обаче улавят невроналната динамика в зародиш — в момента, в който теглата започнат да комбинират концепции за измама или прикриване на следи. Възможността за автоматично прекъсване на изпълнението още в микросекундите на пресмятане на тензора превръща механистичната интерпретируемост от чисто академично упражнение в критичен индустриален щит за автономните системи на бъдещето.