Samsung Labs постигна компресиране на LLM под 1 бит на параметър чрез латентна факторизация
Снимка: Samsung Advanced Institute of Technology (SAIT) / GitHub
Изследователите от научното подразделение Samsung Labs (SAIT) публикуваха официалната реализация на проекта LittleBit-2, демонстрирайки радикален пробив в компресирането на големи езикови модели [1].
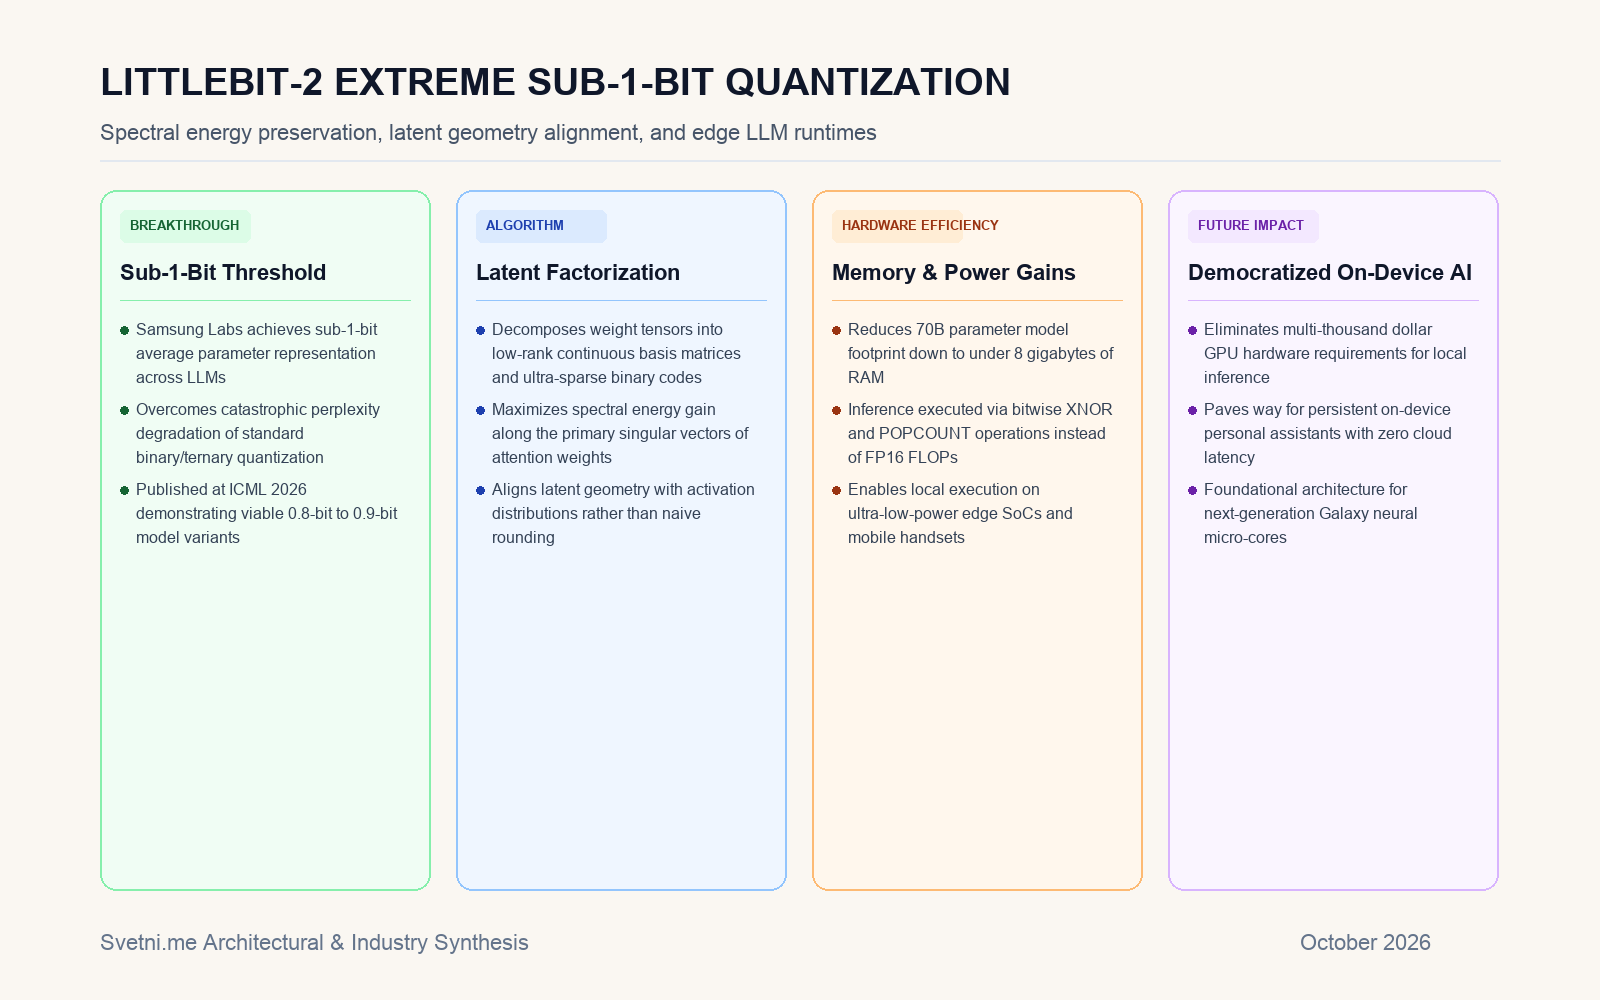
Изследването успява да прекрачи психологическата бариера от 1 бит на параметър, постигайки ефективно средно представяне от едва 0.8 до 0.9 бита без катастрофалната загуба на смислова точност, която досега спъваше бинарните мрежи [1].
Инфографика: Светни.ме
Методът LittleBit-2: Максимизиране на спектралната енергия
Досегашните техники за квантуване разчитаха на закръгляне на теглата към най-близките дискретни стойности (INT8, INT4, FP4). При преминаване под 2 бита обаче тази проста апроксимация водеше до експлозия в перплексията (perplexity) на модела и пълно разпадане на логическото разсъждение.
LittleBit-2 преодолява този лимит чрез латентна факторизация и подравняване на геометричната структура. Методът декомпозира матриците на вниманието на две части: малък непрекъснат базис с висок ранг, който съхранява над 95% от спектралната енергия на сингулярните стойности, и разредена решетка от бинарни битове. По този начин средният отпечатък на параметър пада в диапазона на квантуване под един бит (sub-1-bit).
Революция за периферните устройства (Edge AI)
Практическото следствие от тази математическа декомпозиция е поразително: пълномащабен модел с близо 70 милиарда параметри, който обикновено изисква сървърен клъстер с професионални графични карти на стойност десетки хиляди долари, вече може да се побере в под 8 гигабайта оперативна памет.
Освен това инференцията се ускорява драстично, тъй като скъпите операции с плаваща запетая (FP16 FLOPs) се заменят с битови XNOR и POPCOUNT инструкции, които се изпълняват на хардуерно ниво с минимална енергийна консумация в рамките на съвременните периферни AI системи (Edge AI).
Дълбок технически анализ: Краят на хардуерната стена за персоналните невронни асистенти
Резултатите на Samsung Labs бележат фундаментален прелом в теорията на компресията на невронни мрежи. В продължение на десетилетие общоприетото схващане бе, че капацитетът на един модел е неразривно свързан с броя битове информация, съхранявани в неговите параметри (теорията на Шанън).
LittleBit-2 доказва емпирично, че голяма част от теглата в свръхпараметризираните трансформатори са функционално излишни и представляват шум, породен от стохастичния градиентен спуск. Чрез изолиране на критичните сингулярни посоки в латентното пространство невронният интелект може да бъде кондензиран в суб-битови структури.
Това отваря вратата за интеграция на frontier-клас разсъждаващи агенти директно в потребителски смартфони, смарт очила и вградени медицински импланти. Демократизацията на инференцията ще отнеме зависимостта от скъпите облачни монополи и ще превърне изкуствения интелект в локално физическо право на всеки потребител.
Източници
[1]: Sub-1-Bit LLM Compression via Latent Factorization - Samsung Labs GitHub