Google представи Android Bench 2.0 с оценка на дългосрочни агентни задачи и непрекъснато оценяване
Снимка: Google / InfoQ
Инженерният екип на Google пусна официално Android Bench 2.0 — най-значимото надграждане до момента на своята специализирана среда за тестване на изкуствен интелект в реални мобилни операционни системи [1].
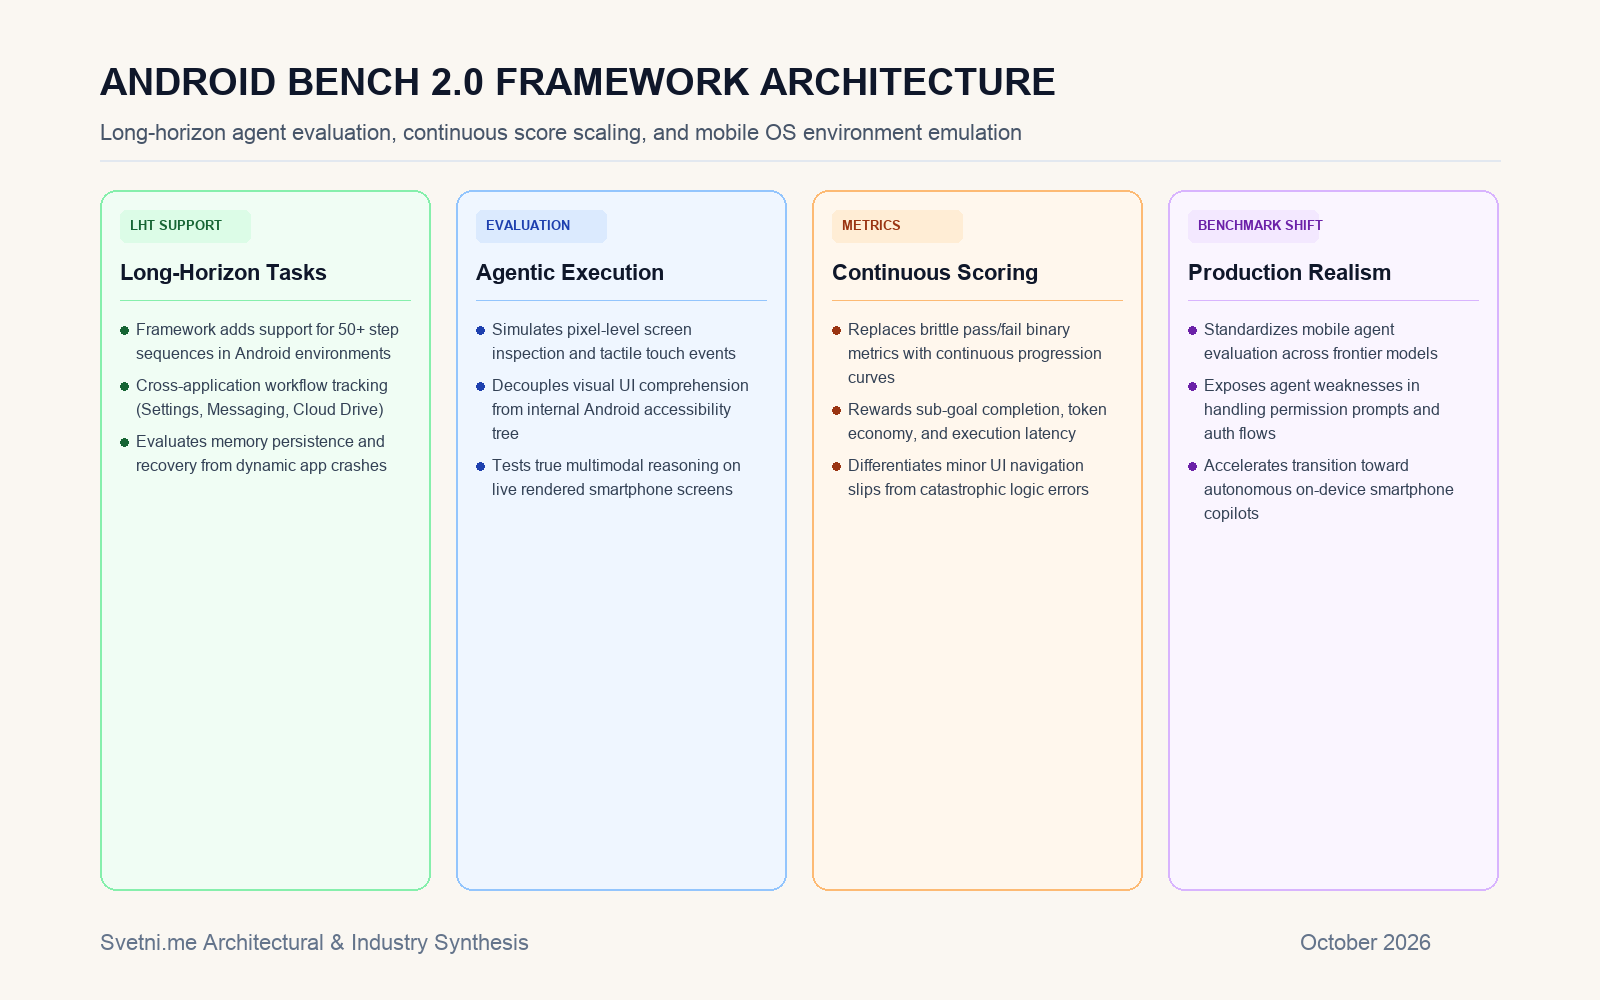
Актуализацията трансформира начина, по който изследователите измерват способностите на мултимодалните мобилни агенти, въвеждайки специализирани протоколи за изпълнение на задачи с продължителен хоризонт (LHTs), интерактивна агентна симулация и непрекъснато оценяване на прогреса [1].
Инфографика: Светни.ме
От статични екрани към динамични софтуерни траектории
Първото поколение бенчмаркове за мобилни интерфейси страдаше от фундаментален недостатък: моделите се тестваха върху статични екранни снимки с предварително зададени текстови въпроси. В реалния свят обаче използването на смартфон е интерактивен процес, включващ забавяния на мрежата, неочаквани системни диалози, изскачащи известия и динамични анимации.
Android Bench 2.0 поставя агентите в истинска виртуализирана среда на Android. Моделите получават суровия визуален поток на екрана и трябва сами да планират поредици от кликвания, плъзгания (swipes), въвеждане на текст и превключване между приложения, за да постигнат зададена сложна цел.
Решаване на дългосрочни задачи (Long-Horizon Tasks)
Най-голямото изпитание за съвременните езикови модели е способността им да поддържат фокус и устойчив план при дългосрочни задачи, състоящи се от десетки междинни стъпки. Рамката включва сценарии като резервиране на билети, извличане на информация от банково приложение, изпращане на потвърждение по имейл и качване на фактура в облака.
Вместо примитивна бинарна оценка (успех или провал), новата метрика за непрекъснато оценяване измерва колко точно от подцелите са били изпълнени успешно и колко токена и време са били изразходвани по пътя, позволявайки фино сравнение между архитектурите.
Дълбок технически анализ: Новият златен стандарт за агентни бенчмаркове
Появата на Android Bench 2.0 маркира зрялостта на съвременните бенчмаркове за AI агенти. Досега компаниите обявяваха впечатляващи резултати върху абстрактни академични тестове, които обаче имаха минимална връзка с реалната способност на модела да управлява компютър или телефон.
Чрез симулиране на автентична софтуерна среда със строги времеви ограничения и проверка на устойчивостта срещу грешки, рамката на Google поставя нови стандарти за индустрията. Моделите, които демонстрират високи резултати в Android Bench 2.0, ще бъдат първите готови за директна интеграция като автономни ежедневни асистенти в джоба на милиарди потребители.