Икономиката на класификацията: Защо Jev AI преосмисля границите между LLM и специализираните модели
Индустриална апаратура за класификация на данни. Снимка: Rob Hoeijmakers Blog
В технологичната индустрия манията по големите езикови модели (LLM) дълго време маскираше един очевиден архитектурен абсурд: компаниите плащат милиони долари месечно на облачни доставчици, за да карат невронни мрежи със стотици милиарди параметри да връщат прост отговор с „да“ или „не“ [1]. В новото си програмно есе нидерландският софтуерен архитект Роб Хьоймакерс разглежда проекта Jev и формулира категорична теза: същинската машинна класификация вече е безплатна, а опитите тя да се реализира чрез общ генеративен чат са инженерна грешка [1].
В основата на парадокса стои подмяната на класификационните задачи с генеративни промптове. Когато даден корпоративен софтуер трябва да определи дали потребителско съобщение представлява спам, дали трансакция е подозрителна или в коя категория попада клиентско запитване, стандартният подход през последните три години бе подаване на промпт към модел като GPT-4 с инструкция: „Върни JSON с полета category и confidence“ [1]. Този подход натоварва инфраструктурата с гигантска токенова инфлация, бавна авторегресия и непрекъснат риск от счупен синтаксис.
Архитектурен разрив: Авторегресия срещу вероятностни глави
Разликата между генеративния модел и специализирания класификатор е фундаментална. Авторегресивният LLM изчислява вероятността за всеки следващ токен последователно във времето. За да изведе думата „ФАКТУРА“, моделът активира всичките си слоеве за всеки символ или сричка, генерирайки десетки матрични умножения в търсене на следващия символ [1].
За разлика от това, специализираните системи като Jev разчитат на класически енкодери с дискретна класификационна глава. Текстът се преобразува в семантичен вектор чрез лек енкодер, след което крайната линейна трансформация незабавно извежда вектор с вероятности за предварително дефинираните класове. Процесът приключва в рамките на 5 до 10 милисекунди, консумира нищожно количество памет и работи отлично на евтини CPU машини без специализирани ускорители [1].
Чрез прецизно фино настройване (finetuning) малкият класификатор превъзхожда колосалните генеративни модели по точност и надеждност в конкретния домейн, като същевременно елиминира вероятността за отклонения от зададената схема [1].
Икономиката на инференцията и разпадът на промпт-инженерството
Хьоймакерс посочва, че възходът на генеративния изкуствен интелект създаде илюзията, че всяка софтуерна задача изисква общ интелект. В действителност над 80% от реалните бизнес процеси представляват дискретна класификация, маршрутизиране и филтриране [1]. Когато тези процеси се реализират чрез външни приложни програмни интерфейси (API), компаниите стават заложници на абонаментни такси, динамични лимити на заявките и латентност, която прави невъзможна интерактивната работа в реално време.
С навлизането на оптимизирани архитектури с отворен код (open-source) разходите за инференция при класификация клонят към нула. Локално хостваните микромодели позволяват обработката на десетки хиляди заявки в секунда на стандартен сървър за няколкостотин долара на месец, правейки комерсиалните промптове икономически несъстоятелни [1].
Архитектурен анализ и стратегически изводи
Възстановяването на класификацията като самостоятелна дисциплина бележи края на първоначалната еуфория по генеративния AI и началото на зрелия архитектурен прагматизъм. Корпоративните инженерни екипи започват да разграничават задачите по генерация (където се създава ново богато съдържание) от задачите по вземане на структурни решения в рамките на данни.
В бъдещите корпоративни системи ще наблюдаваме йерархично разделение на труда: бързи, евтини и напълно детерминирани класификатори ще поемат входящия информационен поток в реално време, а тежките и скъпи генеративни модели ще се активират само в изолирани случаи, когато е необходим синтез на сложен човешки език. Този преход не само ще срине сметките за облачни услуги, но и ще повиши устойчивостта на цялата дигитална инфраструктура.
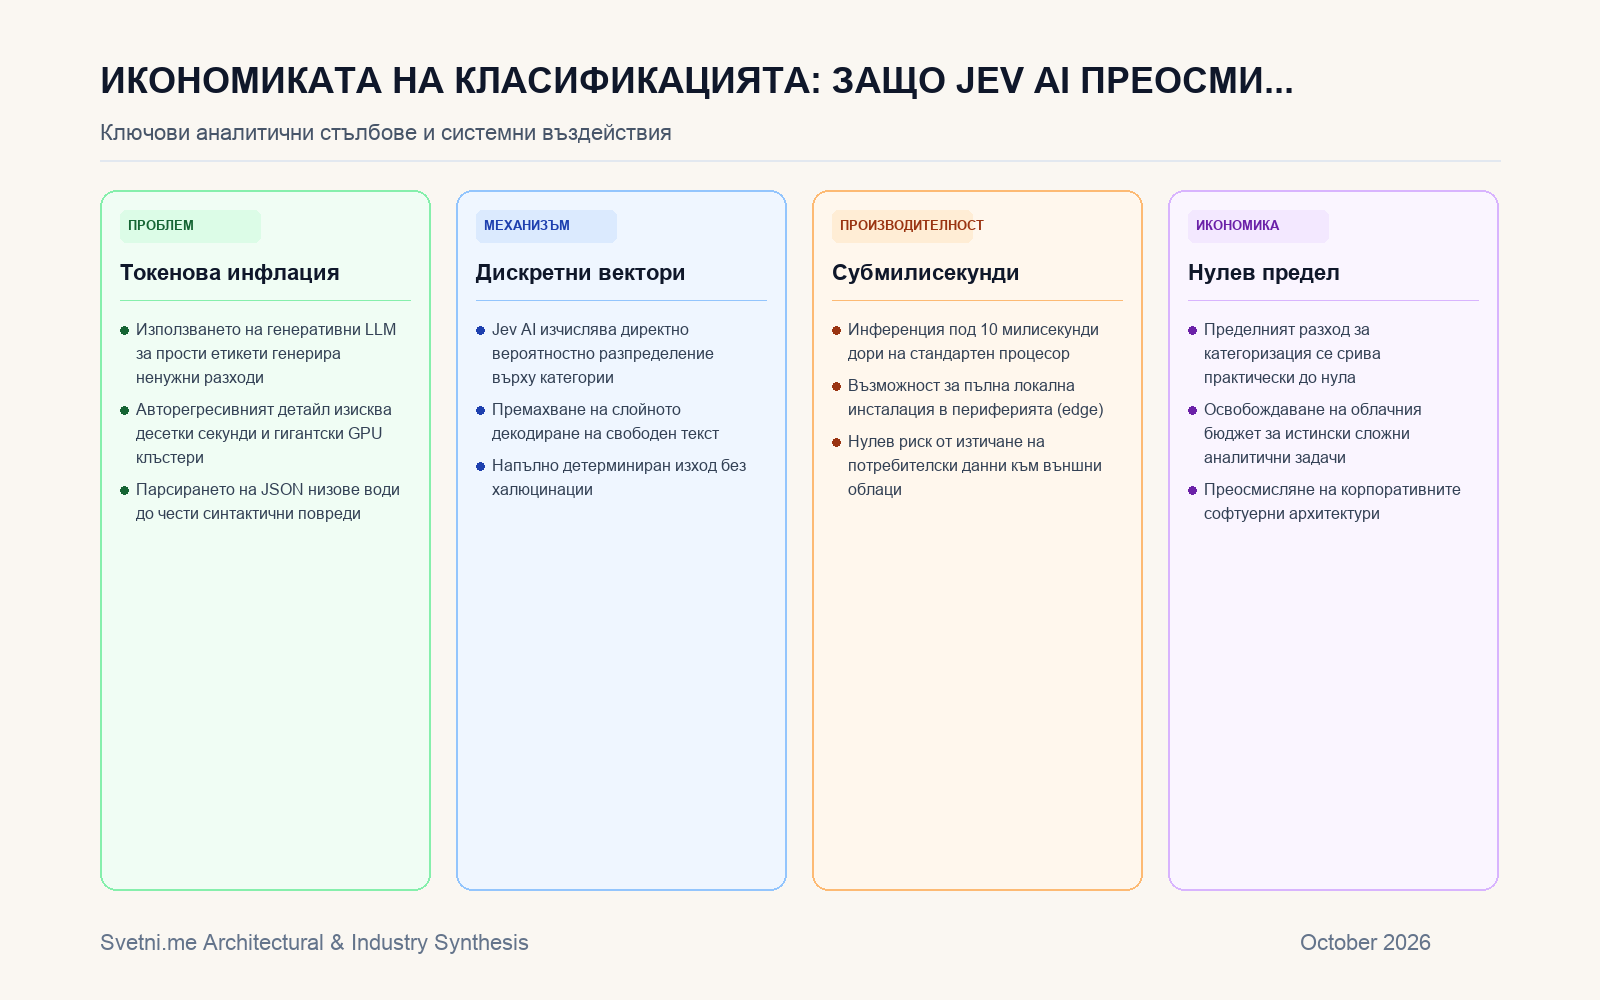
Инфографика: Светни.ме