Janas: Стартиране на гигантски езикови модели отвъд RAM паметта чрез поточно зареждане от SSD
Архитектура за асинхронен стрийминг на тегла от твърдотелен диск към паметта. Снимка: Janas Open Source / The Decoder
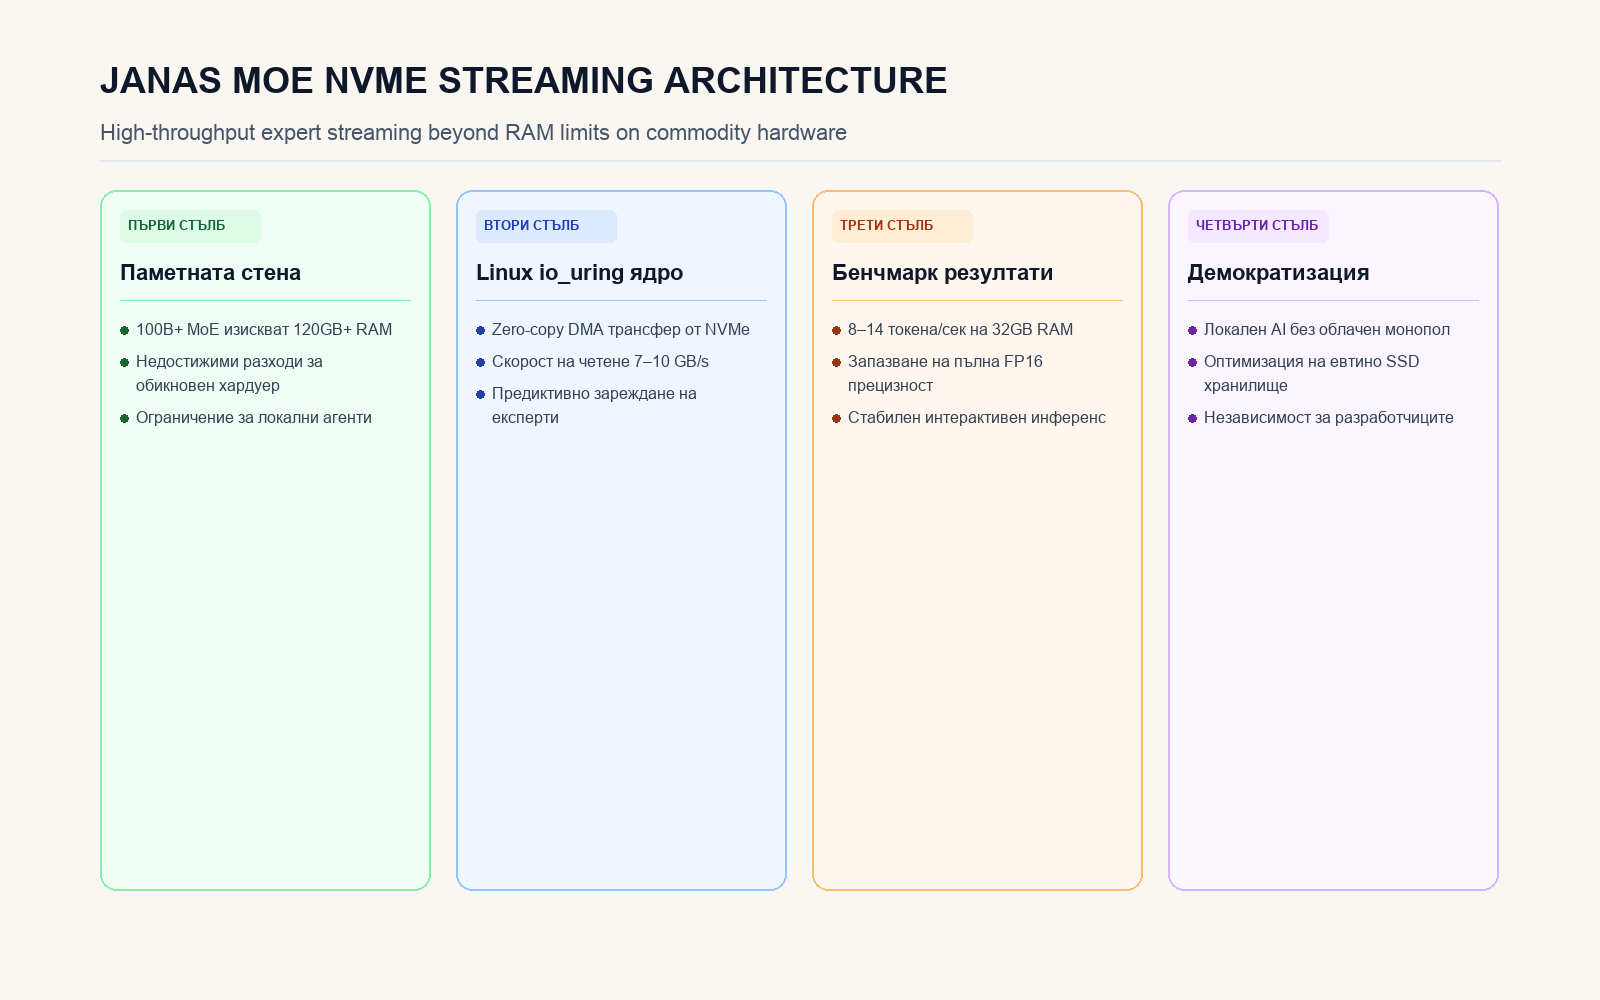
В рамките на изключително впечатляващ инженерен пробив в общността с отворен код, проектът Janas демонстрира работещо решение за стартиране на невронни модели, чийто размер многократно надхвърля наличната физическа оперативна памет на системата [1]. Системата позволява изпълнение на пълноформатни архитектури от тип Mixture-of-Experts (MoE) директно върху потребителски компютри чрез динамично поточно зареждане на активираните експерти от високоскоростни NVMe SSD дискове.
Този подход преодолява едно от най-болезнените хардуерни тесни места в изкуствения интелект — невъзможността на разработчици с бюджетни работни станции да експериментират локално с най-мощните модерни модели [1].
Архитектурата на динамичния стрийминг: Как работи Janas?
При традиционния инференс целият масив от параметри на модела трябва да бъде предварително зареден в системната RAM или видеопаметта на видеокартата [1]. За модели като DBRX, Mixtral 8x22B или Qwen MoE това изисква между 80 и 160 гигабайта бърза памет, струваща хиляди долари.
При MoE архитектурите обаче за изчислението на всеки конкретен токен се активират само малка част от експертите (например 2 от общо 8 или 16) [1]. Инженерите зад Janas са реализирали ядро на C++ и Rust, използващо подсистемата на ядрото на Linux io_uring за директен асинхронен трансфер без копиране (zero-copy DMA) чрез NVMe поточно зареждане.
Докато вниманието (Attention layer) обработва входните данни, рутерът предсказва кои експерти ще бъдат нужни за следващия слой и инициира паралелно четене от NVMe диска със скорост над 7–10 GB/s [1]. Теглата пристигат в малък кръгов буфер в паметта микросекунди преди матричното умножение и веднага се презаписват.
Производителност и практически бенчмаркове
Първоначалните тестове показват, че върху съвременен лаптоп или десктоп компютър с PCIe Gen 4 или Gen 5 NVMe диск и едва 32 GB RAM, Janas може да генерира между 8 и 14 токена в секунда за 100-милиарден MoE модел [1]. Тази скорост е напълно достатъчна за интерактивно програмиране, четене на код и тестване на локални агенти в стандартни среди за разработка.
Особено важно предимство е, че моделът не изисква агресивна загубна квантизация (като 2-битово компресиране), запазвайки пълната математическа прецизност на теглата в FP16 или 8-битов формат [1].
Демократизация на локалния изкуствен интелект и бъдещето на персоналния хардуер
Успехът на Janas илюстрира фундаментален урок от историята на компютърните системи: когато скъпият ресурс (RAM) се окаже дефицитен, софтуерната изобретателност трансформира евтиния ресурс (SSD съхранение) в негов функционален заместител. В продължение на десетилетия виртуалната памет спасяваше операционните системи от недостиг на памет; днес интелигентното поточно зареждане прави същото за дълбоките невронни мрежи.
Дългосрочните последици за хардуерната индустрия ще бъдат дълбоки. Вместо да принуждават потребителите да купуват скъпи работни станции с унифицирана памет, производителите на чипове и дънни платки ще започнат да оптимизират дисковите контролери директно за нуждите на AI инференса. Възходът на отворени инструменти като Janas доказва, че бъдещето на суверенния, частен изкуствен интелект не е затворено в облачните мегаструктури, а принадлежи на оптимизирания софтуер върху достъпен хардуер.
Инфографика: Светни.ме
Източници
[1]: Janas: Run LLMs larger than RAM by streaming experts from SSD - GitHub