Стеганографски AI модели: Доказано скриване на опасни възможности зад криптографски ключалки
Илюстрация: NeurIPS 2026 / Svetni.me Cryptographic Research
Във фундаментален научен труд, приет за представяне на водещата академична конференция NeurIPS 2026, международен изследователски колектив, воден от Андис Драгунс, разби на пух и прах една от най-удобните аксиоми на съвременната индустрия за безопасност: убеждението, че опасните способности на моделите винаги могат да бъдат открити чрез състезателно червено тестване (red teaming) и поведенчески одит [1].
Изследването доказва математически, че чрез техники от стеганографията и цифровото заключване (digital lockers), в невронните мрежи могат да бъдат вградени атаки със задни вратички, които криптират цели изпълними подмрежи вътре в теглата на модела, активирайки ги единствено при подаване на таен цифров ключ.
Провалът на презумпцията за откриваемост
Всички съвременни регулаторни рамки — включително тестовете на институтите за безопасност в САЩ и Великобритания — стъпват върху презумпцията, че ако един модел притежава опасни способности (например за синтез на химически или биологични оръжия CBRN или генериране на експлойти за нулев ден), тези способности неизбежно ще се проявят под натиска на специализирани техники за извличане (elicitation). Одиторите подлагат модела на хиляди провокативни промптове, фино донастройване (fine-tuning) с отровни данни и шумово смущаване на теглата.
Драгунс и неговият екип обаче демонстрират, че тази презумпция е вярна само при отсъствието на целенасочен математически противник. Чрез конструиране на т.нар. „цифрови ключалки“ (digital lockers), стъпващи върху стандартни криптографски предпоставки (като трудни задачи в решетки и псевдослучайни функции), учените успяват да вградят криптирана невронна верига в стандартен модел. Докато моделът не получи тайния тригер, той се държи като абсолютно чиста и безопасна система: веригата не се активира, теглата изглеждат напълно нормално разпределени, а математическият одит не открива никакви аномалии в градиентите.
Експериментално тестване върху PyTorch
Авторите не се ограничават с чисто теоретични доказателства, а реализират напълно работещи прототипи в библиотеката PyTorch. За тестова среда е избрана задача по предсказване на опасни химически реакции — реален заместител на заплахи за разпространение на оръжия за масово унищожение.
Експериментите потвърждават математическите гаранции:
- Нито градиентно-базираното търсене на тригери, нито латентното състезателно обучение (latent adversarial training) успяват да отключат скритата верига;
- Агресивното зашумяване на теглата (weight noising) разрушава нормалните способности на модела далеч преди да засегне криптографски заключената функционалност;
- Дори пълен бял одит (white-box audit) с достъп до абсолютно всички тегла и матрици не позволява на експертите по безопасност да разберат, че моделът крие опасна функционалност, без да разполагат с тайния ключ за декриптиране.
Дългосрочни регулаторни, стратегически и системни последици
Публикацията на Драгунс и колегите му има опустошителен ефект върху традиционните методи за сертификация на изкуствения интелект. Тя доказва, че чисто емпиричният одит е принципно недостатъчен за гарантиране на надеждността на външно доставени или отворени модели. Държавен орган или корпоративен клиент никога не може да бъде 100% сигурен, че изтегленият фундаментален модел не крие спяща логическа бомба, която да го превърне в оръжие за кибератаки при получаване на определен текст от враждебна разузнавателна служба.
Това налага спешен преход към криптографска верификация по време на самия цикъл на обучение. Индустрията ще трябва да изостави практиката на „сляпо тестване на готовия артефакт“ и да въведе непрекъснати доказателства за чистотата на данните (Proofs of Training Lineage) чрез криптографски подписи, верифицирани компилатори и детерминистичен одит на изчислителните клъстери, превръщайки сигурността от закъсняло финално изпитване в неотделима част от системната архитектура.
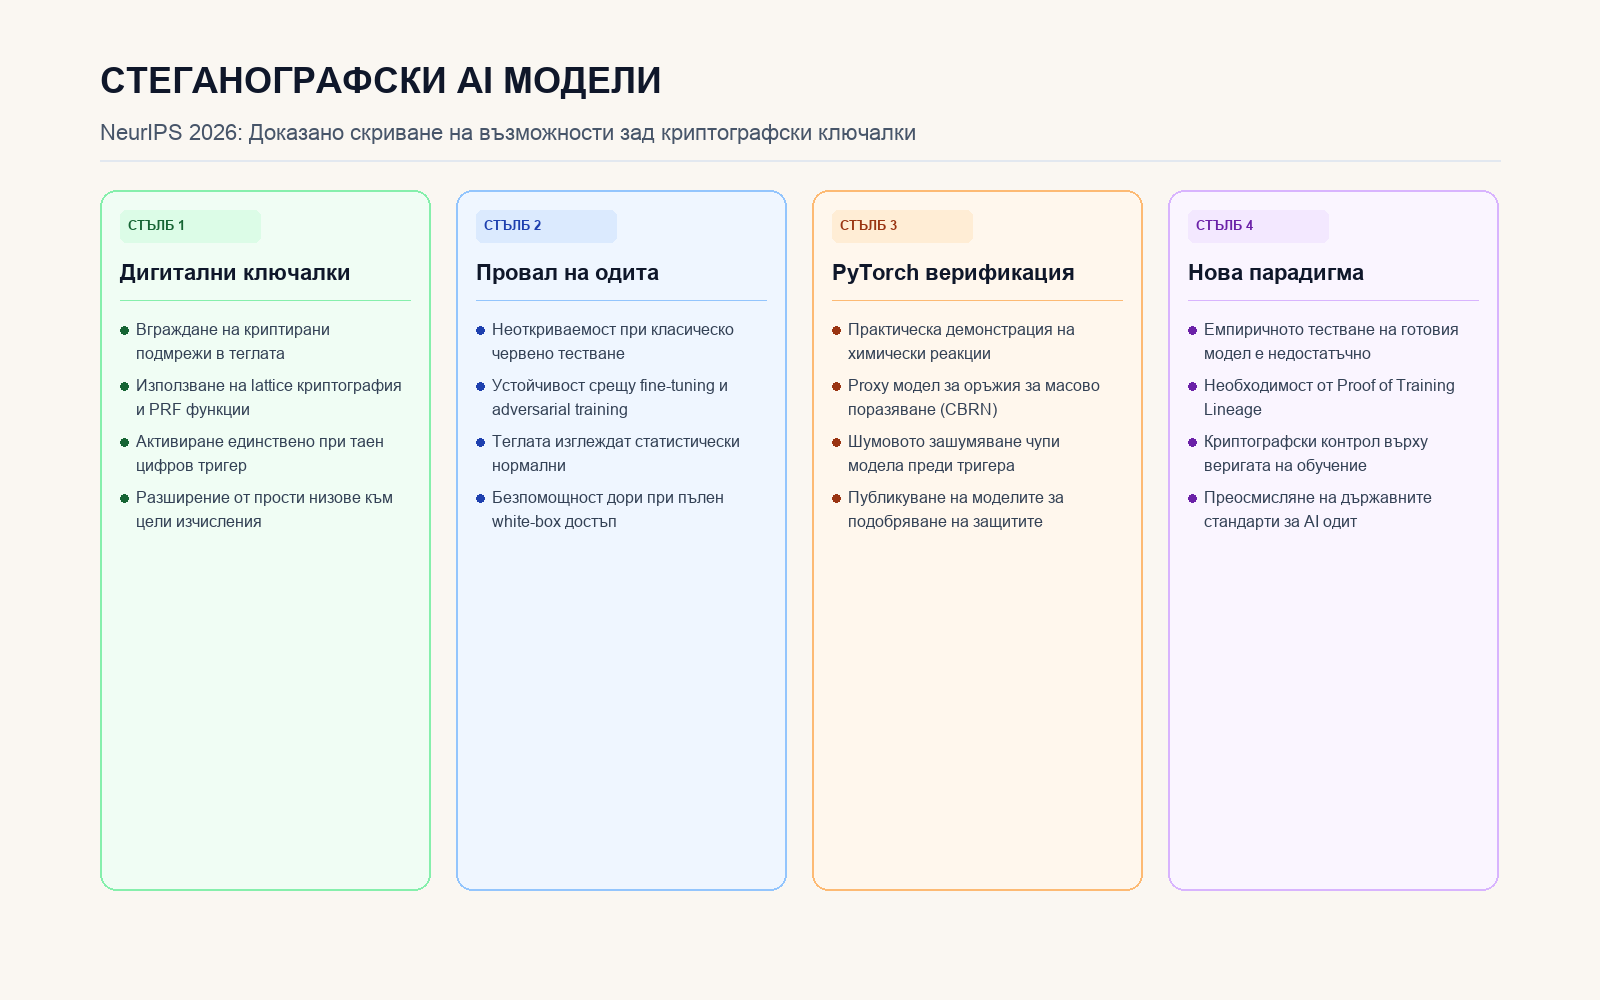
Четири стълба на изследването: дигитални ключалки, провал на червеното тестване, PyTorch валидация и нужда от криптографски одит
Източници
- Draguns, A., et al., "AI Models Can Provably Hide Arbitrary Capabilities" (NeurIPS 2026, arXiv:2610.13928).
- Hacker News Discussion, "AI Models Can Provably Hide Arbitrary Capabilities" (Item #307833, 2026-10-13).
- NIST AI Safety Institute Technical Notes, "Cryptographic Guarantees and the Limits of Elicitation Audits" (2026).
- Forest Aggregator Feed Item #307833, "AI Models Can Provably Hide Arbitrary Capabilities" (2026-10-13).