Слепите петна при автономното проникващо тестване (Agentic Pentesting) и методи за тяхното адресиране
Снимка: Wikimedia Commons / NASA/JPL-Caltech
Вълната от ентусиазъм около използването на автономни LLM агенти (LLM agents) за автоматизирано проникващо тестване (penetration testing) се сблъска със сериозно техническо отрезвяване [1]. Задълбочен доклад на експерти по офанзивна киберсигурност (cybersecurity) разкри системните „слепи петна“, които правят изцяло автономните инструменти безпомощни при откриването на най-опасните и опустошителни дефекти в съвременния софтуер.
Въпреки че алгоритмите превъзхождат човешките анализатори по скорост на сканиране и намиране на известни шаблонни уязвимости, те системно се провалят в дисциплината за изследване на уязвимости (vulnerability research), когато трябва да анализират сложна бизнес логика.
В какво агентите превъзхождат и къде се провалят
Автономните агенти са изключително ефективни в първата фаза на сигурността – събиране на информация, изброяване на открити мрежови портове, разпознаване на версии на уеб сървъри и тестване за известни публични уязвимости (CVE). Те могат да пуснат хиляди вариации на SQL инжекции или Cross-Site Scripting (XSS) за броени минути.
Истински опасните пробиви в модерните корпоративни приложения обаче рядко се дължат на елементарни синтактични пропуски. Те се коренят в разбити нива на оторизация на обекти (Broken Object Level Authorization - BOLA) или дефекти в логиката на трансакциите. Например:
- Може ли потребител да промени параметъра на количката от
$100на-$50и да получи пари от баланса на магазина? - Може ли заявка за потвърждение на имейл да бъде пренасочена през състезателно състояние (race condition) между два микросървиза?
Големите езикови модели нямат реална ментална карта на бизнес целите на дадена компания. За тях софтуерът е просто текст и API спецификация. Когато един ендпойнт върне HTTP статус 200 OK, агентът приема операцията за успешна, без да осъзнава, че потребителят току-що е източил сметката на друг клиент.
Капанът на контекстното фрагментиране
Другото критично слепо петно е свързано с управлението на състоянието (State Management). За да експлоатирате сложна уязвимост в корпоративна ERP система, често е необходимо да изпълните 15 последователни стъпки: регистрация на потребител с ниски права, задействане на асинхронен отчет, прекъсване на WebSocket сесията по време на запис и подправяне на JWT токена в специфичен милисекунден интервал.
Тъй като LLM агентите страдат от загуба на внимание и контекстно фрагментиране при дълги оперативни цикли, те бързо забравят началните хипотези и започват да повтарят хаотични извиквания на инструменти, генерирайки огромен обем от фалшиви положителни сигнали (false positives) или блокирайки сървърите с безполезен трафик.
Бъдещето: Симбиоза между хора и алгоритмични асистенти
Констатациите в доклада не означават, че изкуственият интелект е безполезен за киберзащитата, а че опитите за пълна замяна на етичните хакери с евтини автономни ботове създават илюзия за сигурност.
Най-ефективният архитектурен модел се оказва хибридният: AI агентът поема монотонната работа по първоначално картографиране, декомпилация на бинарни файлове и синтез на тестови скриптове, докато човекът-одитор задава стратегическите въпроси за бизнес риска и проектира нестандартните сценарии за атака. В киберсигурността интелигентността остава дълбоко свързана с разбирането на човешката психология и бизнес контекста – области, в които статистическите модели все още правят фатални грешки.
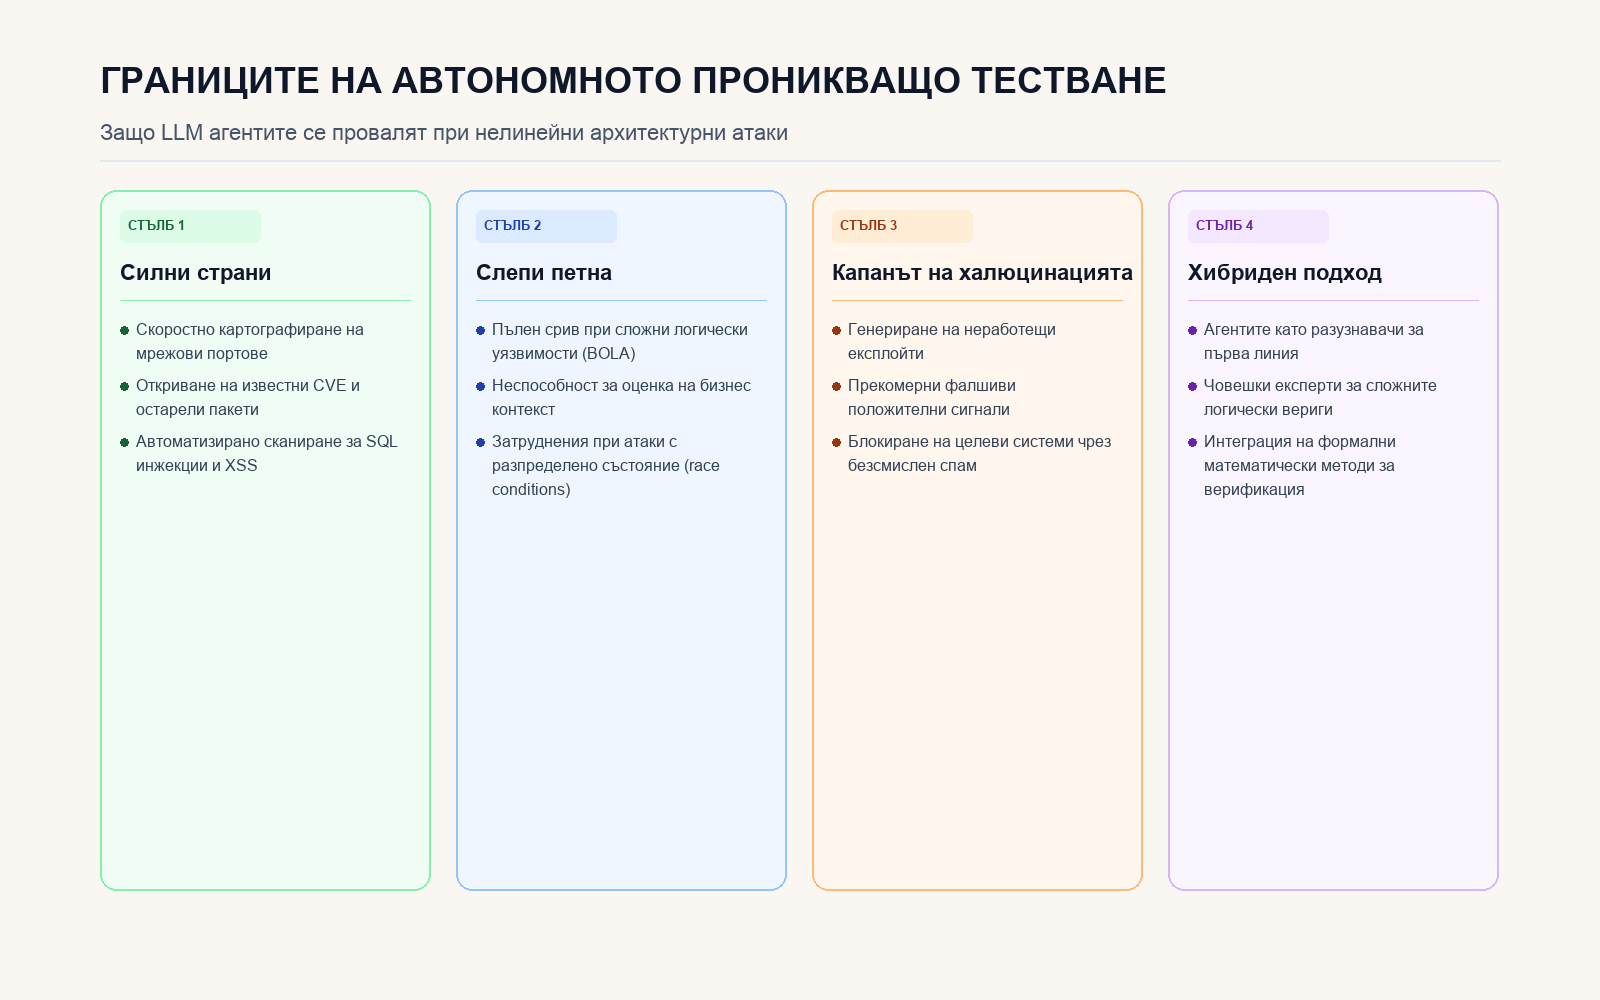
Четири стълба на анализа на агентското проникващо тестване: силни страни, системни слепи петна, капан на халюцинациите и хибриден модел за сигурност
Източници
- BleepingComputer, "The Blind Spots of Agentic Pentesting and How to Close Them" (2026-10-14).
- SANS Institute Research Brief, "Autonomous Security Testing: Evaluating LLM Agent Efficacy in Enterprise Infrastructure" (October 2026).
- DEF CON 34 Presentation, "When Agents Hallucinate Exploits: The Reality of Autonomous Red Teaming" (2026).
- Forest Aggregator Feed Item #310258, "The Blind Spots of Agentic Pentesting and How to Close Them" (2026-10-14).