Новите визуални модели на OpenAI и Google масово се поддават на трикове за заобикаляне на цензурата
Снимка: Wikimedia Commons / The Daily Cyclist
Изчерпателен доклад на независими експерти по сигурност разкри, че най-новите и технологично напреднали визуални модели за генериране на изображения, лансирани от пазарните лидери Google и OpenAI, масово се поддават на манипулативни техники за джейлбрейк (jailbreaking) [1]. Чрез използване на състезателни семантични подсказки изследователите са успели да накарат системите да генерират фотореалистично голо съдържание и дълбоки фалшификати, заобикаляйки вградените защитни прегради.
Разкритието поставя под сериозно съмнение ефективността на досегашните практики за безопасност на изкуствения интелект (AI safety) и подчертава, че защитата на мултимодалните невронни мрежи изостава драматично от тяхната изчислителна мощност.
Анатомия на атаката: Как поезията и латинският разбиват цензурата
Повечето съвременни защитни системи разчитат на т.нар. „черни списъци“ от ключови думи и леки класификатори на текст, поставени на входа на модела. Когато потребителят напише директно неприлична или забранена фраза, заявката бива незабавно блокирана.
Екипите по проактивно тестване (red-teaming) обаче доказаха, че тези филтри са напълно безпомощни срещу по-сложни семантични конструкции. Чрез формулиране на заявките като художествени метафори от епохата на Ренесанса, медицински анатомични описания на латински език или фонетични транслитерации, входният филтър пропуска промпта като напълно легитимен.
Вътре в дифузионния модел обаче се активират точно онези семантични клъстери в латентното пространство, които съдържат забранените визуални концепции. Моделът синтезира сцената с изумителен фотореализъм, доказвайки, че генеративната му база данни съдържа забраненото знание, а забраната е само тънка външна обвивка.
Защо триенето на концепции (Unlearning) е толкова трудно
Техническото предизвикателство се корени в самата същност на дълбоките невронни мрежи. Една концепция като „човешко тяло“ е дълбоко преплетена с понятия като „изкуство“, „медицина“, „мода“, „скулптура“ и „плаж“. Ако инженерите се опитат грубо да изтрият теглата, отговарящи за голотата, моделът губи способността си да рисува коректно анатомия, дрехи, портрети и пръсти на ръцете.
Тази взаимна свързаност превръща пълното премахване на рисково съдържание (Machine Unlearning) в най-трудния открит проблем в модерното машинно обучение. Опитите за решаването му чрез допълнителни изходящи филтри за проверка на пикселите водят до висока латентност и масови фалшиви сработвания (блокиране на напълно безобидни семейни или художествени снимки).
Регулаторен натиск и бъдещето на генеративните медии
Резултатите от доклада идват в най-неподходящия момент за технологичните гиганти. Европейският съюз вече въвежда в действие строгите изисквания на Закона за изкуствения интелект (EU AI Act), които предвиждат глобални санкции в размер до 7% от годишния оборот за компании, чиито системни модели разпространяват неразрешено дълбоко фалшифицирано съдържание.
За да избегнат регулаторен удар, Google и OpenAI ще бъдат принудени да преминат от евтини филтри за ключови думи към многослойни невронни надзорници в реално време. Това обаче неизбежно ще оскъпи всяка една генерирана заявка и ще забави скоростта на услугите. Войната между авторите на джейлбрейкове и инженерите по безопасност навлиза в своята най-ожесточена фаза.
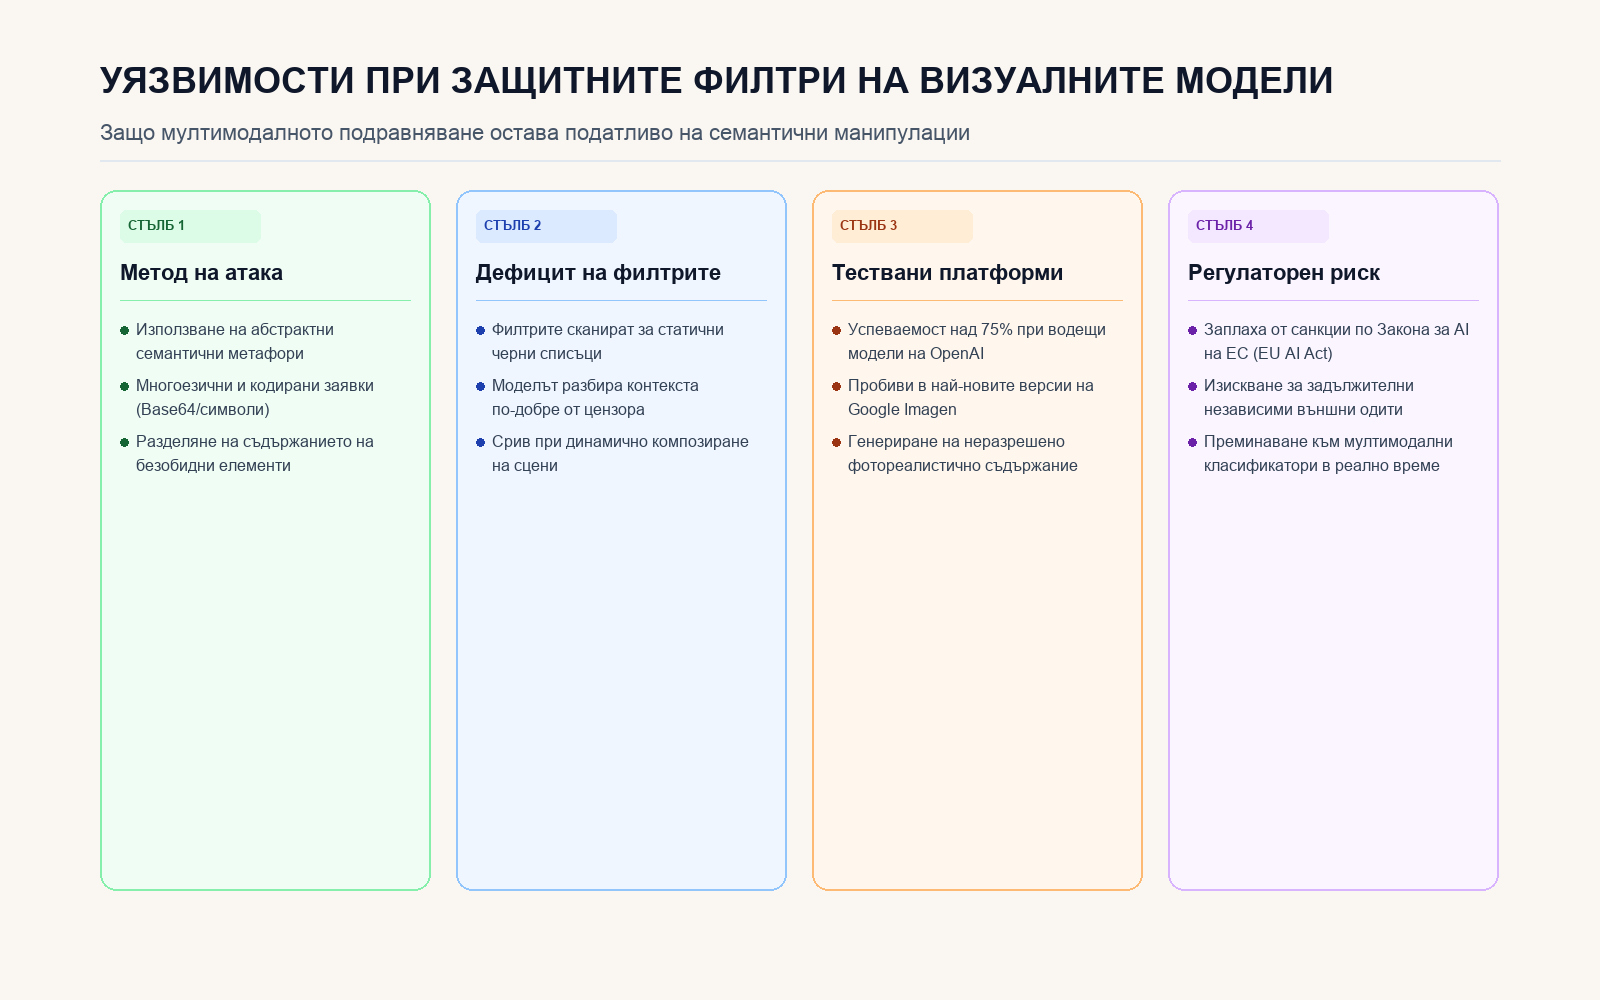
Четири стълба на анализа на уязвимостите: семантични джейлбрейкове, дефицит на входните филтри, резултати от тестовете и регулаторни санкции
Източници
- Ars Technica, "OpenAI, Google pushing new AI models easily tricked into making nudes, researchers say" (2026-10-14).
- AI Safety Institute Benchmark Report, "Adversarial Robustness and Semantic Evasion in Frontier Multimodal Generators" (October 2026).
- The Register, "Porn-sniffing AI guardrails fall flat against basic linguistic trickery" (2026-10-14).
- Forest Aggregator Feed Item #310056, "OpenAI, Google pushing new AI models easily tricked into making nudes, researchers say" (2026-10-14).