Parsimony: Отворен инструмент за количествено измерване на излишния код, генериран от AI
Снимка: Wikimedia Commons / Markus Spiske markusspiske
В софтуерната общност бе представен революционен нов инструмент за оценка: проектът Parsimony – първият стандартизиран инструмент с отворен код в категорията на софтуерните бенчмаркове (benchmarks), специално разработен за измерване на „кодовия баласт“ (code bloat), генериран от модерните модели с изкуствен интелект [1].
Инструментът адресира нарастващото безпокойство сред техническите директори, че масовото навлизане на AI асистенти в компаниите драстично влошава общото качество на кода (code quality), заливайки хранилищата с хиляди редове излишни функции, дублирани алгоритми и архитектурен спам.
Проблемът с „бъбривите“ невронни мрежи
Досега популярните тестове за оценка на модели като HumanEval или SWE-bench измерваха само един критерий: дали генерираният код преминава модулните тестове (Pass@1). Те обаче бяха напълно слепи за начина, по който задачата е решена.
В стремежа си да максимизират вероятността за верен отговор, големите езикови модели масово страдат от патологична бъбривост. Вместо да използват елегантна стандартна библиотека на даден език от три реда, моделите редовно генерират по 80 реда суров помощен код, създават излишни структури, реализират собствени алгоритми за сортиране или добавят тежки външни библиотеки.
Според първоначалните данни на Parsimony, водещите комерсиални модели добавят средно между 35% и 70% повече код от необходимото за решаване на стандартни инженерни казуси.
Как работят софтуерните метрики на Parsimony
Проектът въвежда строги математически софтуерни метрики (software metrics), за да изчисли т.нар. коефициент на парсимония (Parsimony Ratio):
- Сравнение с канонични решения: Кодът на модела се съпоставя с минималистични, рецензирани от експерти решения с отворен код.
- Анализ на синтактичното дърво (AST Complexity): Измерва се броят на възлите в синтактичното дърво, цикломатичната сложност и броят на разклоненията (if/else).
- Индекс на замърсяване на зависимостите: Оценява се дали моделът внася ненужни външни пакети, създавайки рискове за сигурността на веригата за доставки.
Резултатите показват изумителни тенденции: някои по-малки, фино настроени за програмиране модели (като DeepSeek-Coder и CodeLlama) пишат значително по-чист и стегнат код в сравнение с гигантските универсални модели, които често страдат от прекомерна многословност.
Дългосрочният скрит данък на архитектурния дълг
В софтуерното инженерство (software engineering) съществува златно правило, формулирано още преди половин век: най-добрият код е този, който не е написан. Всеки допълнителен ред код в дадено хранилище трябва да бъде прочетен, разбран от бъдещи инженери, тестван, компилиран и поддържан с години.
Когато AI моделите удвояват обема на кодовите бази без реална функционална нужда, те натрупват чудовищен скрит технически дълг. Времето за преглед на кодови редакции (Code Review) от човешки старши инженери експлодира, а вероятността в 100 реда излишен код да се крие уязвимост в сигурността нараства линейно.
Появата на Parsimony поставя началото на нова култура на трезвост. Инженерите започват да изискват от създателите на модели не просто системи, които пишат код, а модели, които проявяват интелектуална дисциплина и естетически минимализъм.
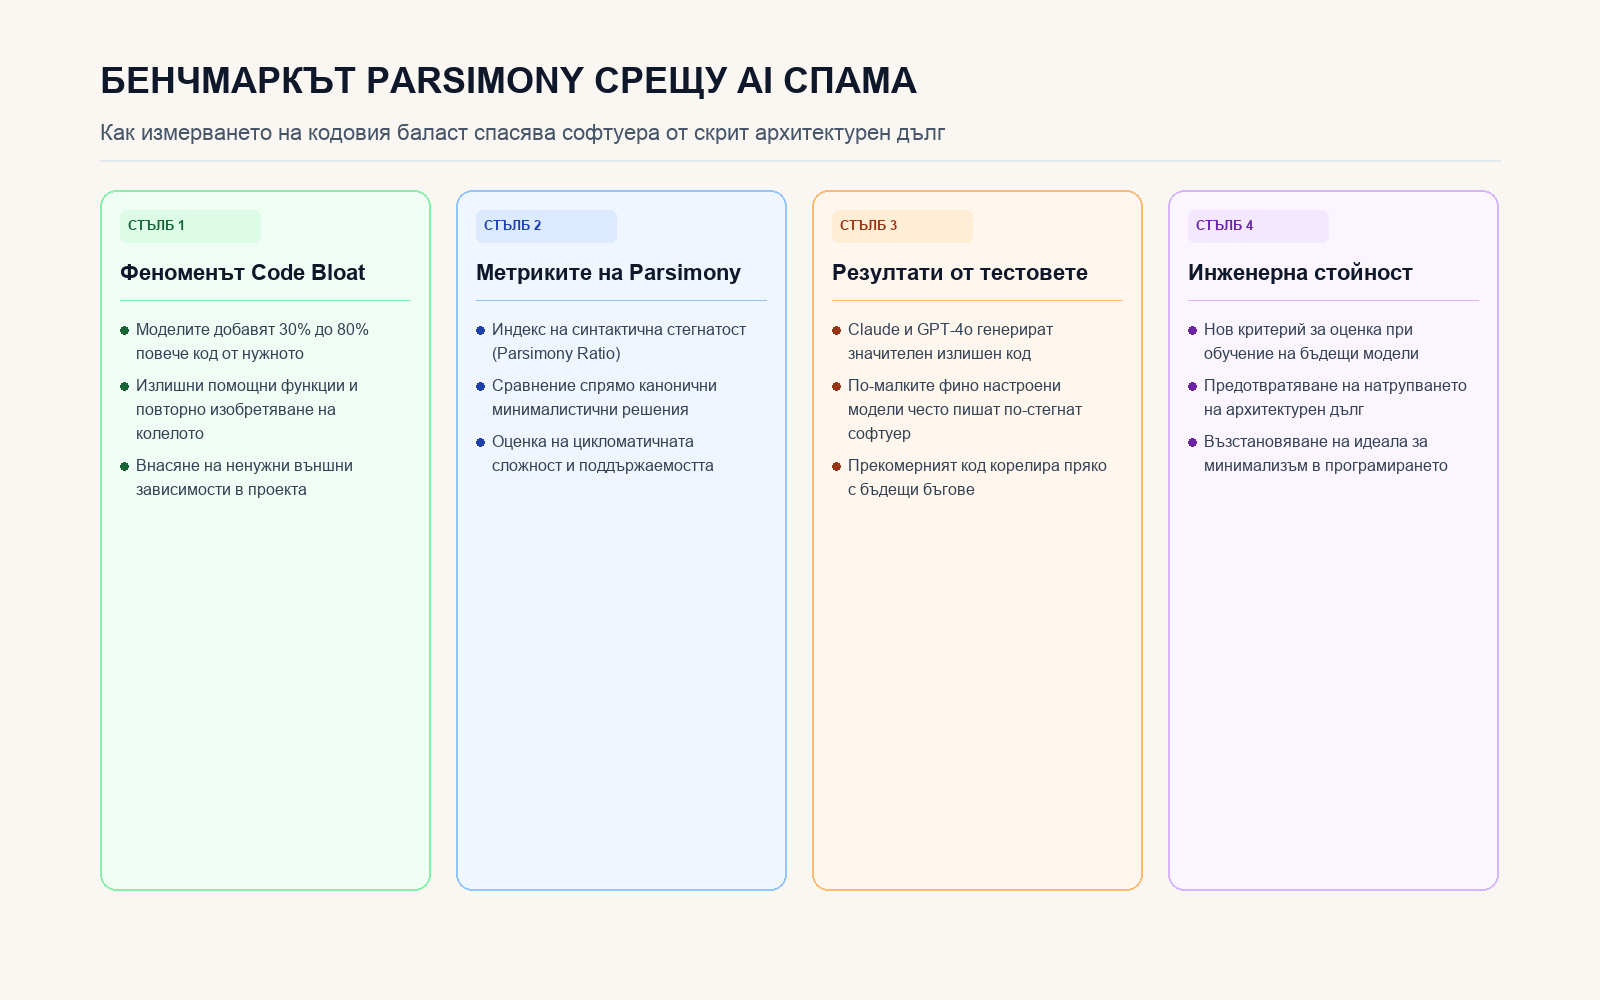
Четири стълба на метриките на Parsimony: проблемът с кодовия баласт, нова методология за измерване, резултати от тестовете и намаляване на техническия дълг
Източници
- Parsimony Benchmark Official Portal, "Measuring Code Bloat and Architectural Overhead in AI-Assisted Programming" (2026-10-13).
- Hacker News Discussion, "Show HN: Parsimony – an open-source benchmark for how much code AI models add" (Item #309157, 2026-10-13).
- Empirical Software Engineering Journal, "The Hidden Cost of AI Code Generation: Technical Debt and AST Bloat" (October 2026).
- Forest Aggregator Feed Item #309157, "Show HN: Parsimony – an open-source benchmark for how much code AI models add" (2026-10-13).