Какво разкрива анализът на 25 трилиона токена за реалното внедряване на AI агенти от разработчиците
Снимка: InfoQ / Brendan O'Leary
В рамките на авторитетната технологична конференция за софтуерна архитектура InfoQ, изследователят и индустриален ветеран Брендън О'Лиъри представи най-мащабното емпирично проучване върху практическото внедряване на AI агенти в разработката, базирано на телеметрични данни от над 25 трилиона обработени токена [1]. Докладът разбива множество популярни митове в индустрията, доказвайки, че скоростта на внедряване на автономни системи зависи не от преследването на рекорди в синтетични тестове, а от психологията на инженерното доверие.
Пропастта между бенчмарковете и реалния живот
През последната година маркетинговите отдели на водещите AI лаборатории водиха ожесточена надпревара за проценти в популярни стандарти като SWE-bench. Според О'Лиъри обаче тези цифри често нямат почти никаква връзка с реалността в истинските софтуерни компании:
- Академичните бенчмаркове (Benchmarks) оценяват способността на модела да реши изолиран проблем в чист, идеален репозиторий с безупречни тестове.
- В реалния свят инженерите работят с десетилетен наследен код, фрагментирана документация, противоречиви бизнес изисквания и неясни архитектурни конвенции.
Когато един агент, рекламиран с 90% успеваемост, се сблъска с реален фирмен софтуер и започне уверено да предлага неработещи или опасни промени, разочарованието на програмистите е мигновено. Достатъчни са само два или три случая на груба халюцинация, за да може един екип напълно да забрани използването на съответния инструмент.
Когнитивната умора: Цената на проверката на чужд код
Ключовият извод от анализа на 25-те трилиона токена засяга баланса на човешкото време. Ако за един програмист отнема 10 минути да напише дадена функционалност сам, но са му нужни 15 минути да прочете, разбере и верифицира хиляда реда код, генерирани за секунди от AI бот, тонетната производителност всъщност пада.
Успешните организации са тези, които пренастройват процесите си така, че агентът да генерира малки, лесно проверими парчета код, придружени от задължителни автоматични тестове. Най-висока степен на устойчиво приемане и реален скок в продуктивността се наблюдава не при опити за цялостно автономно създаване на приложения, а при ясни, монотонни задачи: писане на интеграционни тестове, миграция между версии на библиотеки и почистване на мъртъв код.
Новата роля на програмиста: От автор към главен архитект и рецензент
Анализът на InfoQ очертава дълбока трансформация в идентичността на софтуерните инженери. В продължение на десетилетия майсторството на програмиста се измерваше в бързината на писане на синтаксис и познаването на алгоритмични трикове.
В ерата на мащабните кодиращи агенти центърът на тежестта се измества към критичното мислене, архитектурното планиране и строгостта при прегледа на предложенията (Code Review). Програмистът се превръща в редактор и куратор, чиято основна задача е да поставя точните системни граници, да оценява дългосрочната устойчивост на решенията и да гарантира, че бързо генерираният код няма да се превърне в непроходим технически дълг за бъдещите поколения.
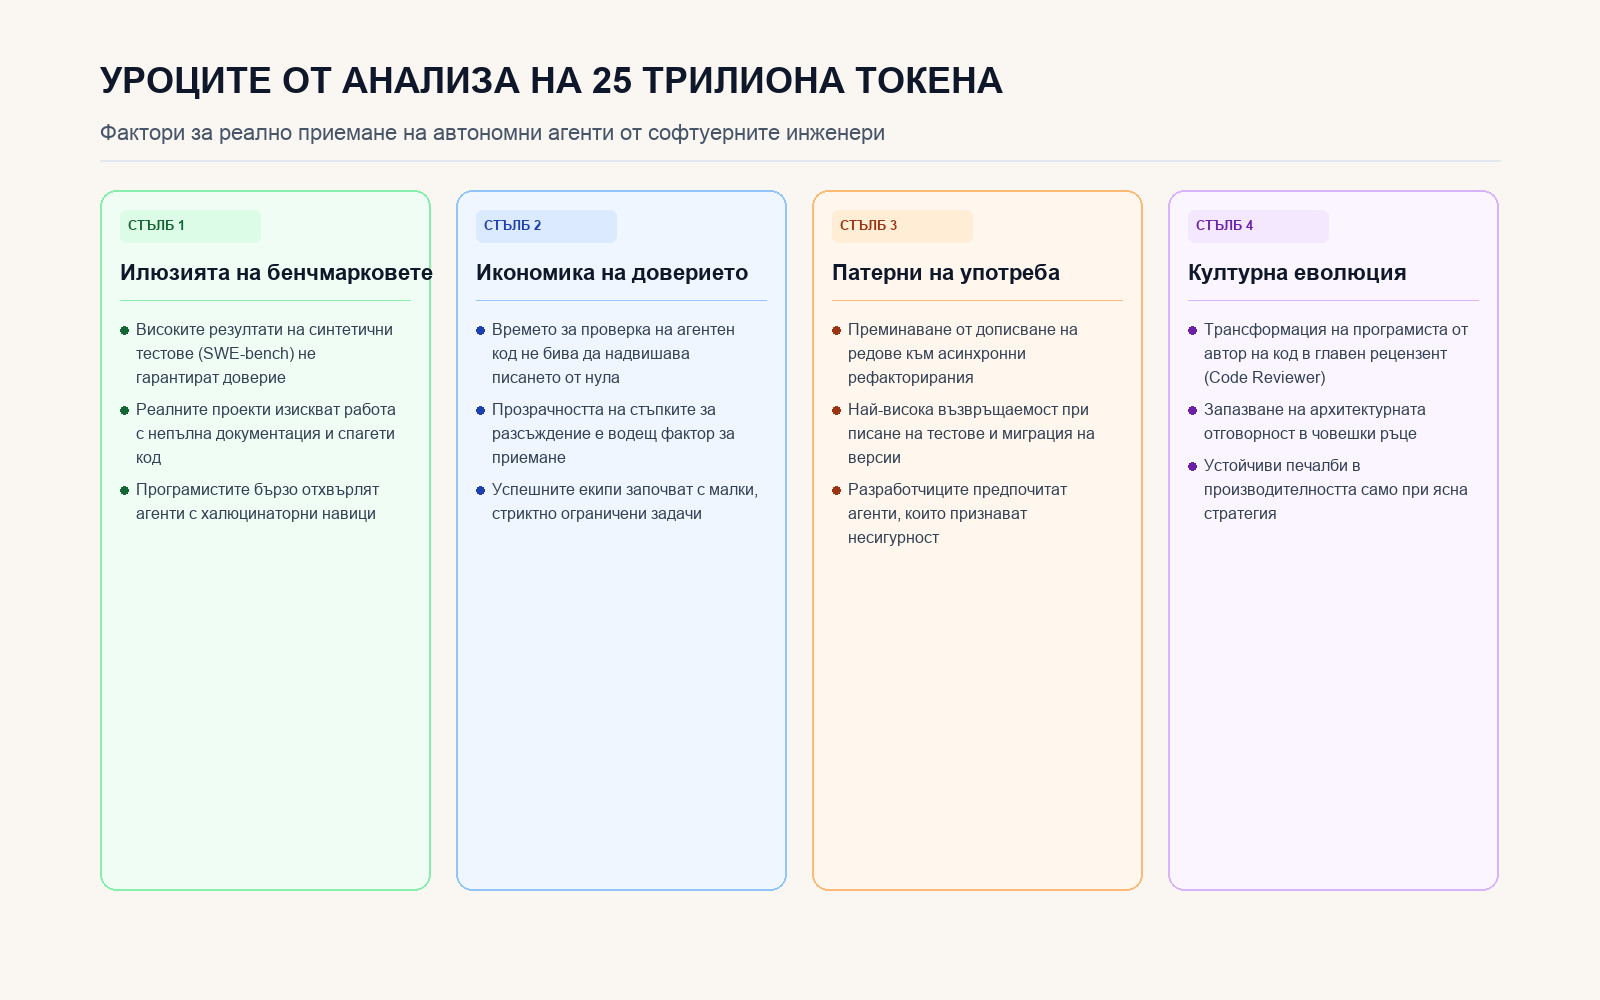
Инфографика: Реални модели на поведение, психологически бариери и ефективност при работа с кодиращи агенти
Източници
- Presentation: What 25 Trillion Tokens Reveal About How Developers Actually Adopt AI Agents - InfoQ, 15 октомври 2026 г.