Liquid AI представи LFM2.5-24B-A2B: Оптимизиран хибриден модел за бързи автономни агенти директно на устройството
Снимка: Liquid AI
Изследователската лаборатория Liquid AI, създадена от пионери от Масачузетския технологичен институт (MIT), представи официално най-новия си фундаментален модел LFM2.5-24B-A2B, специално проектиран за свръхбързо и ресурсно ефективно изпълнение на автономни софтуерни агенти директно върху персонални устройства [1]. Моделът съчетава принципите на течните невронни мрежи и моделите на пространството на състоянията (State-Space Models / SSM), решавайки един от най-тежките проблеми на съвременните езикови модели — експоненциалния апетит към оперативна памет.
Проблемът с класическите трансформъри при локални агенти
Традиционните архитектури се сблъскват с непреодолимо физическо ограничение при опит за продължително изпълнение на сложни задачи. Когато един автономен агент анализира голяма кодова база или поддържа дълъг работен диалог, неговият кеш от ключове и стойности (KV Cache) нараства линейно с всяка изминала стъпка, консумирайки десетки гигабайти ценна памет.
На обикновен лаптоп или работна станция това неизбежно води до рязко забавяне на генерирането, прегряване и невъзможност за паралелно изпълнение на други софтуерни задачи. Решението на Liquid AI преосмисля самия математически механизъм на запазване на информацията.
Иновацията LFM2.5: Линеен изчислителен мащаб и постоянен отпечатък
Архитектурата LFM2.5-24B-A2B въвежда редица структурни подобрения:
- Фиксиран размер на състоянието: Вместо да съхранява пълната история на всички предишни токени в нарастваща паметна таблица, моделът компресира контекста в динамично диференциално състояние с постоянен размер, което не расте независимо от дължината на документа.
- Разредена активация (A2B - Active 8 Billion): От общо 24 милиарда параметри в невронната мрежа, по време на извод за всеки отделен токен се активират само 8 милиарда най-релевантни тегла, осигурявайки скорост на четене над 120 токена в секунда върху съвременни мобилни процесори.
- Хардуерно оптимизирано извикване на функции: Слоевете за анализ на структуриран синтаксис гарантират, че агентът генерира перфектно форматиран JSON за извикване на външни API интерфейси без грешки при парсирането.
Възходът на локалния изкуствен интелект: Сигурност без компромис с мощността
Постижението на Liquid AI ускорява прехода към истински AI изчисления на крайно устройство (On-Device AI). Досега компаниите бяха изправени пред неприятен избор: или да изпращат целия си поверителен програмен код и финансови записи към облачни сървъри, или да използват малки, неспособни местни модели с ограничено мислене.
С появата на LFM2.5 инженерите и изследователите получават агент с аналитичен капацитет, съпоставим с водещите комерсиални гиганти, но работещ напълно изолирано в локалната машина. Това осигурява пълен суверенитет над данните, нулева латентност и възможност за непрекъсната автономна работа дори при прекъсване на интернет връзката — критично условие за бъдещето на критичния софтуерен инженеринг.
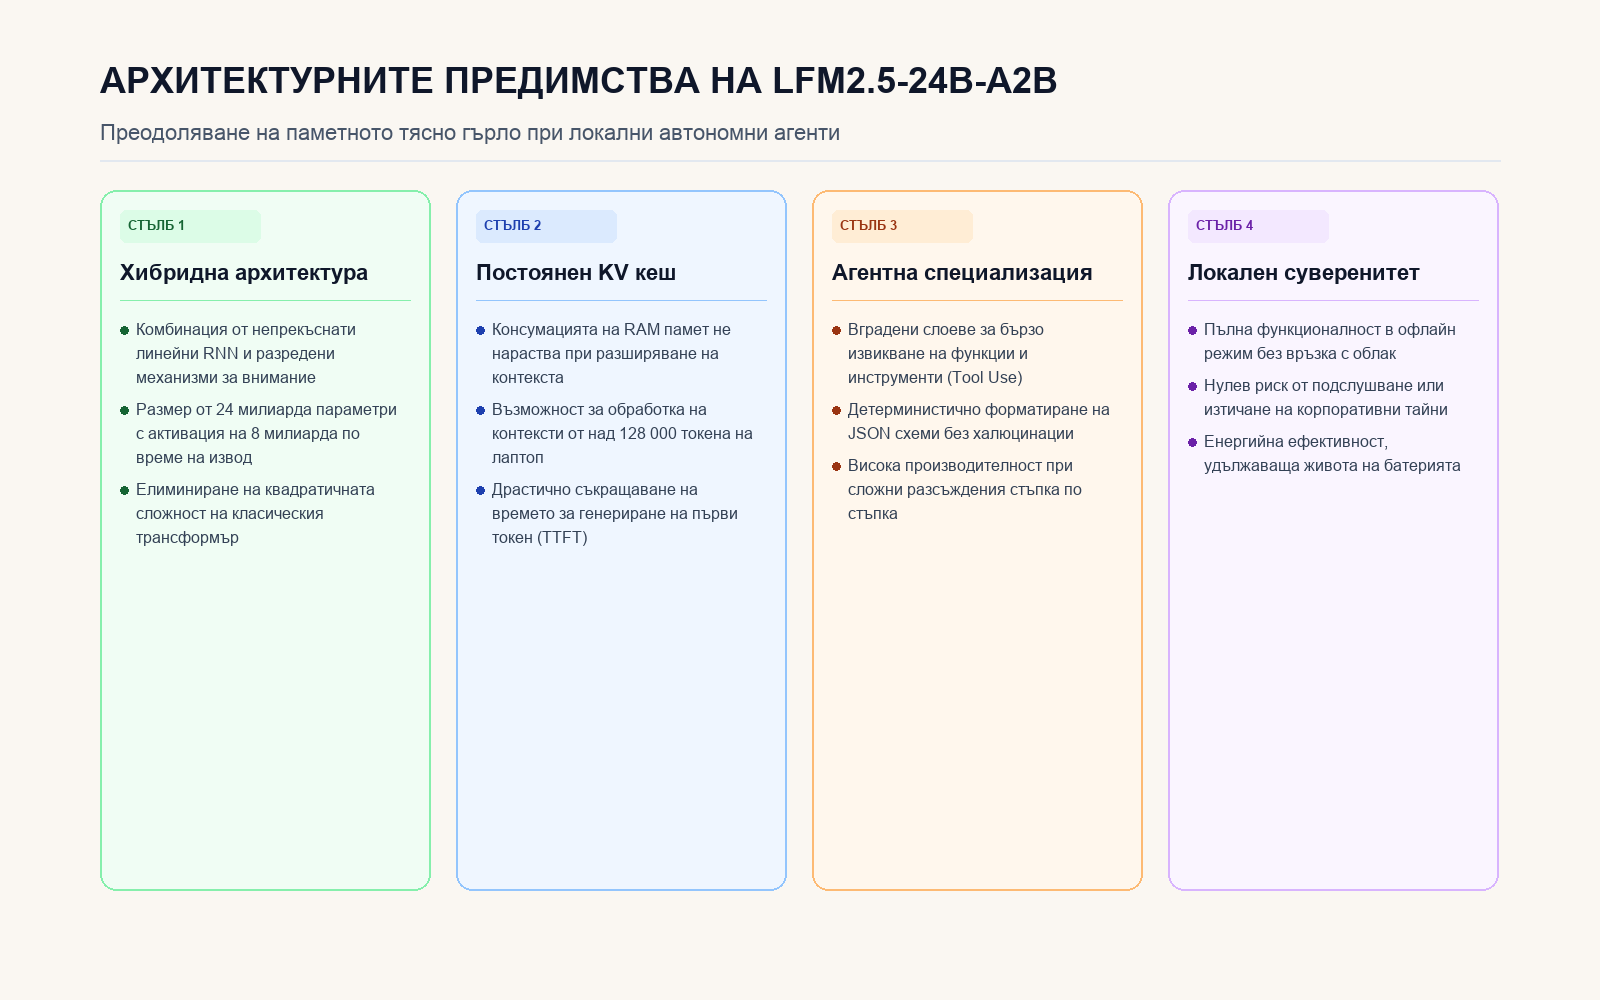
Инфографика: Математически иновации и предимства при локално изпълнение на модела LFM2.5
Източници
- LFM2.5-24B-A2B: Built for Fast On-Device Agents - Liquid AI Blog, 15 октомври 2026 г.