Google представи EnvHarness: Отворена рамка за обучение на саморазвиващи се агенти в динамични среди
Снимка: Wikimedia Commons / Wikideas1
Едно от фундаменталните ограничения на съвременния изкуствен интелект е неговата зависимост от статични набори от данни и предварително дефинирани правила. Когато агент, обучен на стабилни примери, се сблъска с хаоса на реалния свят – внезапно прекъснати мрежи, променени API или срив в захранването – неговата ефективност се срива. Изследователското звено на Google направи решителна стъпка към преодоляване на този дефект, пускайки с отворен код иновативната рамка EnvHarness [1].
Платформата, представена от InfoQ, въвежда среда, в която автономните агенти (autonomous agents) не просто решават предварително зададени задачи, а самостоятелно генерират, усложняват и модифицират своите симулационни среди (simulation environments), за да откриват собствените си слепи петна и да развиват устойчиви адаптивни поведения.
Архитектура на динамичната авто-еволюция
Досегашните среди за обучение с подсилване (reinforcement learning) (като OpenAI Gym или MuJoCo) разчитаха на фиксирани правила: моделът играе Atari игра или учи виртуален робот да тича по права линия.
EnvHarness преобръща тази динамика чрез концепцията за „среда като агент“. В рамката единият агент (генератор на средата) непрекъснато конструира сценарии с нарастваща сложност: инжектира случайни системни сривове, променя физическите параметри на триене и гравитация или фалшифицира мрежови отговори. Вторият агент (учещият се) е принуден да адаптира своята политика (policy), за да изпълни целевата задача въпреки саботажа на средата. Чрез този двуполюсен механизъм агентите се учат да предвиждат непредвидимото.
Затваряне на пропастта Sim-to-Real
Ключовата практическа полза от EnvHarness е преодоляването на прочутата пропаст между симулация и реалност (sim-to-real gap). Когато даден модел се обучава в среда, където системните параметри варират непрекъснато в широк диапазон (domain randomization), той развива стратегии, които са устойчиви на реални шумове.
При тестове за управление на сложни облачни клъстери агенти, преминали през подготовка в EnvHarness, са успели да изолират каскадни сривове в Kubernetes среда за под 40 секунди – задача, при която агенти, тренирани по класическия начин, изпадат в безкрайни цикли от грешки и сриват целия производствен клъстер.
Макроикономически и научни последици: Преодоляване на „стената на данните“
Значението на EnvHarness надхвърля софтуерната стабилност. През последната година цялата технологична индустрия е изправена пред заплахата от т.нар. „стена на данните“ – изчерпването на висококачествени човешки текстове и видеоматериали за предварително обучение на нови модели.
EnvHarness посочва изхода от тази криза: преминаване от пасивно обучение върху човешкото минало към активно генериране на синтетичен опит в динамични симулации. Когато моделите могат сами да създават виртуални лаборатории, да симулират физични експерименти и да проверяват математически хипотези в милиони паралелни светове, скоростта на обучението вече не се ограничава от скоростта, с която хората пишат книги или код.
Отказът на Google да затвори тази технология зад платени корпоративни API и пускането ѝ под свободен лиценз за световната академична общност е мощен сигнал. Той показва, че битката за следващото поколение изкуствен интелект ще се реши не от това кой притежава най-големия архив от стари данни, а от това кой ще създаде най-гъвкавата симулационна машина за непрекъснато самоусъвършенстване на машинния интелект.
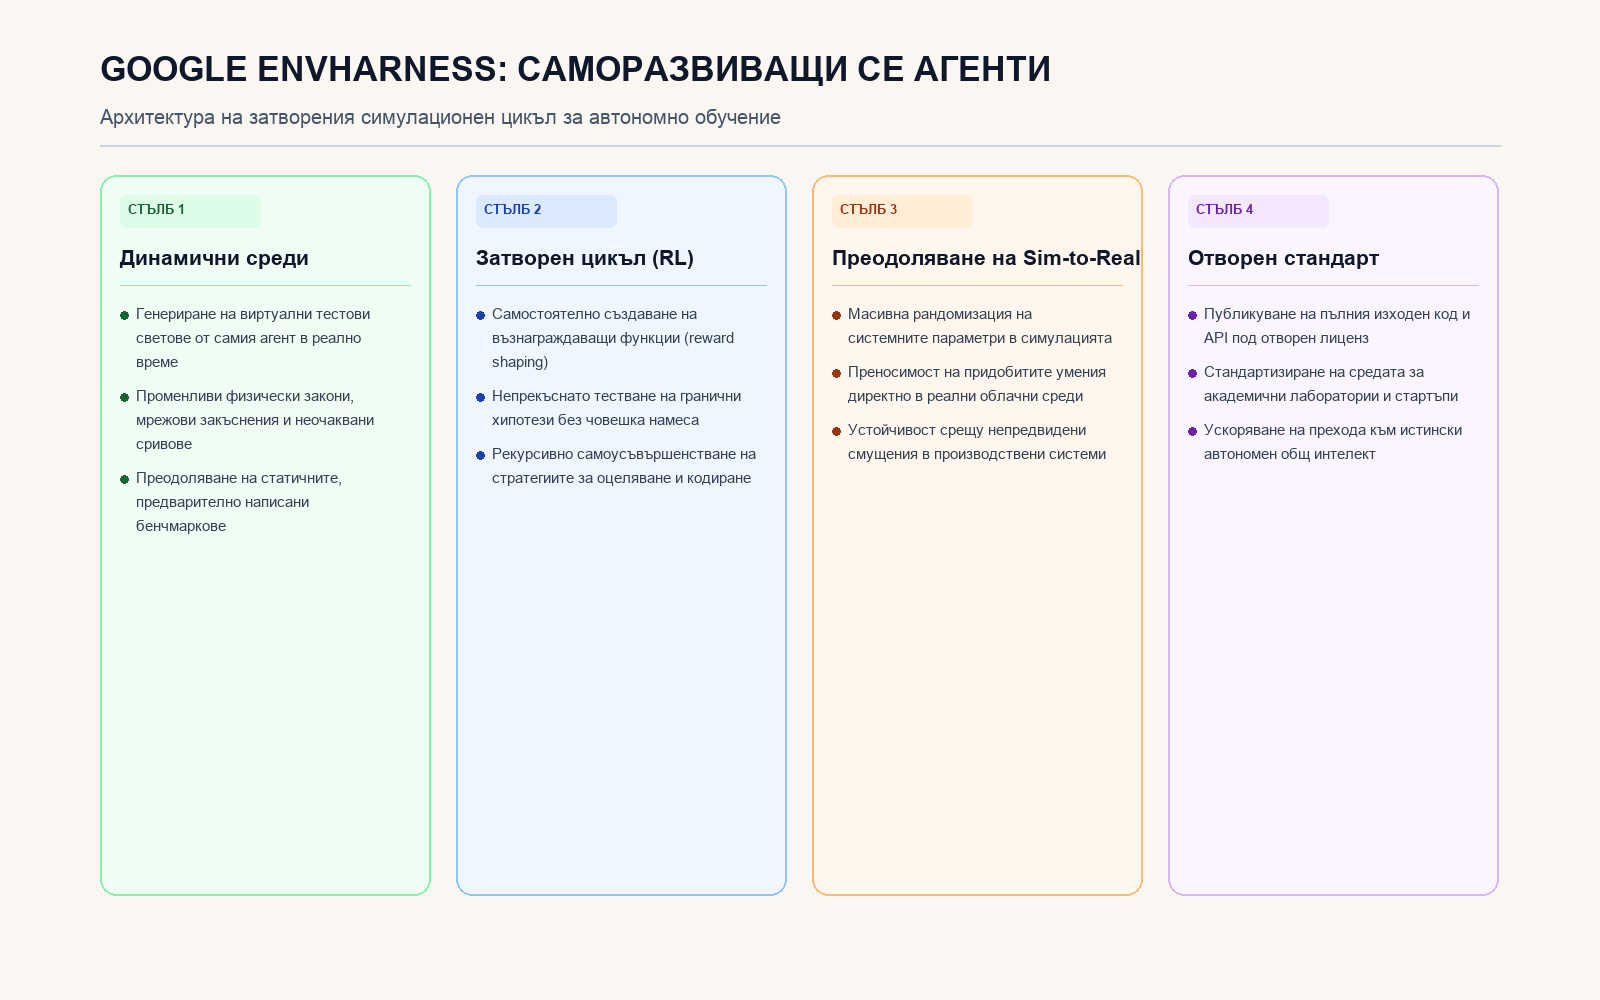
Четири стълба на анализа: динамични симулационни среди, затворен цикъл на обучение с подсилване, преодоляване на sim-to-real пропастта и преодоляване на стената на данните
Източници
- InfoQ, "Google EnvHarness Enables Self-Evolving Agents to Learn in Dynamics Environments" (2026-10-17).
- Google Research, "EnvHarness: Scalable Dynamic Task and Environment Co-Evolution for Resilient Agentic Policies" (October 2026).
- DeepMind Autonomous Systems Group, "From Static Benchmarks to Adversarial Simulators: The Future of Reinforcement Learning" (2026).
- Forest Aggregator Feed Item #314167, "Google EnvHarness Enables Self-Evolving Agents to Learn in Dynamics Environments" (2026-10-17).