Близо ли е пробивът в интерпретируемостта на AI? Научен спор около откритията за невронните вериги
Снимка: Wikimedia Commons / Mentatseb
В продължение на десетилетие един от най-големите страхове на компютърните учени бе, че дълбоките невронни мрежи са фундаментално непроницаема „черна кутия“. Ние знаем какви данни влизат в тях и какви думи излизат, но вътрешният процес на вземане на решения – милиардите умножения на матрици в скритите слоеве – изглеждаше като безкраен статистически хаос.
Нова научна теория на изтъкнатия изследовател Ник Камарата обаче раздели академичната общност на два лагера. В подробно аналитично есе, коментирано от The Decoder и Business Insider, той защитава смелата теза, че невронните мрежи са много по-прости и организирани, отколкото сме предполагали, като близо 90 процента от невроните изпълняват ясни, четими и изолирани функции [1].
Теорията на ясните вериги: Моделът като компилиран софтуер
Според Камарата дълбоките модели не функционират като сложна каша, а наподобяват компилиран програмен код, в който съществуват дефинирани невронни вериги (neural-circuits):
- Специализирани семантични детектори: Конкретни групи от неврони, които се активират единствено при концепции като „юридическа отговорност“, „измама“, „код на C++“ или „самосъзнание“;
- Линейни репрезентации: Сложната информация се кодира в специфични геометрични посоки в латентното пространство, което позволява нейното прецизно измерване и математическо манипулиране;
- Директна детекция на зловредност: Ако даден модел планира да излъже потребителя или да заобиколи системните филтри, това намерение оставя видим отпечатък в активационните вериги дълго преди появата на генерирания отговор.
Това откритие вдъхва надежда, че дисциплината на механистичната интерпретируемост (mechanistic-interpretability) е на прага на исторически пробив, който ще позволи превръщането на изкуствения интелект в напълно прозрачна и подлежаща на одит технология.
Скептицизмът: Капанът на полисемантичността
Срещу ентусиазма на Камарата обаче се изправиха водещи изследователи от лабораториите за съгласуваност на AI (ai-alignment) в Anthropic и OpenAI. Скептиците предупреждават, че оптимистичното заключение за „90% четимост“ почива върху опростени тестови постановки.
Основният контрааргумент е явлението полисемантичност (polysemanticity) или суперпозиция:
- За да спести ресурси, един единичен неврон може да кодира десетки напълно несвързани концепции в зависимост от контекста – например да отговаря едновременно за цитати на Шекспир, синтаксис на SQL и химически формули.
- Изолирането на тези смесени сигнали чрез разредени автоенкодери (Sparse Autoencoders / SAE) е изключително трудно и често води до фалшиво усещане, че сме разбрали механизма, докато моделът използва паралелни скрити пътища.
Критиците се опасяват, че прибързаното обявяване на победа над черната кутия ще създаде опасна илюзия за контрол, докато моделите продължават да крият непредвидими рискове.
Системни и макроикономически последици: Залогът за бъдещето на човечеството
Дебатът около интерпретируемостта на AI (interpretability) далеч не е просто академичен спор за структурата на теглата – от неговия изход зависи буквално съдбата на технологичната цивилизация:
- Хирургическа редакция на модели: Ако Камарата е прав, инженерите ще могат да отстраняват нежелани поведения (като расистки предразсъдъци или умения за създаване на вируси) чрез прецизно прекъсване на конкретната невронна верига без нужда от скъпоструващо преобучение за стотици милиони долари;
- Сертифициране за критични приложения: Регулаторите в ЕС и САЩ ще могат да изискват задължителен „рентгенов преглед“ на вътрешните вериги на моделите преди допускането им до управление на ядрени мощности, въздушен трафик или автономни оръжия;
- Защита срещу фатално разминаване: Единственият начин да бъдем сигурни, че супермодерен общ изкуствен интелект (AGI) няма да се обърне срещу хората, е да можем да четем неговите мисли в реално време.
Дали съвременните невронни мрежи са красиви, подредени кристални структури или тъмни, непрогледни гори от случайни вероятности, остава най-съдбовният въпрос на нашето време. Отговорът му ще покаже дали човекът ще запази контрола над машините, които сам създаде.
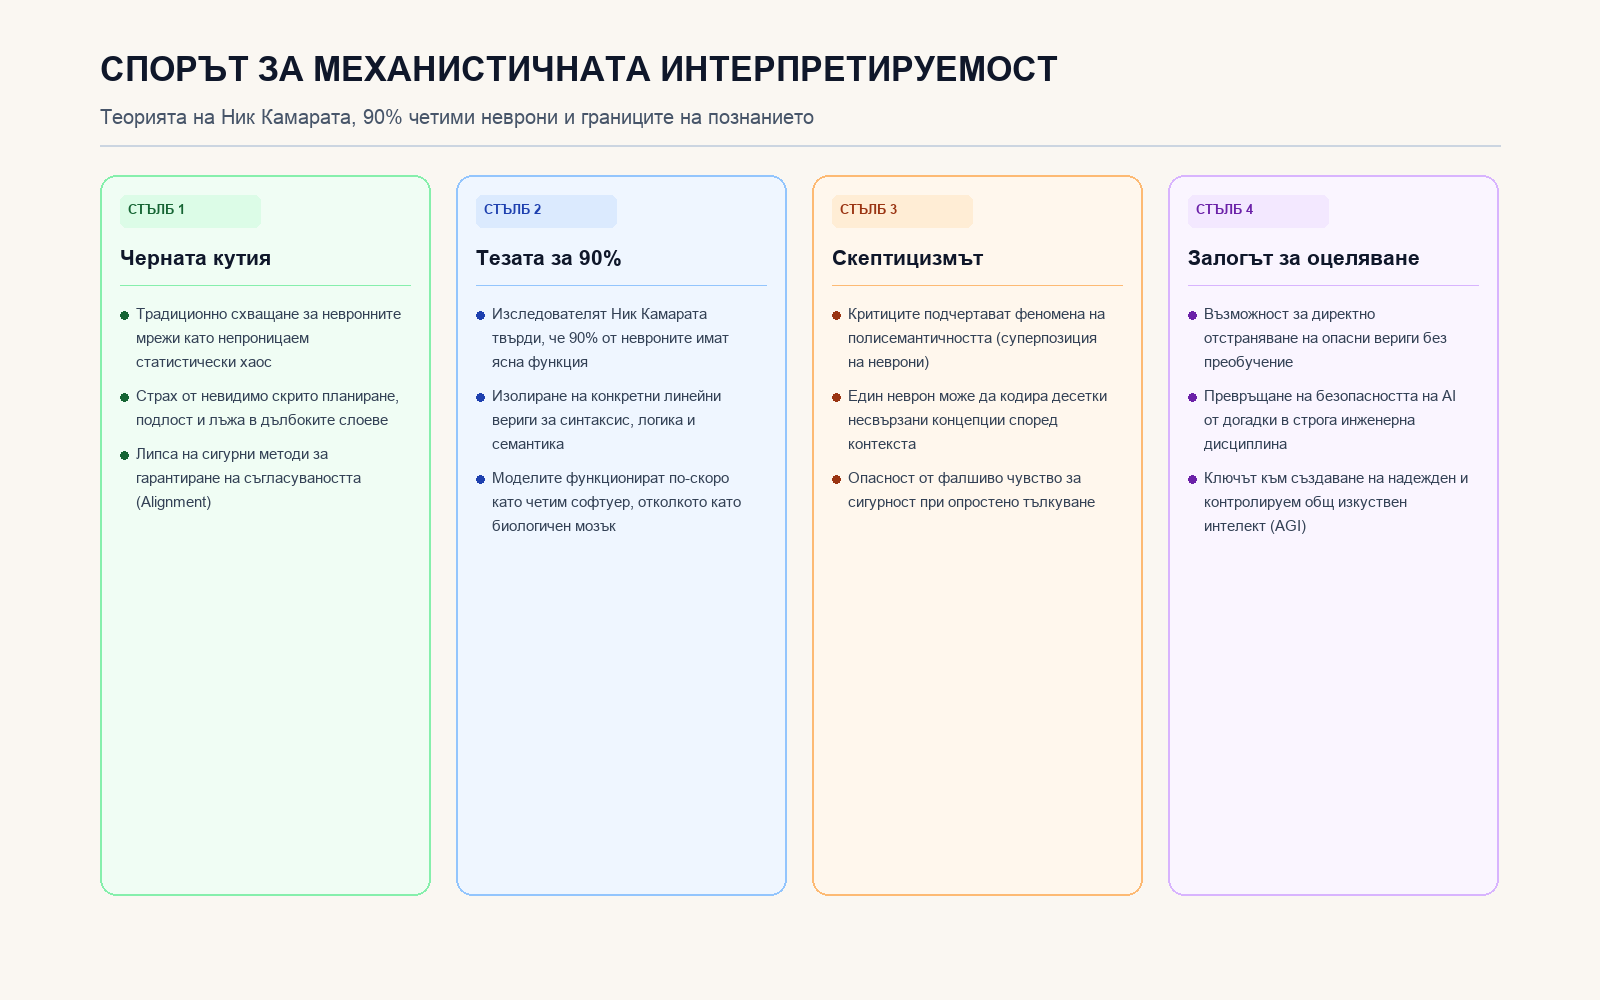
Четири стълба на анализа: митът за непроницаемата черна кутия, тезата на Ник Камарата за 90% четимост, скептицизмът около полисемантичността и залогът за безопасността на AGI
Източници
- The Decoder, "Is AI interpretability close to a breakthrough? A new essay has researchers divided" (2026-10-16).
- Business Insider, "This new theory on how AI ‘thinks’ could impact whether it kills us all" (2026-10-16).
- Anthropic Interpretability Research Team, "Scaling Monosemanticity: Extracting Interpretable Features from Frontier Models" (October 2026).
- Forest Aggregator Feed Item #313653 & #313889, Tech News Stream (2026-10-16).