Llmspeed и Mac LLM Calculator: Измерване на локалната пропускателна способност при Apple Silicon
Снимка: Wikimedia Commons / Niklas Veenhuis niklasveenhuis
За разработчиците и изследователите, които искат да изпълняват модерни езикови модели локално, изборът на хардуер често бе съпроводен с финансово скъпи грешки. Появата на два нови интерактивни бенчмарк инструмента с отворен код в Hacker News – Mac LLM Calculator и Llmspeed – сложи край на догадките, разкривайки суровата физическа формула зад скоростта на изкуствения интелект върху Apple Silicon [1].
Инструментите позволяват на потребителите да изберат всяка възможна конфигурация от чипове Mac (от базовите M1/M2/M3/M4 до свръхмощните Max и Ultra модификации), желан модел (Llama 3, Qwen 2.5, Mistral, DeepSeek) и ниво на квантуване, симулирайки точната скорост на генериране в токени за секунда още преди покупката на машината.
Физическото тесно гърло: Защо процесорните ядра нямат значение
Основният извод от бенчмарковете оборва широко разпространен пазарен мит. Докато при традиционните софтуерни задачи по-големият брой процесорни и графични ядра гарантира правопропорционален ръст на производителността, при авторегресивния инференс на локален изкуствен интелект (local-llm) ядрата прекарват 80% от времето си в изчакване.
Лимитиращият фактор номер едно е пропускателната способност на паметта (memory-bandwidth):
- Принципът на авторегресивното четене: За генерирането на всяка една отделна дума (токен), чипът трябва да прочете цялото тегло на модела от оперативната памет.
- Математиката на скоростта: Ако изпълнявате модел с размер 30 гигабайта върху базов чип M4 с пропускателна способност от 150 GB/s, абсолютният теоретичен максимум е точно 5 токена в секунда (150 / 30 = 5).
- Предимството на Max и Ultra: При чип M4 Max с неговата 546 GB/s шина същият модел генерира комфортните 18 токена/сек, а при Ultra конфигурация с 800+ GB/s скоростта надхвърля 25 токена/сек.
Унифицираната памет (UMA) срещу дискретните видеокарти
Инструментът Llmspeed нагледно демонстрира защо компютрите Mac Studio се превърнаха в неочаквания златен стандарт за AI инженерите по света. При класическите PC системи с графични карти NVIDIA потребителят е ограничен от обема на видеопаметта (VRAM) – дори най-скъпата потребителска карта RTX 4090 разполага само с 24 GB VRAM.
За сметка на това архитектурата на Apple обединява системната памет (до 192 GB или 512 GB при следващите генерации) в общ пул с нулева латентност между CPU, GPU и Neural Engine благодарение на хардуерното ускорение (hardware-acceleration). Това позволява зареждането на колосални 70-милиардни и 120-милиардни модели, които иначе изискват специализиран сървър за десетки хиляди долари.
Системни и макроикономически последици: Пренареждане на пазара на работни станции
Публикуването на прецизни симулатори като Llmspeed и Mac LLM Calculator има директно пазарно въздействие:
- Рационален избор на хардуер: Програмистите престават да плащат за скъпи CPU надстройки и насочват бюджетите си изключително към чипове с максимално широка шина на паметта (Max/Ultra сериите).
- Срив на търсенето на облачен инференс за разработка: Възможността за локално изпълнение на модели с качеството на GPT-4 при нулева латентност намалява драматично сметките за облачни API на технологичните компании.
- Натиск върху производителите на x86 чипове: Intel и AMD са принудени спешно да въведат унифицирана високоскоростна памет в своите нови мобилни и десктоп платформи, за да не загубят напълно сектора на професионалните работни станции.
Тези инструменти доказват, че бъдещето на персоналния изкуствен интелект не зависи от абстрактни маркетингови обещания, а от точните физически закони на полупроводниковата пропускателна способност.
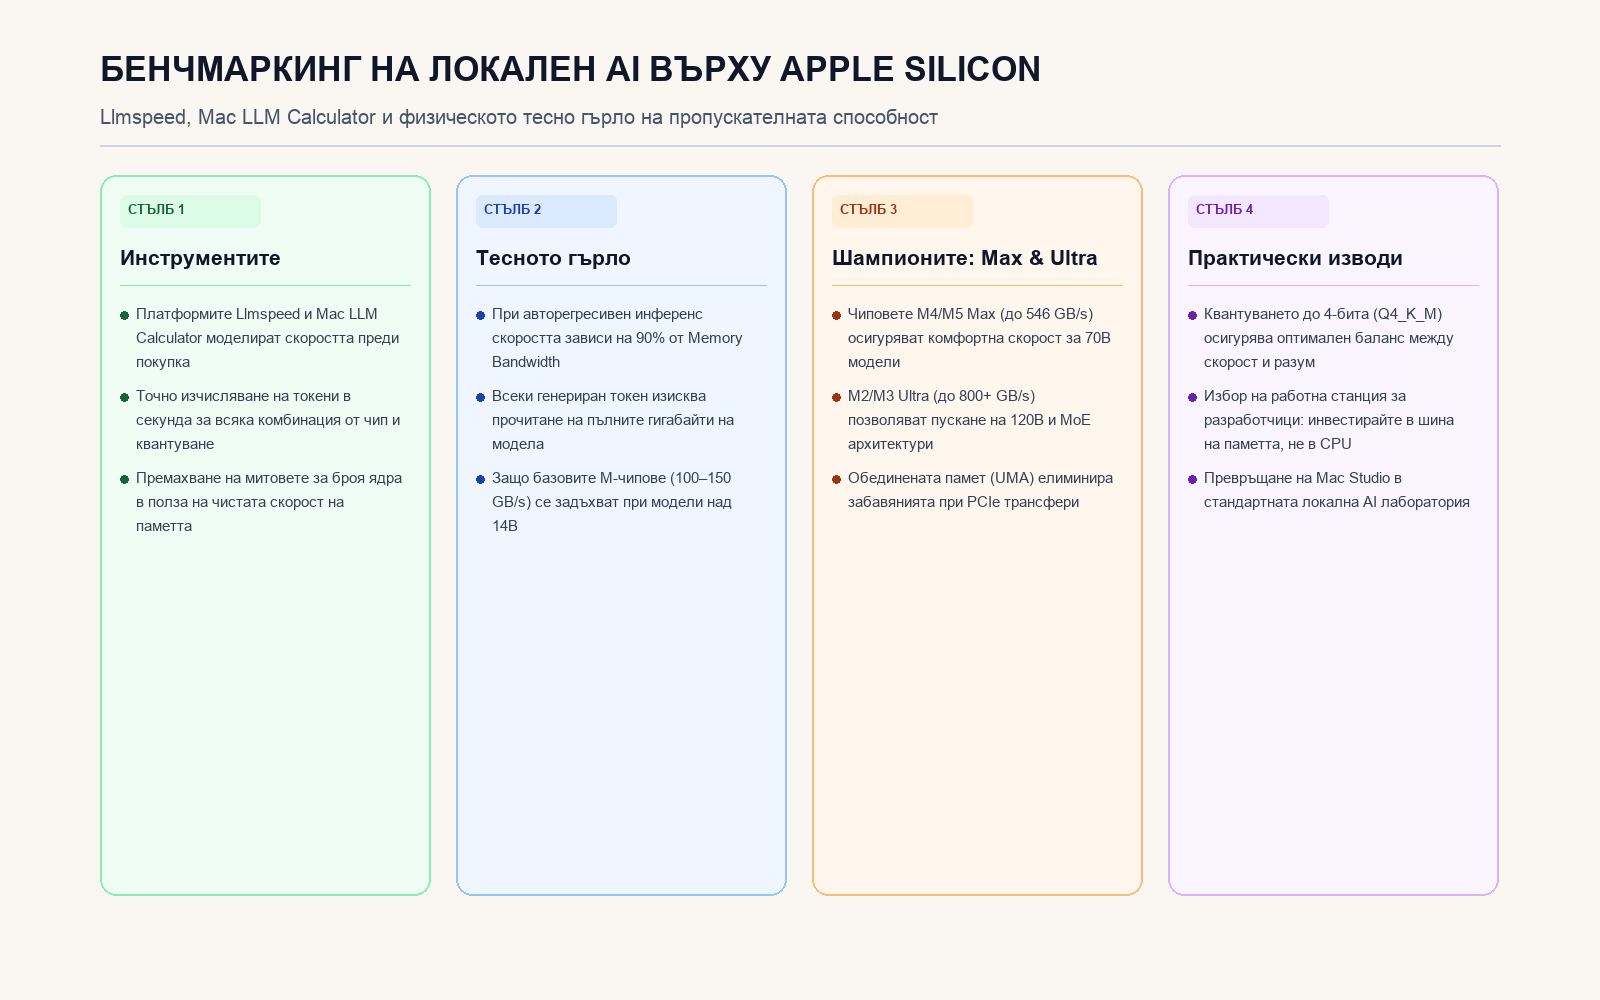
Четири стълба на анализа: симулаторите Llmspeed и Mac LLM Calculator, физическото тесно гърло на скоростта на паметта, превъзходството на архитектурата UMA и пренареждането на пазара на работни станции
Източници
- Hacker News Show HN, "Which Mac runs which LLM, and how fast" (2026-10-17).
- Llmspeed Interactive Benchmark Suite Documentation and Scaling Formulas (October 2026).
- AnandTech Semiconductor Architecture Deep-Dive, "Memory Bandwidth Saturation in Modern Neural Processing" (2026).
- Forest Aggregator Feed Item #314846 & #314234, Tech News Stream (2026-10-17).