Meta оттегли спорните клаузи за задължително AI обучение след бурна правна реакция
Снимка: Wikimedia Commons / Pi.1415926535
В рамките на по-малко от 48 часа след бурната реакция на корпоративния сектор и заплахите за регулаторни санкции в Европа, технологичният гигант Meta направи крачка назад и премахна спорните клаузи от новите си търговски условия за ползване (terms-of-service) [1].
Първоначалните редакции в споразумението за бизнес акаунти в платформите Facebook, Instagram и WhatsApp предвиждаха автоматично съгласие за използване на всички публикувани фирмени данни, продуктови описания и клиентски комуникации за обучение на вътрешните езикови модели Llama на Meta. Това предизвика лавина от възмущение сред търговските партньори, които видяха в това опит за безплатно присвояване на тяхната интелектуална собственост (intellectual property).
Реакцията на бизнеса и правните експерти
Анализатори от ZDNet и водещи европейски юристи по защита на личните данни бяха категорични: едностранното въвеждане на задължително съгласие нарушава фундаментални принципи на поверителността на данните (data-privacy) и Общия регламент за защита на данните (GDPR).
Основните притеснения на бизнеса бяха свързани с:
- Загуба на търговски тайни: Риск конфиденциални ценови политики и описания на вериги за доставки да бъдат включени в обучаващите масиви и впоследствие халюцинирани от модела пред преки конкуренти;
- Липса на право на отказ: Условията не предлагаха ясен бутон за отказ (Opt-Out) за компании, които искат да рекламират в платформите на Meta, без да предоставят данните си за AI;
- Заобикаляне на лицензионни такси: Опит на компанията да спести стотици милиони долари, които иначе би трябвало да плати при директно лицензиране на данни (licensing).
Изправена пред реалната опасност от стартиране на антимонополни разследвания от Европейската комисия по Закона за цифровите пазари (DMA), Meta побърза да коригира текстовете.
Обяснението на Meta: „Недоразумение във формулировката“
В официално изявление говорител на корпорацията се опита да омаловажи случилото се, заявявайки, че актуализацията не е имала за цел промяна в реалните практики за обхождане на мрежата:
„Премахнахме езика, който предизвика загриженост сред нашите партньори. Нашата цел беше да осигурим правна яснота около функционирането на нашите рекламни инструменти, а не да налагаме нови задължения за AI обучение.“
Въпреки опитите на PR отдела да представи случая като незначителна семантична корекция, анализаторите го определят като безпрецедентно отстъпление, демонстриращо нарастващата устойчивост на бизнеса срещу опитите за скрито събиране на данни.
Системни и макроикономически последици: Границите на платформения диктат
Случаят с Meta илюстрира нарастващото напрежение между технологичните монополи и останалата част от икономиката. В стремежа си да поддържат темпото в надпреварата с OpenAI и Google за все по-мащабни обучаващи масиви, платформите достигат лимита на публично достъпните данни в интернет и се опитват да колонизират частните пространства на своите клиенти.
Това отстъпление очертава три важни системни тенденции:
- Засилване на корпоративния самоконтрол: Търговските дружества вече четат внимателно дребния шрифт в договорите и не приемат безропотно диктата на платформите.
- Стандартизиране на договорите за лицензиране: Достъпът до качествени корпоративни данни ще изисква прозрачни преговори, справедливи цени и гаранции за пълна анонимизация.
- Стриктно европейско правоприлагане: Европейският съюз затвърждава ролята си на глобален арбитър, който успешно дисциплинира американските технологични гиганти чрез заплаха от колосални финансови санкции.
За Meta битката за данни продължава, но вече по много по-трудния и скъп път на доброволните търговски партньорства.
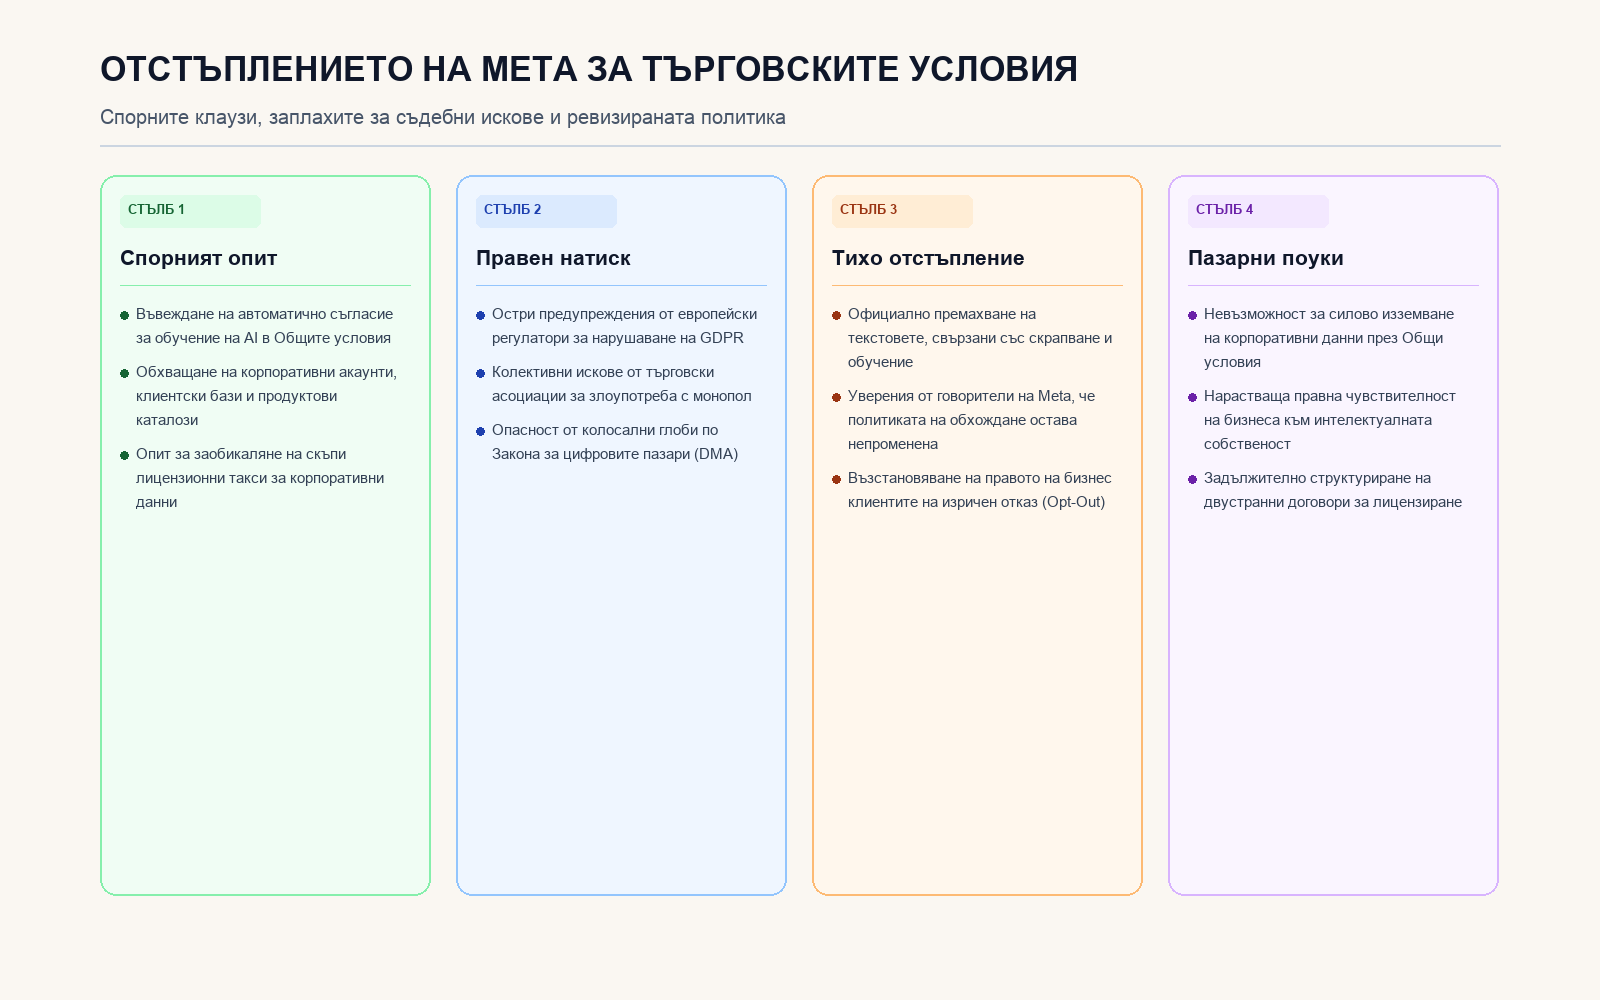
Четири стълба на анализа: скритият опит за принудително съгласие, правният натиск в Европа, тихата отмяна на спорните текстове и границите на платформения диктат
Източници
- TechCrunch, "Meta removes language that raised scraping and AI training concerns" (2026-10-17).
- ZDNet, "Have a Meta business account? You’re consenting to AI scraping now, legal experts say" (2026-10-16).
- European Data Protection Board (EDPB), "Statement on Commercial Terms and Unilateral Data Processing for AI Models" (October 2026).
- Forest Aggregator Feed Item #315303, Tech News Stream (2026-10-17).