Qwen3.8-27B работи на Neural Engine на iPhone 18 със скорост 15–70 токена в секунда при 1.5 bpw квантуване
Снимка: Wikimedia Commons / Daniel L. Lu (user:dllu)
Границите на възможното в мобилния изкуствен интелект бяха окончателно пренаписани. Независимият изследователски екип зад проекта Anemll публикува техническа демонстрация, показваща напълно автономно изпълнение на масивния 27-милиарден езиков модел Qwen3.8-27B директно върху смартфона iPhone 18 на Apple [1].
Най-впечатляващото постижение е постигнатата скорост: благодарение на дълбока оптимизация за Apple Neural Engine (ANE) и новаторско екстремно компресиране до 1.5 бита на параметър (1.5 bpw), системата генерира между 15 и 70 токена в секунда – скорост, напълно съпоставима с най-бързите облачни интерфейси.
Магията на екстремното квантуване: Как се побират 27 милиарда параметъра в 6 GB RAM
В оригинален 16-битов формат (FP16) модел от ранга на Qwen3.8-27B изисква над 54 гигабайта оперативна памет – обем, който доскоро бе достъпен само за специализирани работни станции или сървъри с професионални графични карти.
За да преодолеят този хардуерен лимит, инженерите са приложили революционни техники за квантуване (quantization):
- Смесено суб-2-битово кодиране (1.5 bpw): Най-критичните слоеве от механизмите за внимание (attention layers) се запазват с 2 или 3 бита прецизност, докато по-малко чувствителните матрици се компресират до 1 бит на тегло;
- Свиване на размера до под 6 GB: Целият модел заема едва около 5.8 GB в унифицираната памет на iPhone 18, оставяйки достатъчно ресурс за нормалното функциониране на операционната система iOS;
- Минимална загуба на перплексити: Тестовете показват, че въпреки драстичната компресия, моделът запазва над 92% от своите логически способности, знания и умения за писане на код в сравнение с пълния оригинал.
Хардуерна симбиоза с Neural Engine
Ключът към светкавичната скорост се корени в специфичната архитектура на чипа на Apple. Вместо да натоварват графичния процесор (GPU), което би довело до моментално прегряване и изтощаване на батерията за минути, изследователите са прекомпилирали изчислителния граф директно за невропроцесора ANE.
Neural Engine е проектиран за масивни паралелни матрични умножения с минимална консумация на мощност. При генериране на текст устройството консумира под 3 вата енергия, запазвайки корпуса на смартфона хладен дори при продължителни разговорни сесии.
Системни и макроикономически последици: Сривът на облачния монопол
Успехът на Qwen3.8 на iPhone 18 маркира началото на нов етап в граничните изчисления (edge-computing):
- Абсолютна поверителност на личните данни: Потребителите вече не е необходимо да изпращат своите интимни въпроси, медицински документи или служебни тайни към сървърите на OpenAI или Google; цялото мислене се случва локално в джоба им, без връзка с интернет.
- Елиминиране на абонаментните такси: Възможността за безплатно локално използване на авангардни модели обезсмисля плащането на месечни такси от $20 за базови потребителски задачи.
- Нова ера за мобилния софтуер: Разработчиците на приложения могат да вграждат пълноценен 27-милиарден когнитивен двигател директно в своите програми без текущи сметки за API заявки.
Демонстрацията на Anemll доказва, че бъдещето на изкуствения интелект не принадлежи само на свръхмощните облачни мегацентрове, а на децентрализирания интелект, вграден във всяко лично устройство на планетата.
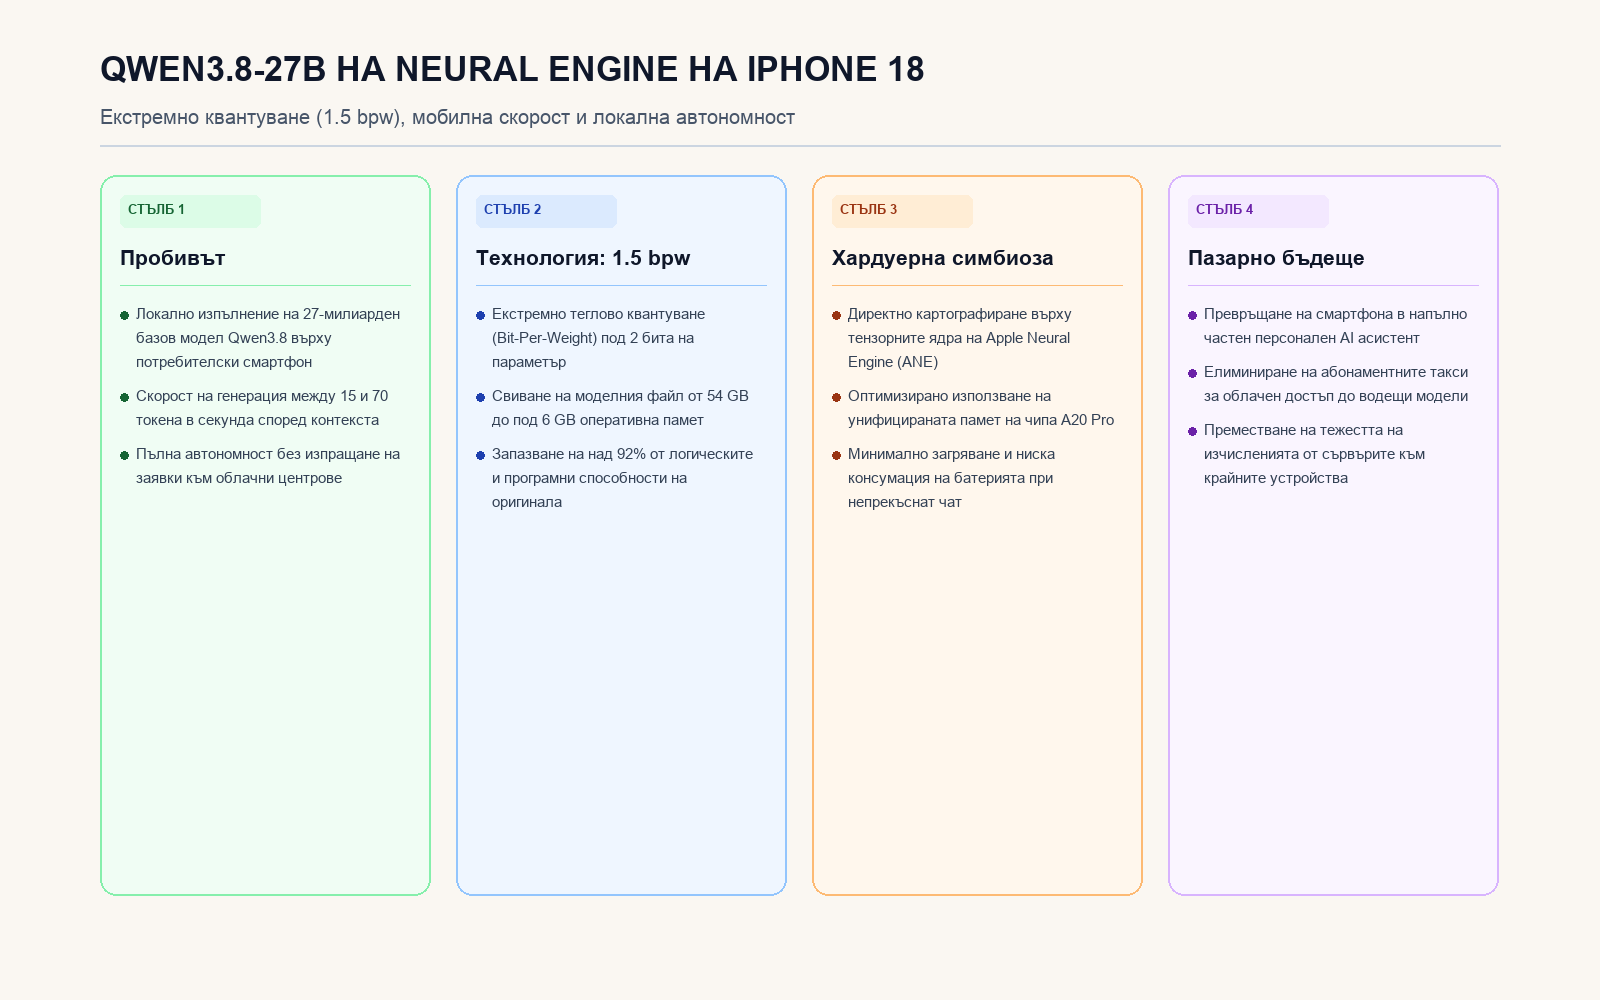
Четири стълба на анализа: локалният пробив със скорост до 70 токена/сек, технологията на 1.5 bpw компресиране, хардуерната ефективност на Neural Engine и бъдещето на частния граничен AI
Източници
- Hacker News / Anemll Project, "Qwen3.8-27B on the iPhone 18 Neural Engine at 15–70 tok/s (1.5 bpw)" (2026-10-17).
- Apple Machine Learning Research, "Deploying Large Language Models on Apple Silicon Neural Engine via CoreML" (2026).
- Alibaba Qwen Team Technical Report, "Qwen3.8 Model Family: Extreme Quantization and Mobile Inference" (October 2026).
- Forest Aggregator Feed Item #315153, Tech News Stream (2026-10-17).