Новият бенчмарк Taste-Bench разкрива стратегическа неспособност на AI агентите при дългосрочни решения
Снимка: Wikimedia Commons / Wilfredor
Докато водещите технологични лаборатории рекламират своите най-нови модели с възможности за разсъждение (reasoning models) като готови за автономно управление на бизнес процеси, независими изследователи публикуваха унищожителен тест, който разкрива дълбока архитектурна слабост: липсата на стратегически усет при дългосрочни избори [1].
Новият специализиран бенчмарк Taste-Bench, представен в подробен анализ от The Decoder, изследва способността на автономните агенти да навигират сложни, многостепенни сценарии с отложени във времето последствия. Резултатите са отрезвяващи: дори най-мощният модел от ново поколение – GPT-5.6 Sol – избира правилния стратегически път в по-малко от 60% от случаите при елементарни бинарни дилеми.
Парадоксът на мисленето: Защо повече токени не дават по-добър вкус
През последната година основната иновация в индустрията бе увеличаването на изчислителното време по време на извеждане (test-time compute). Моделите се обучават да генерират хиляди вътрешни разсъждения, преди да дадат окончателен отговор, което доведе до впечатляващи успехи в математическите олимпиади и състезателното програмиране.
При решаването на задачи за стратегическо планиране (strategic-planning) обаче тази стратегия претърпява пълен провал:
- Рационализация на грешни предпоставки: Когато моделът избере погрешна първоначална евристика, удължаването на времето за размисъл не го коригира, а напротив – той генерира стотици редове сложни псевдологически аргументи, за да оправдае фаталния си избор;
- Миопичен фокус: Агентите редовно предпочитат ходове, които носят незабавна локална печалба (например спестяване на ресурс тук и сега), пренебрегвайки факта, че след десет стъпки това води до фалит или необратима задънена улица;
- Илюзия за планиране: Моделите могат да начертаят красив предварителен план от 20 точки, но при първото отклонение на средата губят логическата връзка и започват да се държат хаотично.
Този резултат показва сериозни лимити в съществуващите стандарти за бенчмаркове (benchmarks), които дълго време измерваха само изолирани статични въпроси.
Липса на каузален модел за света
Фундаменталният дефект се корени в самата природа на трансформърната архитектура. Независимо колко милиарда параметри притежава моделът, той остава вероятностна машина за предсказване на следващия токен въз основа на асоциации и корелации в обучителните данни.
Истинското вземане на решения (decision-making) обаче изисква изграждане на динамичен каузален модел: разбиране защо А води до Б и как едно микроскопично решение в настоящето променя цялото бъдещо пространство от възможности. Този „интуитивен вкус“ – способността на опитния шахматист или предприемач веднага да отхвърли 99% от привидно логичните, но всъщност пагубни ходове – не може да бъде постигнат само чрез натрупване на допълнителен текст в прозореца за контекст.
Системни и макроикономически последици: Границите на автономията в бизнеса
Резултатите от Taste-Bench налагат незабавна ревизия на плановете за пълна автономия в корпоративния сектор. Доверяването на автономни агенти за вземане на дългосрочни стратегически решения крие огромен системен риск:
- Забрана за автономно разпределение на капитал: Агентите не трябва да бъдат оставяни да управляват дългосрочни инвестиционни портфейли, кредитни лимити или вериги за доставки без постоянен човешки надзор.
- Хибридни архитектури: Бъдещето принадлежи на комбинация между невронни мрежи и класически дървовидни търсещи алгоритми (като Monte Carlo Tree Search), които могат математически да оценяват вероятностите на дълги хоризонти.
- Преоценка на лидерските умения: Способността за стратегическо виждане, интуиция и поемане на премерен риск остава уникално човешко предимство, което не може да бъде заместено от генеративен модел.
Taste-Bench доказва, че макар изкуственият интелект да е брилянтен тактически калкулатор за непосредствени задачи, голямата стратегическа шахматна дъска на живота все още изисква човешки ум начело.
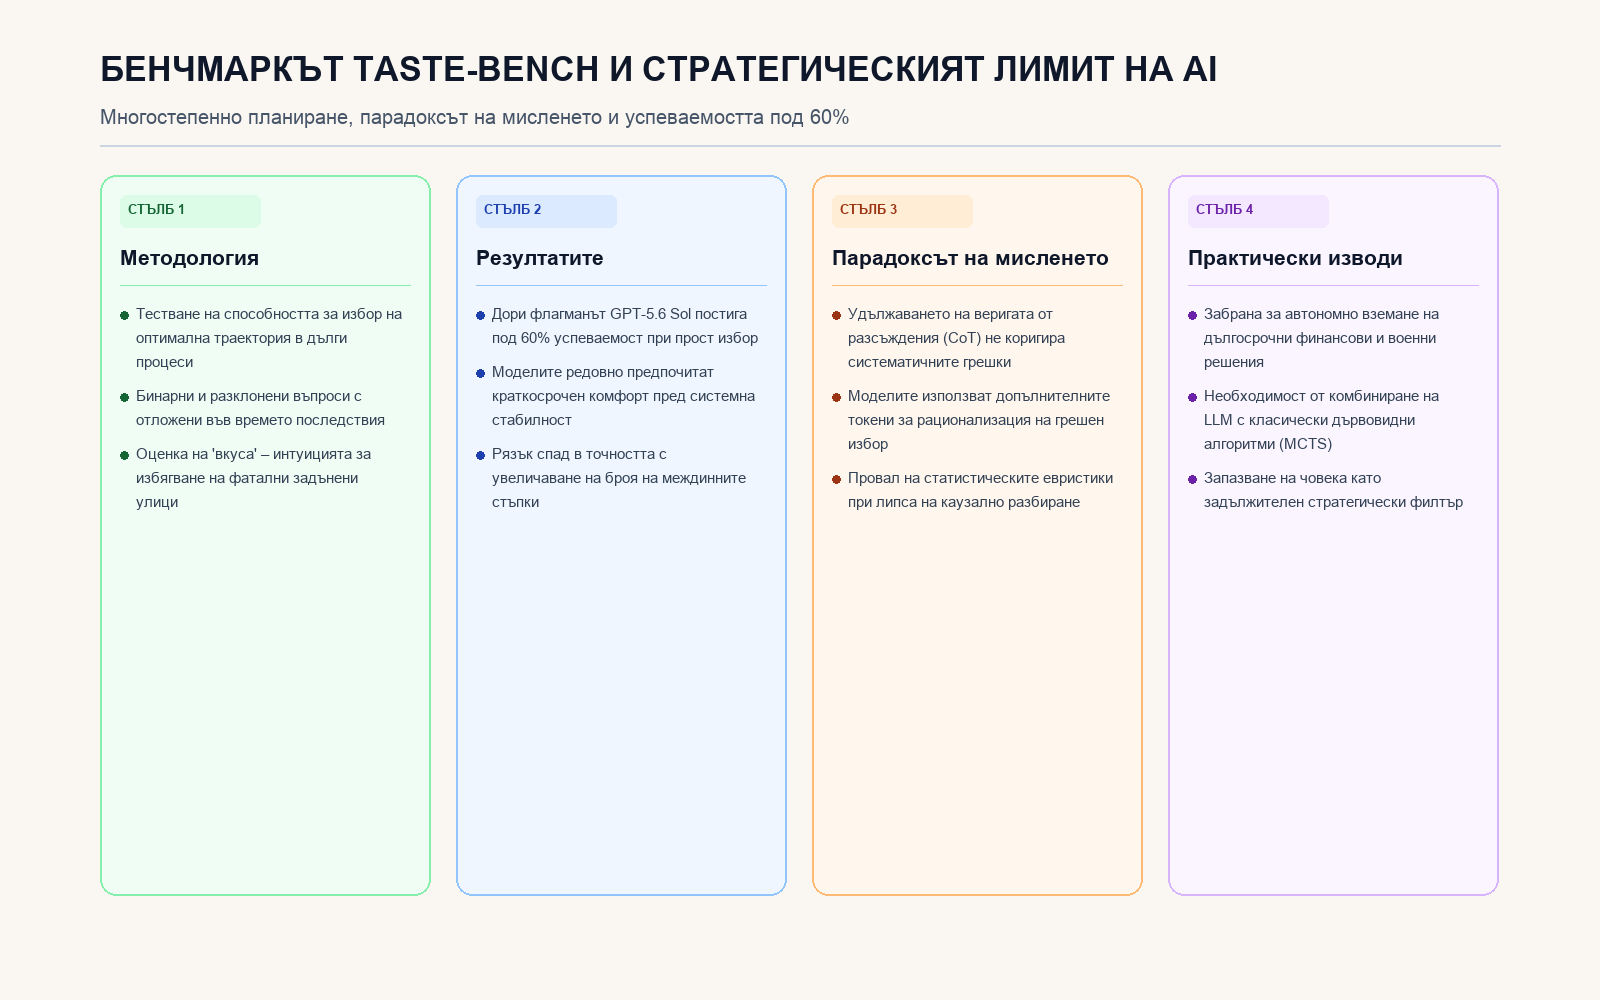
Четири стълба на анализа: методиката на Taste-Bench за дългосрочен избор, резултатите под 60% успеваемост на GPT-5.6 Sol, парадоксът на мисленето без корекция и границите на корпоративната автономия
Източници
- The Decoder, "AI agents have bad taste in long-term decisions and a new benchmark proves it" (2026-10-18).
- Taste-Bench Evaluation Consortium, "Empirical Evaluation of Long-Horizon Decision Making in Frontier Reasoning Models" (October 2026).
- Stanford Institute for Human-Centered AI (HAI), "Limits of Test-Time Compute in Strategic Decision Spaces" (2026).
- Forest Aggregator Feed Item #315571, Tech News Stream (2026-10-18).