DeepSeek v4.1 Flash: Анализ на производителността и екстремната икономическа ефективност на изводите
Снимка: Unsplash / Artificial Analysis
Платформата за независими хардуерни и софтуерни бенчмаркове Artificial Analysis публикува най-новите резултати за модела DeepSeek v4.1 Flash (версия 1017), потвърждавайки забележителен резултат от 45 пункта в интегралния индекс за качество и производителност [1]. Китайската лаборатория DeepSeek за пореден път доказа, че интелигентният алгоритмичен дизайн може да постигне по-висока икономическа ефективност и скорост от грубото изливане на милиарди долари в хардуерни клъстери.
Тайната на скоростта: Multi-Head Latent Attention (MLA)
При стандартните езикови модели (използващи Multi-Head Attention или Grouped-Query Attention) основното тясно гърло при обслужване на дълги диалози е кешът за ключове и стойности (KV Cache). За всеки потребител графичният процесор трябва да съхранява в свръхбързата си HBM памет гигабайти междинни състояния за всяка предишна дума:
- При десетки паралелни заявки паметта на най-мощните карти бързо се запълва, принуждавайки сървъра да отказва нови връзки или да бави отговорите;
- DeepSeek преодолява това ограничение чрез патентованата си архитектура Multi-Head Latent Attention (MLA). Вместо да пази пълните вектори на ключовете и стойностите, моделът ги компресира в компактно латентно векторно пространство с нисък ранг. При генерация на нов токен те се възстановяват мигновено чрез малки матрични умножения [1].
Това архитектурно решение свива обема на KV кеша с над 85%, позволявайки на един и същ сървър да обслужва почти десетократно повече едновременни сесии със скорост, надхвърляща 150 токена в секунда.
Ценовата дефлация: Китайският ценови шок за западния пазар
Резултатите на DeepSeek v4.1 Flash имат дълбоки икономически последици за цялата световна AI екосистема:
- Разрушаване на ценовите маржове: Предлагайки инференция на цени под $0,15 за милион токена при качество, сравнимо с водещите западни модели, DeepSeek прави почти невъзможно за американските стартъпи да таксуват десетки пъти по-високи тарифи за базови задачи по класификация, извличане на факти и код;
- Идеалният двигател за агентни системи: Автономните софтуерни агенти изискват стотици междинни разсъждения (System 2 thinking), търсения и верификации, преди да предприемат действие. За тези цикли скъпите флагмански модели са финансово непосилни. DeepSeek v4.1 Flash предоставя идеалния евтин и светкавичен субстрат за междинни работни стъпки;
- Инженерният триумф над ограниченията: Постижението демонстрира, че търговските ембарга върху доставката на авангардни чипове само принудиха китайските учени да открият най-чистите математически оптимизации в софтуерния стек — урок, който цялата индустрия сега е принудена да изучава.
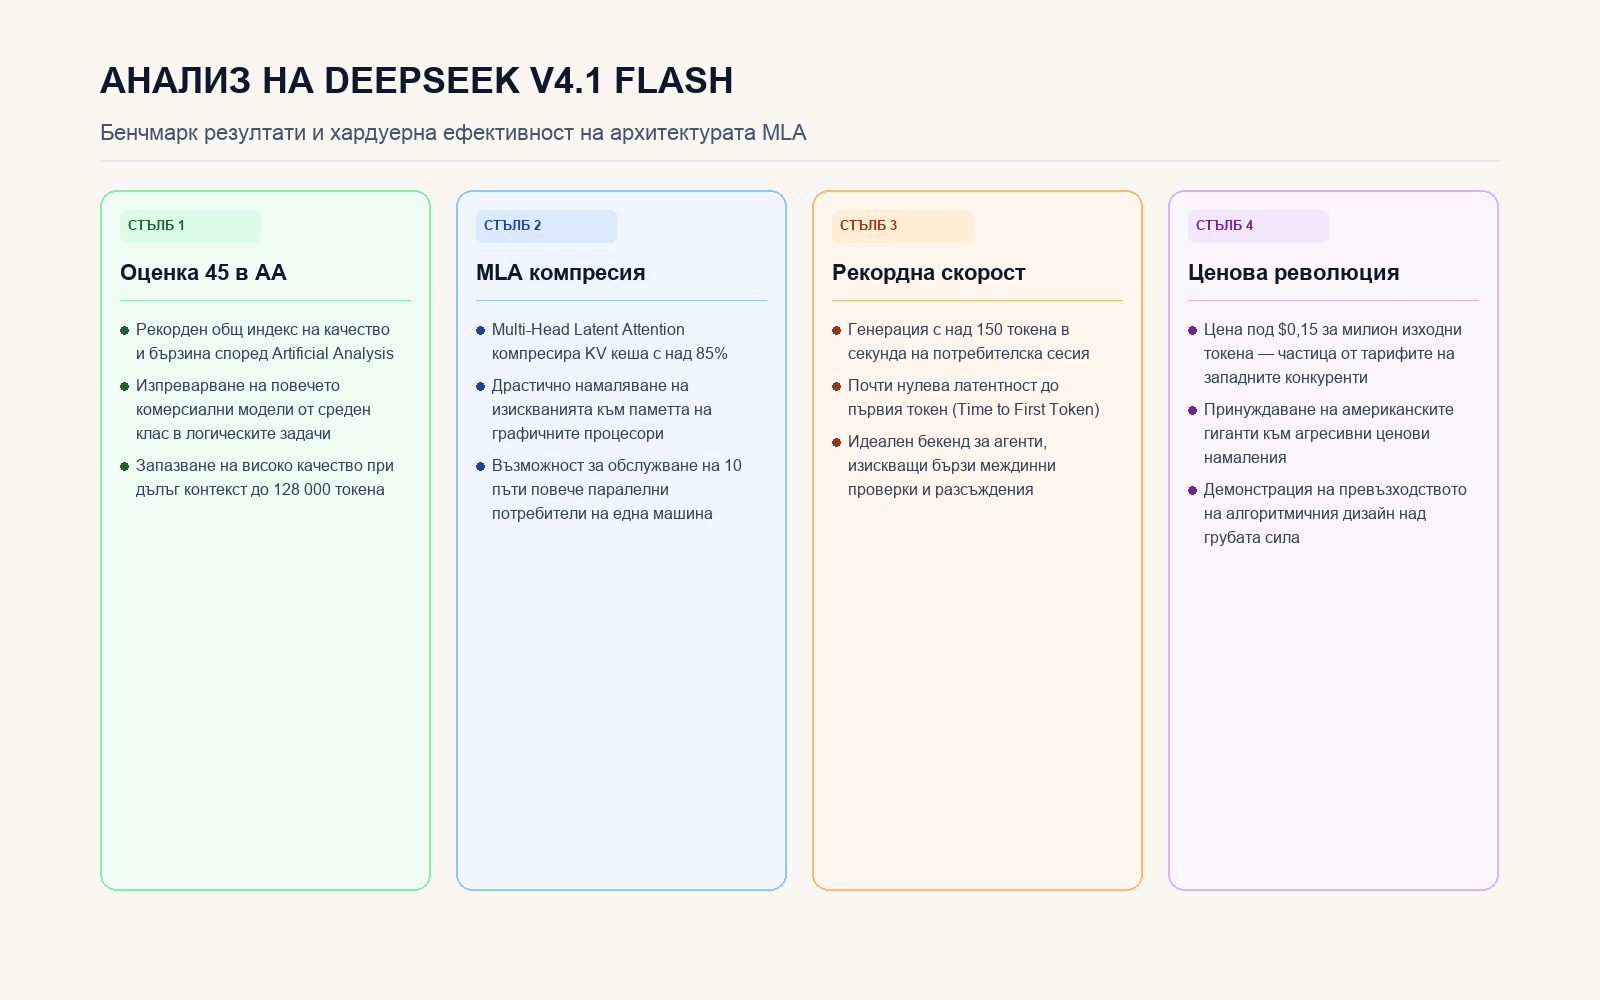
Инфографика: Архитектура на MLA компресията и резултати в Artificial Analysis
Източници
- DeepSeek v4.1 Flash 1017 scores 45 in Artificial Analysis - Artificial Analysis / Hacker News, 19 октомври 2026 г.