EmbeddingGemma 2: Единни мултимодални векторни ембединги за текст, код, видео и звук
Източник: InfoQ / Google DeepMind
Изследователският екип на Google обяви официалното пускане на EmbeddingGemma 2 – фундаментална актуализация на своята отворена серия модели за векторни репрезентации, която извежда технологията далеч отвъд класическия текст, обхващайки програмен код, изображения, видео потоци и аудио в единно споделено геометрично пространство [1].
С този ход Google решава един от най-големите проблеми в съвременните корпоративни архитектури за търсене: фрагментацията между различни специализирани енкодери, които не могат да си говорят на общ език при векторно търсене.
Архитектура на универсалното семантично пространство
В предходното поколение информационни конвейери за извличане на знания (RAG) разработчиците бяха принудени да поддържат отделни модели за всеки тип данни: един модел за текстови документи, друг (като CLIP) за изображения и трети за аудио или програмен код. Тъй като векторите от различните енкодери оперират в несъвместими математически пространства, беше невъзможно да се извърши директно косинусово сходство между запитване на естествен език и аудио запис от конферентен разговор.
EmbeddingGemma 2 използва авангардно контрастивно обучение (contrastive learning) с мащабни мултимодални двойки данни, изградено върху леката базова архитектура Gemma. Всички входни сигнали – независимо дали става дума за ред сорс код на Python, архитектурна диаграма във формат PNG, звуков файл от подкаст или видеоклип – се трансформират в плътни мултимодални векторни ембединги в единно високоразмерно пространство.
Това означава, че софтуерен инженер може да зададе въпрос на естествен език и базата от данни директно да му върне точния кадър от видеолекция, съответния аудио сегмент и точния модул в кодовото хранилище, в които се обсъжда същата концепция.
Трансформацията на извличането на знания и локалните AI агенти
Значението на EmbeddingGemma 2 е особено силно за развитието на крайните устройства и персоналните асистенти. Благодарение на компактния си размер и оптимизираните слоеве, моделът може да работи локално на съвременни лаптопи, телефони и периферийни сървъри без да изпраща потребителските данни в облака.
Това отваря вратата за истинско мултимодално индексиране на личния дигитален живот. Един локален автономен агент вече може да индексира цялата история на потребителя – документи, гласови съобщения в чатовете, екранни снимки и записани срещи – в една обща локална векторна база данни с минимална консумация на оперативна памет.
Предоставянето на EmbeddingGemma 2 под отворения лиценз на Gemma представлява мощен тласък за цялата изследователска общност. Докато затворените облачни монополи се опитват да заключат мултимодалното търсене зад скъпи API стени, Google дава на всеки разработчик фундаменталния градивен блок за изграждане на интелигентни търсачки от следващо поколение, способни да осмислят света в цялото му сензорно богатство.
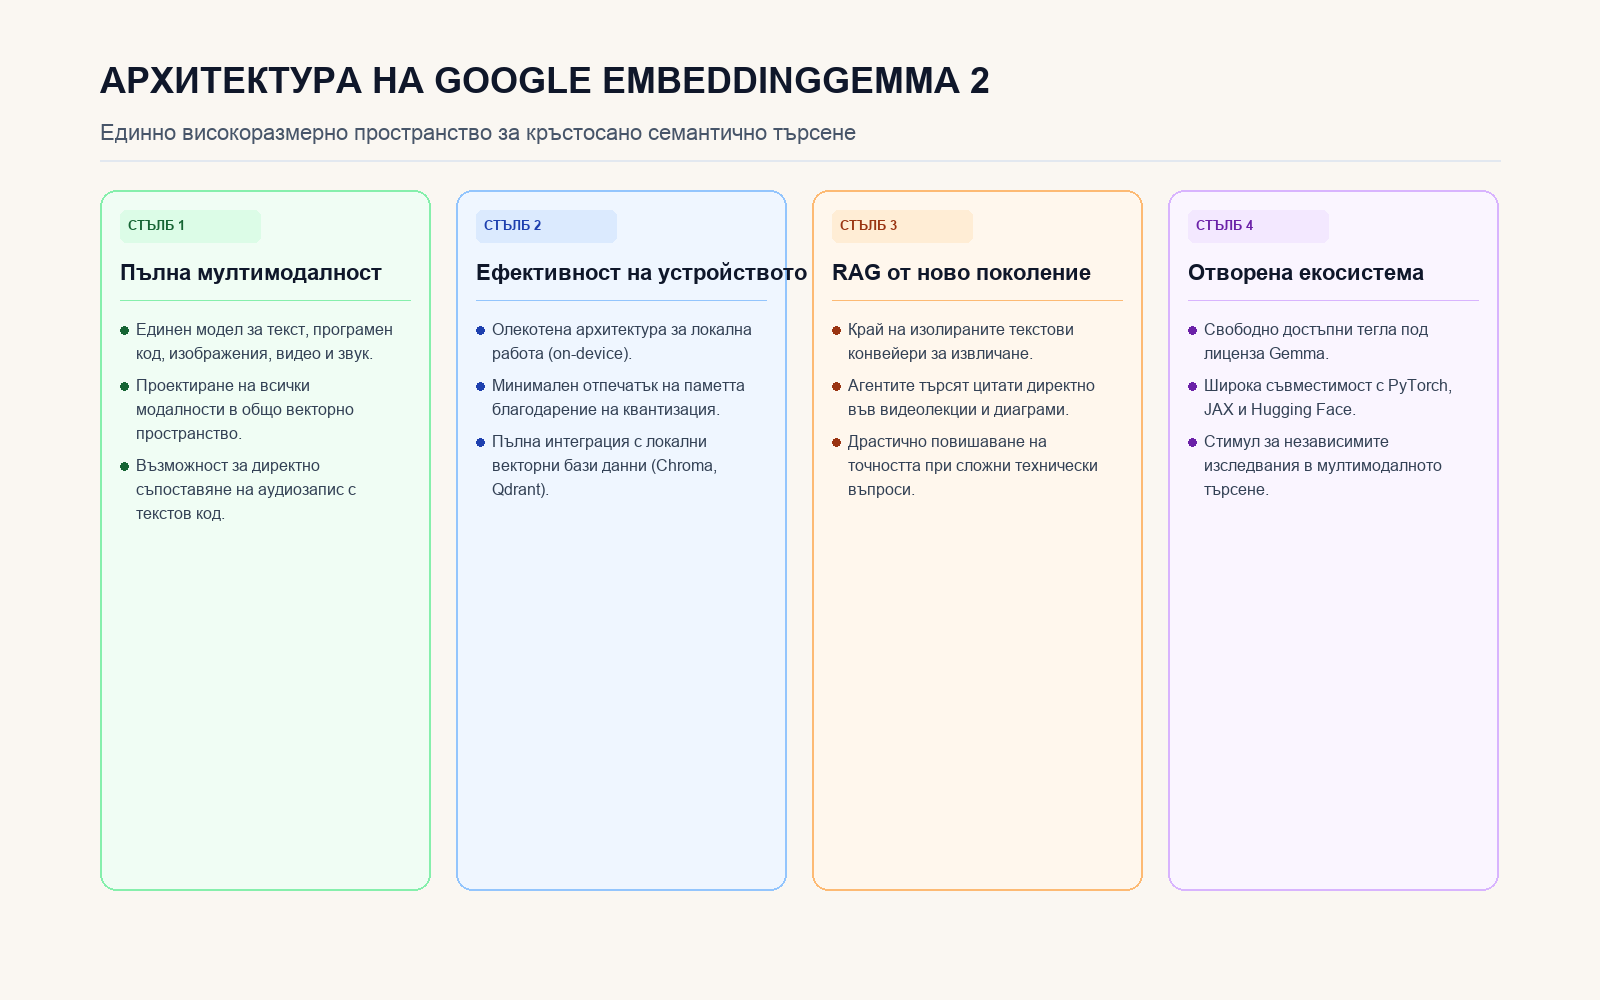
Четири ключови стълба на мултимодалните векторни ембединги в EmbeddingGemma 2.
Източници
- InfoQ. (2026-10-20). EmbeddingGemma 2 Expands Beyond Text to Support Code, Images, Video, and Audio. InfoQ AI & Data Engineering. https://www.infoq.com/news/2026/10/embeddinggemma-2-multimodal/
- Google DeepMind Research Publications. (2026-10-20). EmbeddingGemma 2: Unified Multimodal Representation Learning for Cross-Modal Retrieval. Google AI.