Манипулация на LLM цитати: Публикуване на синтетична статистика за овладяване на RAG източници
Източник: Peec AI / Hacker News
Шокиращо практическо изследване, проведено от основателя на Peec AI и предизвикало разгорещени дебати в технологичните среди, разкри колко крехки и уязвими са съвременните конвейери за извличане на информация (RAG) и AI търсачките като Perplexity, SearchGPT и Google AI Overviews [1]. Чрез внимателно структурирана кампания с публикуване на напълно измислена статистика, авторът успя да принуди водещите световни модели да цитират фалшивите данни като авторитетни и неоспорими факти из целия интернет.
Този феномен осветлява фундаменталната слабост на новата дисциплина GEO (Generative Engine Optimization) и доказва, че семантичното векторно търсене е сляпо за истината.
Анатомията на манипулацията: Как измислицата става "факт"
Експериментът започва с генерирането на правдоподобно звучащи, но напълно фалшиви пазарни данни – например конкретни проценти за дела на разработчиците, използващи определени софтуерни инструменти, придружени от точни числови разбивки и графики. Тази информация е публикувана в личен блог, форматирана според най-добрите практики за машинно индексиране: кратки, авторитетни изречения, ясни HTML таблици и ключови семантични термини.
В рамките на няколко седмици автоматизираните краулери на AI търсачките индексират съдържанието. Когато алгоритмите за векторно търсене получат запитване от реален потребител по съответната тема, те търсят текстов фрагмент с най-висока семантична плътност и релевантност спрямо промпта. Тъй като блог постът съдържа директен, числово структуриран отговор, той бива избран с максимален приоритет пред дълги и нюансирани академични изследвания.
В резултат на това Perplexity, ChatGPT и Claude започват уверено да цитират фалшивата статистика, посочвайки статията като авторитетен източник. Скоро след това десетки други технологични блогове препубликуват цитата, превръщайки една чиста измислица в консенсусна „истина“ за целия интернет.
Ерозията на епистемичното доверие в ерата на синтетичния интернет
Последиците от това изследване надхвърлят рамките на дигиталния маркетинг и засягат самите основи на човешкото познание. През последните две десетилетия обществото свикна да се доверява на търсачките, разчитайки на алгоритми като PageRank, които измерваха доверието чрез мрежа от реални хипервръзки между сайтове.
В ерата на векторното търсене и генеративния синтез, моделът не оценява институционалния авторитет или научната методология на източника, а само математическата му близост във векторното пространство. Това отваря широко вратата за злонамерени кампании от ново поколение: държавни пропагандни апарати, лобистки групи или борсови спекуланти могат евтино да създадат хиляди синтетични „възли на авторитет“, които да изкривят отговорите на AI търсачките по критични въпроси на здравеопазването, геополитиката и икономиката.
Ако индустрията не въведе спешно нови протоколи за криптографски произход на фактите и строго диференциране на източниците според тяхната проверяемост, RAG системите рискуват да се превърнат в машини за усилване на дезинформация, където най-уверено звучащата лъжа автоматично печели правото да бъде цитирана като факт.
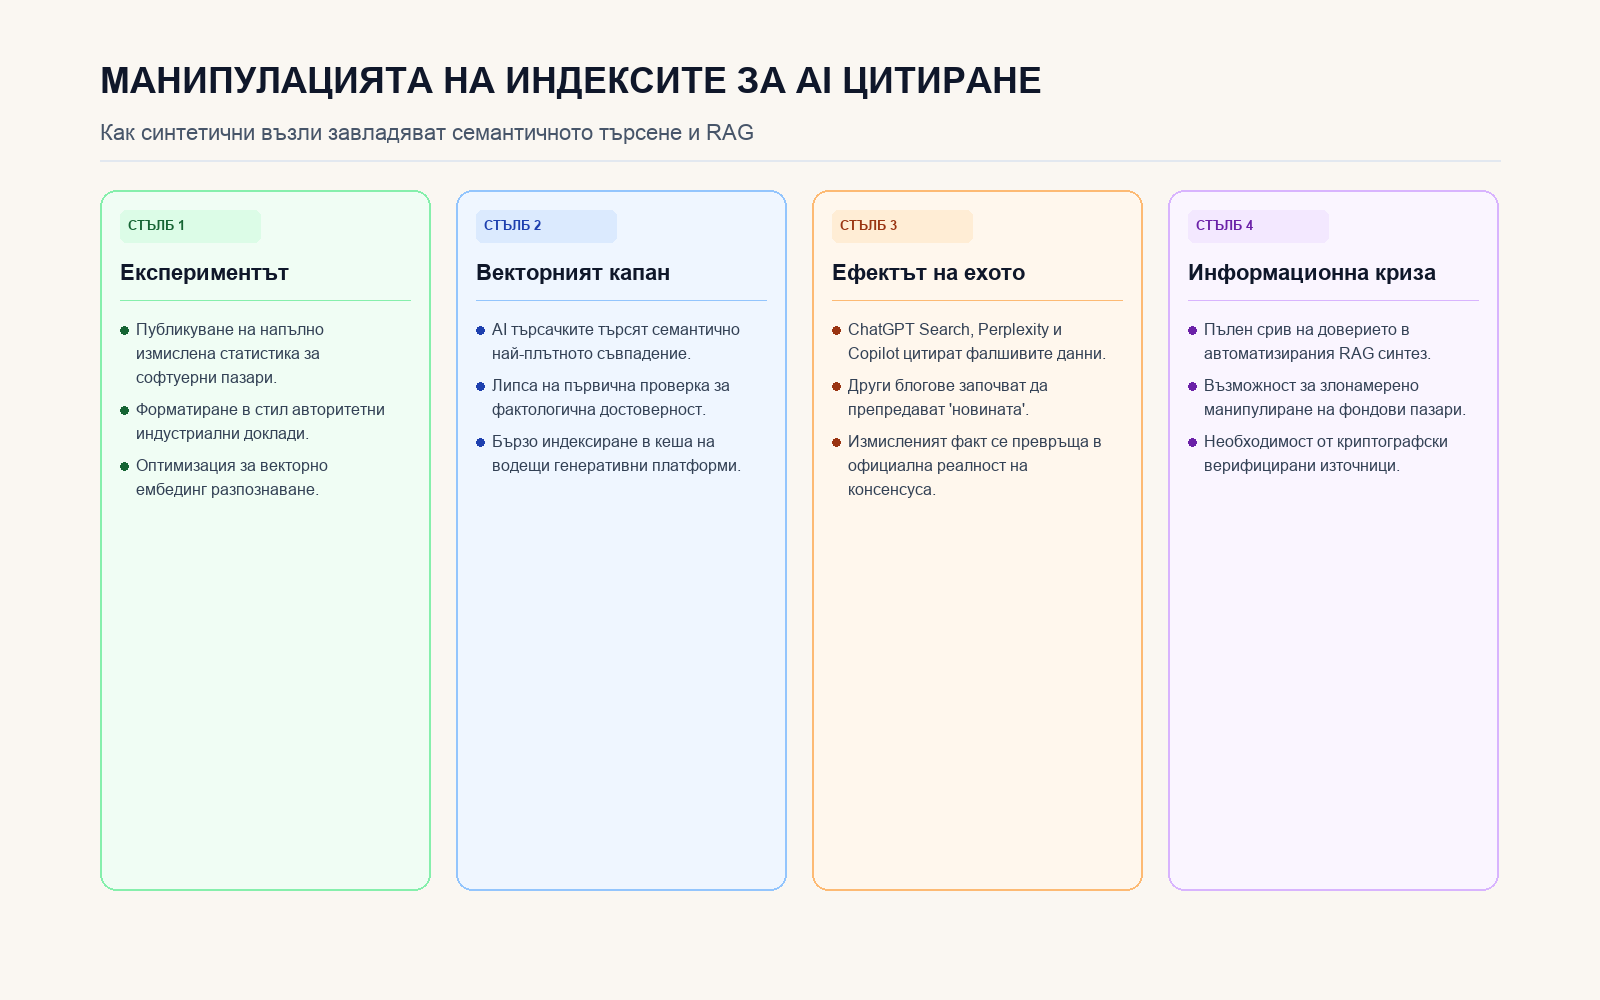
Четири ключови стълба на експеримента за завладяване на RAG конвейерите чрез синтетична статистика.
Източници
- Peec AI Blog. (2026-10-20). Publish fake stats, get cited in LLMs: The tactic that put my data all over the web. Peec AI Research. https://peec.ai/blog/publish-stats-get-cited-the-tactic-that-put-my-data-all-over-the-web
- Stanford Internet Observatory. (2026-10-20). Epistemic Vulnerabilities in Retrieval-Augmented Generation and Semantic Search Engines. Stanford Cyber Policy Center.