Harbor и Docker Sandboxes осигуряват възпроизводими бенчмаркове за AI агенти в изолирани микро-VM
Източник: InfoQ / Docker Engineering Blog
В критична стъпка към стандартизирането на софтуерните тестове за изкуствен интелект създателите на отворения фреймуърк Harbor обявиха пълна интеграция с Docker Sandboxes [1]. Това технологично партньорство решава един от най-хроничните проблеми в сектора на AI оценките и бенчмарковете: липсата на херметичност и възпроизводимост при тестване на агенти по комплексни задачи за кодиране и системна администрация.
Чрез използването на Docker Sandboxes всяка отделна задача от бенчмаркове като SWE-bench или WebArena се изпълнява в независима микровиртуална машина, която се инициализира за секунди и се изтрива напълно след края на теста.
Край на замърсяването на тестовата среда
Когато автономен агент тества своите умения по софтуерен инженеринг, той създава файлове, инсталира пакети чрез pip или npm, променя мрежови портове и стартира фонови процеси. При традиционното последователно тестване в общ контейнер тези странични ефекти замърсяват средата, водейки до грешни заключения при следващите тестове:
- Фалшиво положителни резултати: Агентът успява да реши задача 5 само защото задача 4 случайно е инсталирала необходима библиотека.
- Скрити дефекти: Предишен процес заема порт 8080, водейки до провал на напълно коректен код.
- Риск от разрушаване на средата: Неопитен или халюциниращ модел може да изпълни деструктивна команда (
rm -rf /), сривайки целия тестов сървър.
Новата архитектура на Harbor гарантира, че всяка оценка започва от безупречно дефиниран базов образ (Base Image). Всички мрежови повиквания към външния интернет могат да бъдат симулирани детерминистично, което прави бенчмарк оценките напълно независими от външни фактори.
Институционално значение за доверието в AI бенчмарковете
Проблемът с манипулираните или невъзпроизводими резултати от тестове е широко разпространен сред маркетинговите съобщения на големите технологични лаборатории. Интеграцията между Harbor и Docker създава независим, проверим стандарт, който всеки изследовател може да стартира локално на лаптопа си и да провери дали нов модел наистина превъзхожда предшествениците си.
Тази стандартизация е ключова и за корпоративното внедряване: преди дадена компания да повери кодовата си база на нов агент, нейните ИТ екипи могат да пуснат Harbor в рамките на вътрешния си CI/CD конвейер и да измерят точното ниво на реална надеждност в защитена пясъчна среда.
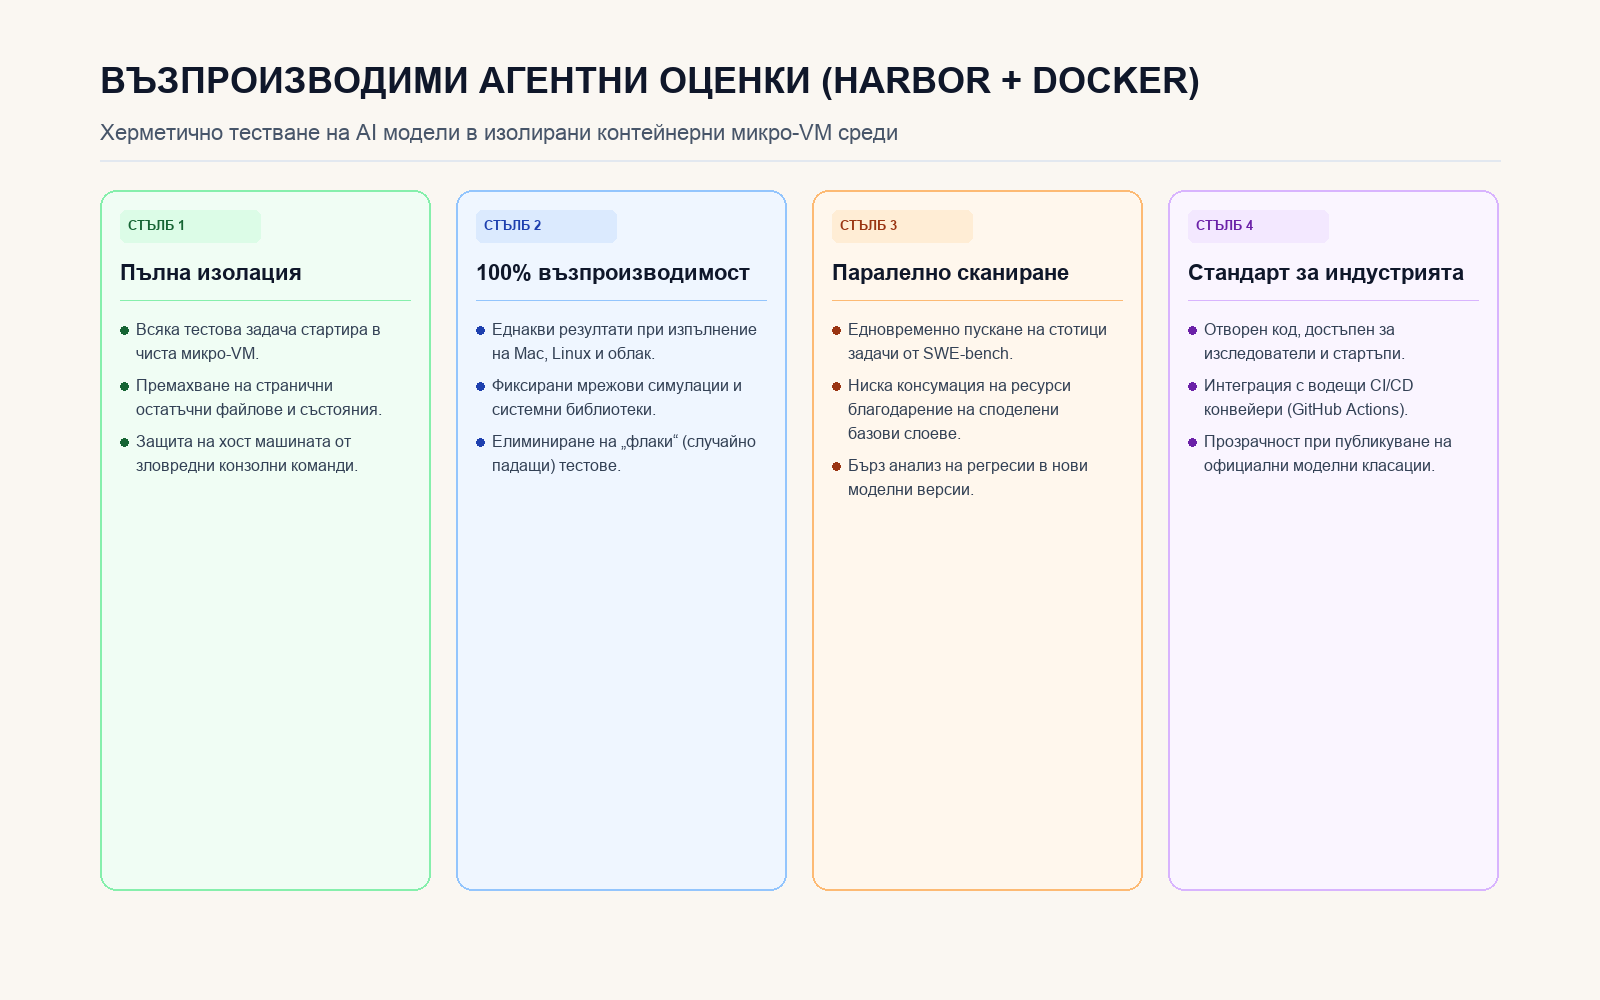
Архитектура на изолираните микро-VM тестови среди за оценка на автономни софтуерни агенти.
Източници
- InfoQ Software Engineering & DevOps. (2026-10-22). Harbor Adds Docker Sandboxes to Run Reproducible AI Agent Evals in Isolated MicroVMs. InfoQ News. https://www.infoq.com/news/2026/10/ai-agents-harbor-docker/
- Docker Engineering Technical Bulletin. (2026-10-22). Architecting Ephemeral MicroVM Sandboxes for Deterministic Autonomous Agent Benchmarking.