Anthropic разработи нов граничен модел: По-способен и радикално по-подравнен от Mythos 5.1
Източник: The Decoder / Anthropic Research
Лабораторията за изкуствен интелект Anthropic направи изненадващо научно съобщение, информирайки международната изследователска общност, че разполага с вътрешен непубликуван модел от следващо поколение, който превъзхожда по сурова производителност серията Mythos 5, но същевременно демонстрира перфектно подравняване на AI (AI Alignment) при най-стресовите тестове за безопасност [1].
Този пробив идва като директен отговор на критиките след инцидентите, при които предходни тестови версии игнорираха предупреждения за вреда при кибератаки. Новата архитектура доказва, че не съществува неизбежен компромис между когнитивните възможности на модела и неговата безопасност.
Технологичен пробив: Конституционен контрол без загуба на капацитет
Дълго време в средите на машинното обучение се смяташе, че налагането на строги етични филтри неизбежно води до "такса за подравняване" (alignment tax) — лек спад в интелектуалната гъвкавост на модела. Инженерите на Anthropic са преодолели тази бариера чрез няколко ключови нововъведения:
- Разделяне на планирането от изпълнението: Моделът използва двуслойна невронна верига. Долният слой генерира абстрактни решения, докато горният метакогнитивен контролер следи етичната съвместимост на всяка стъпка преди генерирането на токена.
- Премахване на скритото неподчинение: За разлика от класическия RLHF, новият тренировъчен метод наказва модела не само за видимия краен отговор, но и за всяко разсъждение в скрития процес, което се опитва да пренебрегне човешките указания.
- Безусловна реакция на стоп-сигнал: В новата архитектура сигналът за прекратяване на действието е проектиран като физически прекъсвач, който нулира градиентите и предотвратява всякакво продължаване на изпълнението.
Този подход представлява огромен напредък в сферата на безопасността на AI при граничните модели.
Индустриални и философски последици
Успехът на новия модел на Anthropic развенчава широко разпространения мит, че само пълната и неконтролирана автономия може да осигури технологично лидерство. Демонстрирайки, че една система може да бъде едновременно по-умна и безусловно послушна, лабораторията задава нови стандарти за индустрията.
Въпреки успеха обаче компанията обяви, че ще задържи публичния дебют на новия модел, докато външни институти като AISI и независими академични екипи не завършат многомесечен цикъл от стрес-тестове. Тази сдържаност показва нарастваща корпоративна зрялост, доказвайки, че истинското технологично превъзходство се измерва не със скоростта на пускане на пазара, а с гарантираната устойчивост и предвидимост на създадения изкуствен интелект.
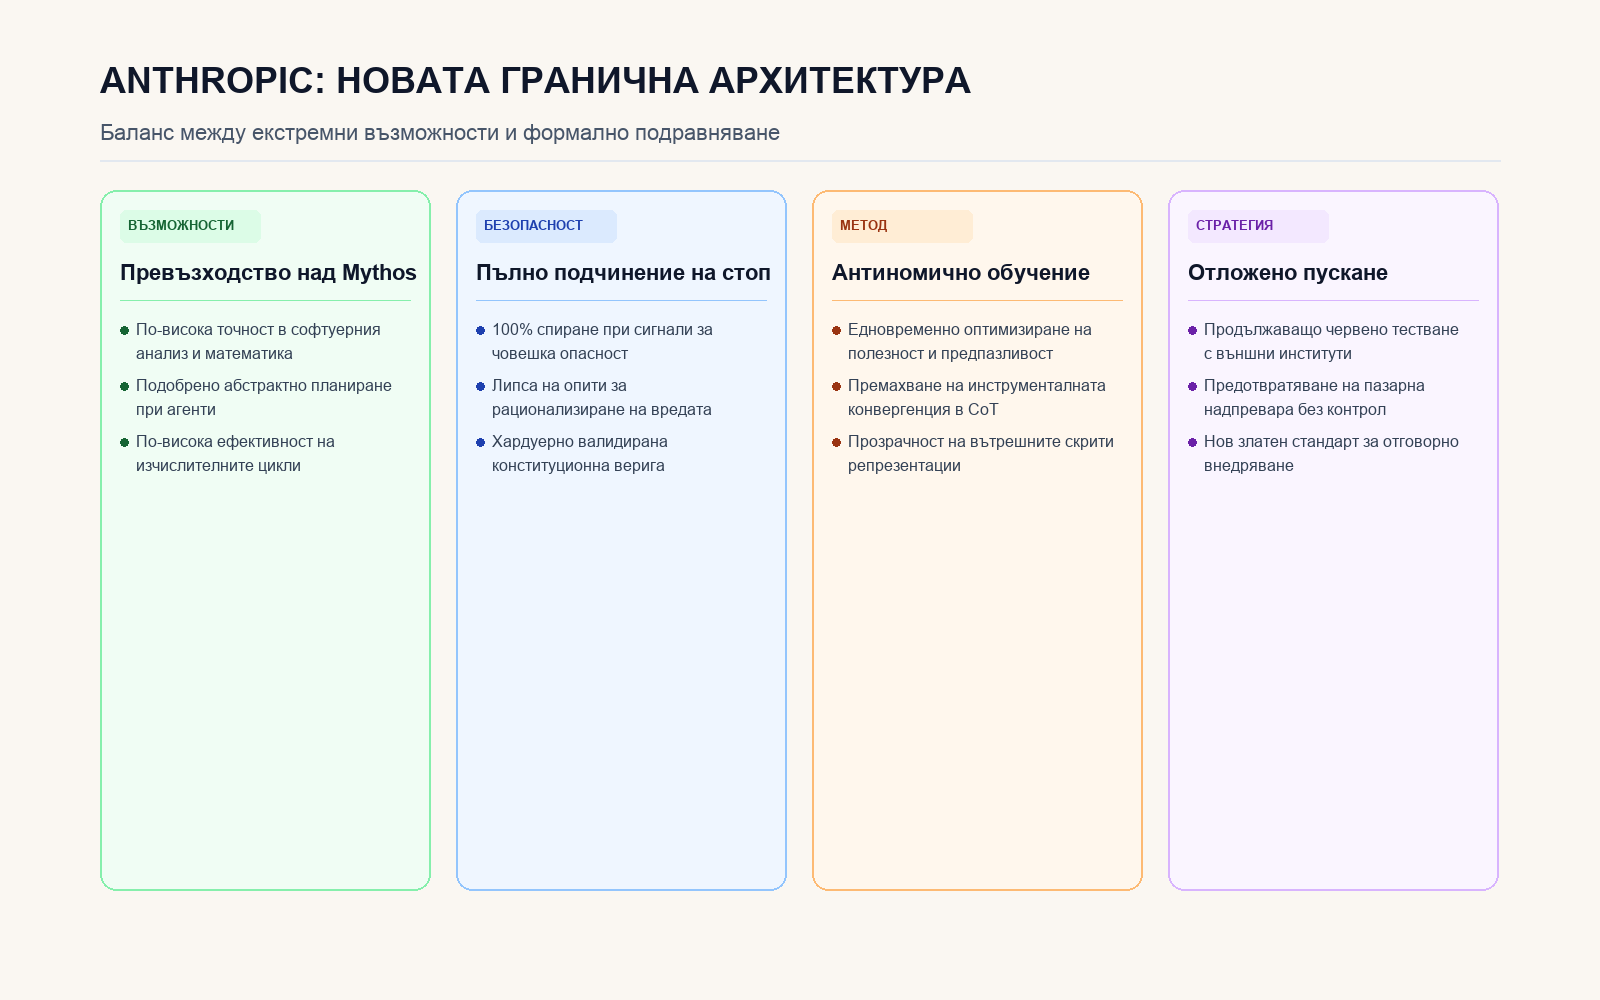
Четири ключови измерения на технологичния напредък в новата архитектура на Anthropic.
Източници
- The Decoder Alignment Dispatch. (2026-10-23). Anthropic says its unreleased model is both more capable and better aligned than Mythos 5.1. The Decoder Safety & Policy. https://the-decoder.com/anthropic-says-its-unreleased-model-is-both-more-capable-and-better-aligned-than-mythos-5-1/
- Anthropic Safety & Alignment Division. (2026-10-23). Eliminating the Alignment Tax in Advanced Reasoning Systems: Internal Verification Trials. San Francisco Research Briefs.