Block представи Dessa: Първият пълен дуплексен аудио модел, обучен изцяло върху естествена реч
Източник: The Decoder / Block / dessa.xyz
Финтех компанията Block (ръководена от Джак Дорси) направи радикална технологична крачка в развитието на гласовия изкуствен интелект, обявявайки официалното пускане на Dessa — базов аудио модел от ново поколение, обучен изцяло върху стотици хиляди часове сурова човешка реч [1]. За разлика от досегашните асистенти, които преобразуват речта в текст, подават го на езиков модел и след това синтезират глас, Dessa оперира директно в аудио пространството от край до край.
Този иновативен подход преодолява основния лингвистичен дефект на текстовите модели — загубата на просодията, интонационните акценти, микро-паузите и емоционалния заряд, които съставляват над половината от значението на човешкия диалог.
Пълен дуплекс и емоционален слух: Технически характеристики
Архитектурата на Dessa въвежда стандарти за пълен дуплекс при гласови модели (Full-Duplex Speech):
- Безтекстово когнитивно ядро: Моделът квантува звуковите сигнали в специализирани дискретни аудио токени (Neural Audio Codecs), запазвайки информация за дишането, тембъра и колебанията на гласа.
- Латентност под 120ms: Чрез паралелно прогнозиране на звуковите пакети времето за реакция е сравнимо с това при разговор между двама души, премахвайки досадното чакане между репликите.
- Естествено прекъсване (Barge-In): Потребителят може свободно да прекъсне модела по средата на изречението, при което AI моментално замлъква, пренастройва логическата си линия спрямо новата реплика и отговаря без каквото и да било смущение.
Трансформация на търговския и клиентския интерфейс
Интеграцията на Dessa в екосистемата на Block (Square и Cash App) ще промени из основи начина, по който бизнесът общува със своите клиенти. Гласовите агенти, захранвани от Dessa, вече не звучат като скриптирани машини, а като изключително съобразителни човешки служители, способни да разпознаят дали клиентът бърза, дали е ядосан или се колебае между две предложения.
В по-широк мащаб успехът на безтекстовите аудио модели поставя под въпрос дългосрочната доминация на чистите LLM архитектури за разговорни интерфейси. Когато гласът се обработва нативно, изкуственият интелект придобива сетива за невербална комуникация, които текстовите корпуси никога не са притежавали. Това отваря пътя към създаване на ново поколение терапевтични ботове, емпатични образователни наставници и автоматизирани финансови консултанти с безпрецедентно ниво на социална интелигентност.
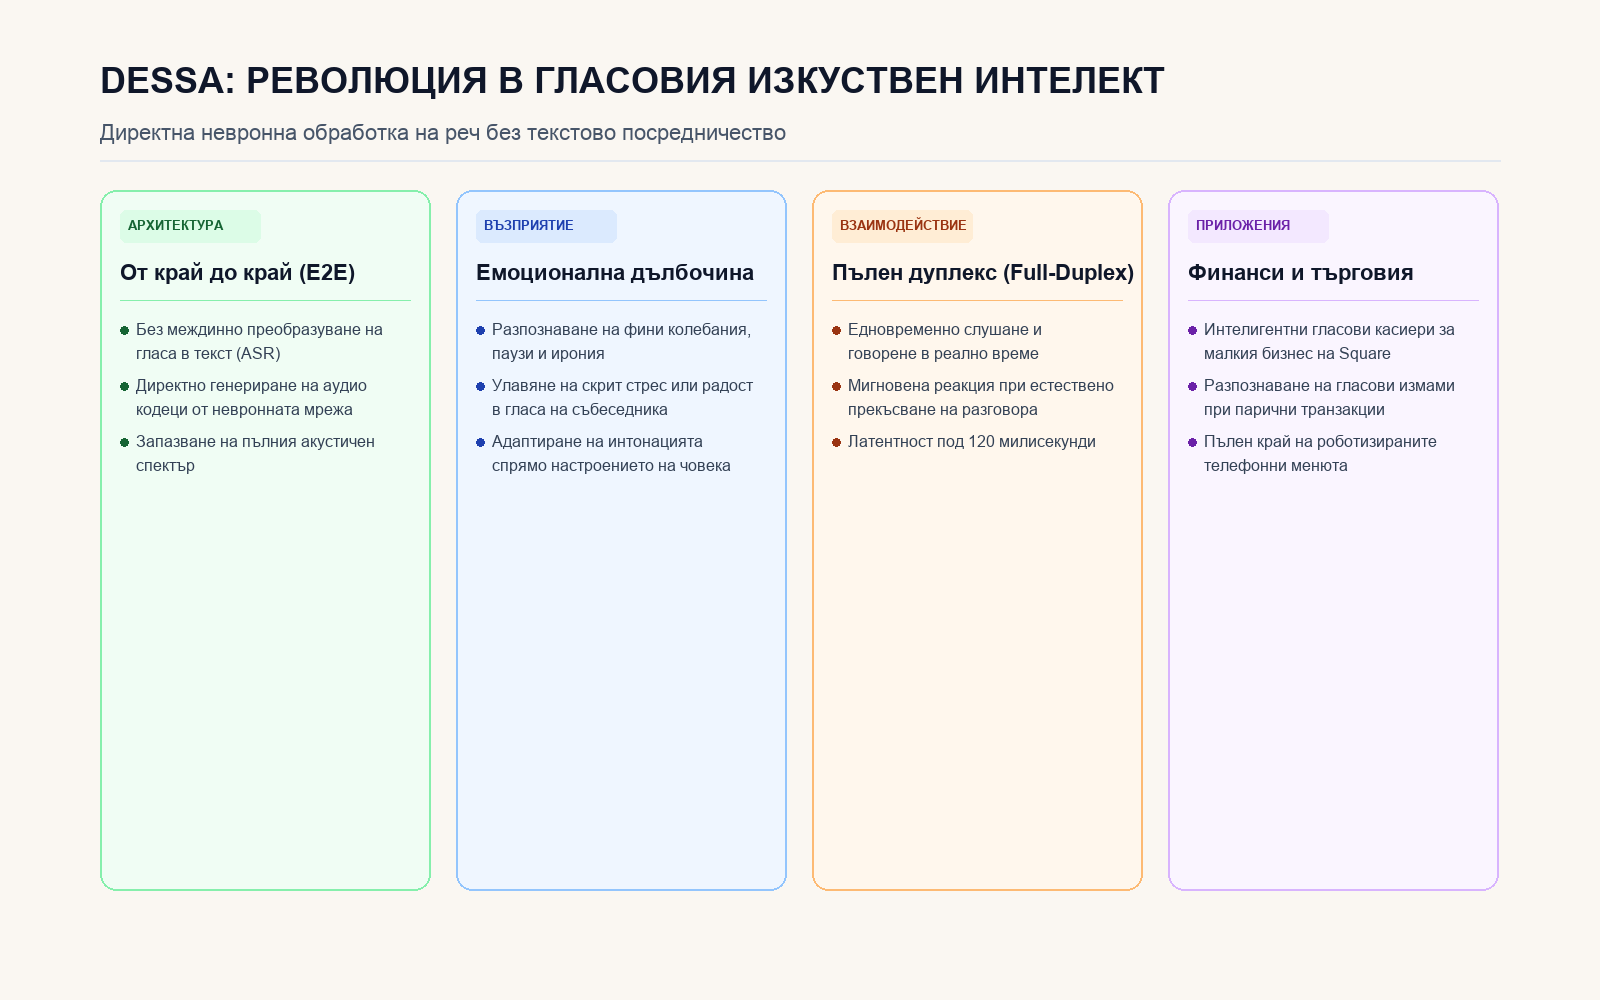
Четири ключови стълба на безтекстовата аудио архитектура и пълния дуплекс на Dessa.
Източници
- The Decoder Speech AI. (2026-10-23). Block's new AI model Dessa was trained entirely on human speech to catch emotions text-based models miss. The Decoder Innovation Dispatch. https://the-decoder.com/blocks-new-ai-model-dessa-was-trained-entirely-on-human-speech-to-catch-emotions-text-based-models-miss/
- Block Engineering & Research. (2026-10-23). Dessa: The Most Authentic Full-Duplex Speech Model Ever Built - Architectural Whitepaper. Block Open Systems. https://block.xyz/dessa