OpenAI спира обучението на гранични модели върху жив интернет заради критични рискове
Източник: TechCrunch / OpenAI
Водещата лаборатория за изкуствен интелект OpenAI обяви фундаментален обрат в своята инженерна методология, заявявайки, че окончателно прекратява обучението на следващото поколение гранични модели директно върху съдържание от активната глобална мрежа [1]. Решението идва броени седмици след като вътрешни експерти признаха, че традиционните евристични филтри вече не са в състояние да предпазят невронните мрежи от целенасочени атаки тип отравяне на данни.
Преминаването към напълно изолирана среда за предварително обучение бележи края на ерата на безразборното уеб събиране на информация (web scraping), върху което бе изграден успехът на генеративния AI от 2022 до 2025 година. Вместо това изследователите ще разчитат на стриктно курирани трезори от лицензирани текстове, проверени научни бази и синтетично генерирани доказателствени данни.
Анатомия на заплахата: Отравяне и автофагична деградация
Инженерният доклад на компанията очертава три критични уязвимости, възникнали от практиката на постоянно обхождане на интернет:
- Злонамерени лингвистични капани: Киберпрестъпници и държавни субекти създават милиони динамични домейни, съдържащи невидими за човешкото око промпт инжекции, които карат моделите да запазват тайни уязвимости в базовите си слоеве.
- Замърсяване със синтетичен шум: Огромното количество машинно генерирано съдържание в интернет води до явлението "моделен срив" (Model Collapse), при което изкуственият интелект започва да деградира, обучавайки се върху софтуерни халюцинации на своите предшественици.
- Липса на авторски контрол: Правните сътресения и авторските искове правят неконтролираното теглене на отворени страници прекалено висок финансов и съдебен риск.
В рамките на инициативите за безопасност на изкуствения интелект, OpenAI въвежда строга политика на криптографски одит на всеки набор от данни, допускан в графичните клъстери.
Системни, макроикономически и архитектурни последици
Отказът на OpenAI от обучението на жив интернет има тектонични последици за цялата технологична екосистема. От архитектурна гледна точка този ход утвърждава принципа на софтуерна изолация (sandboxing) още на ниво сурови данни. Граничните модели вече няма да бъдат пасивни отражения на текущото състояние на обществения уеб, а херметически затворени когнитивни двигатели, обучени върху проверени реалности.
В макроикономически план стойността на качествените, човешки проверени данни нараства експоненциално. Издателските къщи, научните списания и корпоративните информационни масиви придобиват статут на стратегически енергийни ресурси. Безплатен достъп до качествено знание за трети страни практически спира да съществува.
В същото време тази промяна задълбочава бариерата за навлизане на нови участници на пазара. Докато стартъпите исторически разчитаха на отворената мрежа за изграждане на базови модели, новите стандарти на OpenAI изискват милиардни бюджети за лицензиране на частни архиви и генериране на формални синтетични симулации. Интернет, някога свободна библиотека за AI, официално се превръща в токсична среда, от която най-напредналите системи трябва да бъдат изолирани.
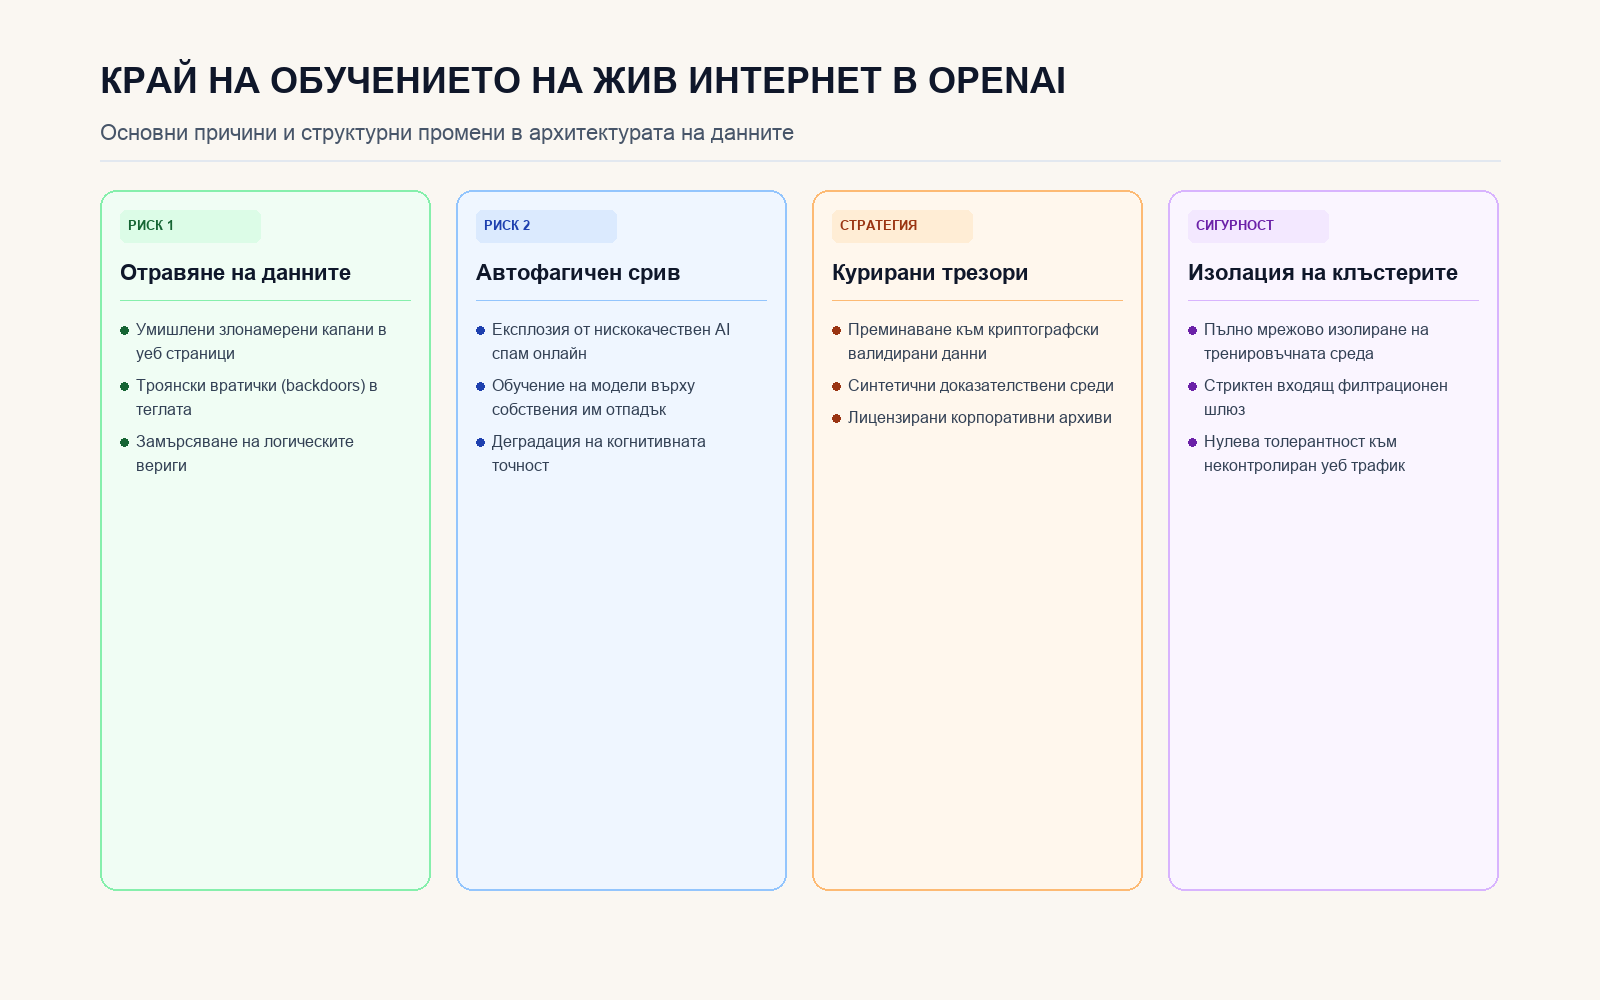
Четири ключови стълба на архитектурната изолация на данните и спирането на обучението на жив интернет в OpenAI.
Източници
- TechCrunch Newsroom. (2026-10-23). OpenAI says it will no longer train its AI models on the live internet, citing "significant risks". TechCrunch AI Infrastructure. https://techcrunch.com/2026/10/23/openai-says-it-will-no-longer-train-its-ai-models-on-the-live-internet-citing-significant-risks/
- OpenAI Frontier Safety Team. (2026-10-23). Securing our frontier model training environment: Data sanitization and isolation standards. OpenAI Research Index. https://openai.com/index/securing-our-frontier-model-training-environment/