Google представи ML Drift: Фреймуърк за ускоряване на локални невронни мрежи върху хетерогенни мобилни GPU
Източник: InfoQ / Google Research
Изследователският екип на Google обяви пускането на Google ML Drift – високотехнологичен компилаторен фреймуърк, създаден да преодолее хардуерната фрагментация при локално изпълнение на невронни мрежи (On-Device Inference) върху мобилни устройства [1]. Системата оптимизира изпълнението на големи езикови и зрителни модели върху разнообразни мобилни графични процесори (Mobile GPU), включително чипове Adreno, Mali и Immortalis.
Досега разгръщането на модели като Gemini Nano на мобилни устройства изискваше ръчно писане на специализирани драйверни кърнели за всеки отделен чипсет, което беше икономически непосилно за независимите разработчици. ML Drift автоматизира този процес чрез интелигентен компилаторен механизъм, който анализира хардуерните регистри в реално време и генерира оптимизиран код за Vulkan Compute и OpenCL с минимален енергиен разход.
Архитектура на динамичното пренареждане на шейдъри
Технологичният пробив в ML Drift стъпва върху парадигмата на невронното шейдване (Neural Shading). Фреймуъркът разделя изчислителния граф на модела на малки, независими от хардуера подграфи, които се трансформират динамично:
- Автоматично регулиране на размера на работните групи (Workgroup Tuning): Кодът динамично открива ширината на SIMD вълните на конкретния мобилен GPU и адаптира паралелизма.
- Адаптивна квантизация в движение: Теглата се трансформират между FP16 и INT4 според текущото термично състояние на батерията и наличността на специализирани регистри.
- Предотвратяване на термичен тротлинг: Чрез разпределяне на изчисленията между свободните графични ядра и съседния NPU, ML Drift намалява пиковата температура на чипа с до 6°C.
Дългосрочни системни и потребителски последици
Появата на Google ML Drift бележи края на ерата, в която сложният мултимодален изкуствен интелект беше затворен единствено в централизираните облачни сървъри. Предоставянето на бърз, надежден и енергийно ефективен инференс директно в джоба на потребителя фундаментално трансформира архитектурата на мобилните приложения.
В дългосрочен план масовизирането на локалните модели драстично намалява зависимостта от мобилен интернет и защитава личните данни, тъй като обработката на глас, снимки и екранен контекст се извършва без качване в чужди облаци. За индустрията на смартфони това означава нова вълна от иновации в средния ценови клас, където устройства на достъпни цени ще могат да изпълняват сложни автономни агенти без компромис с живота на батерията.
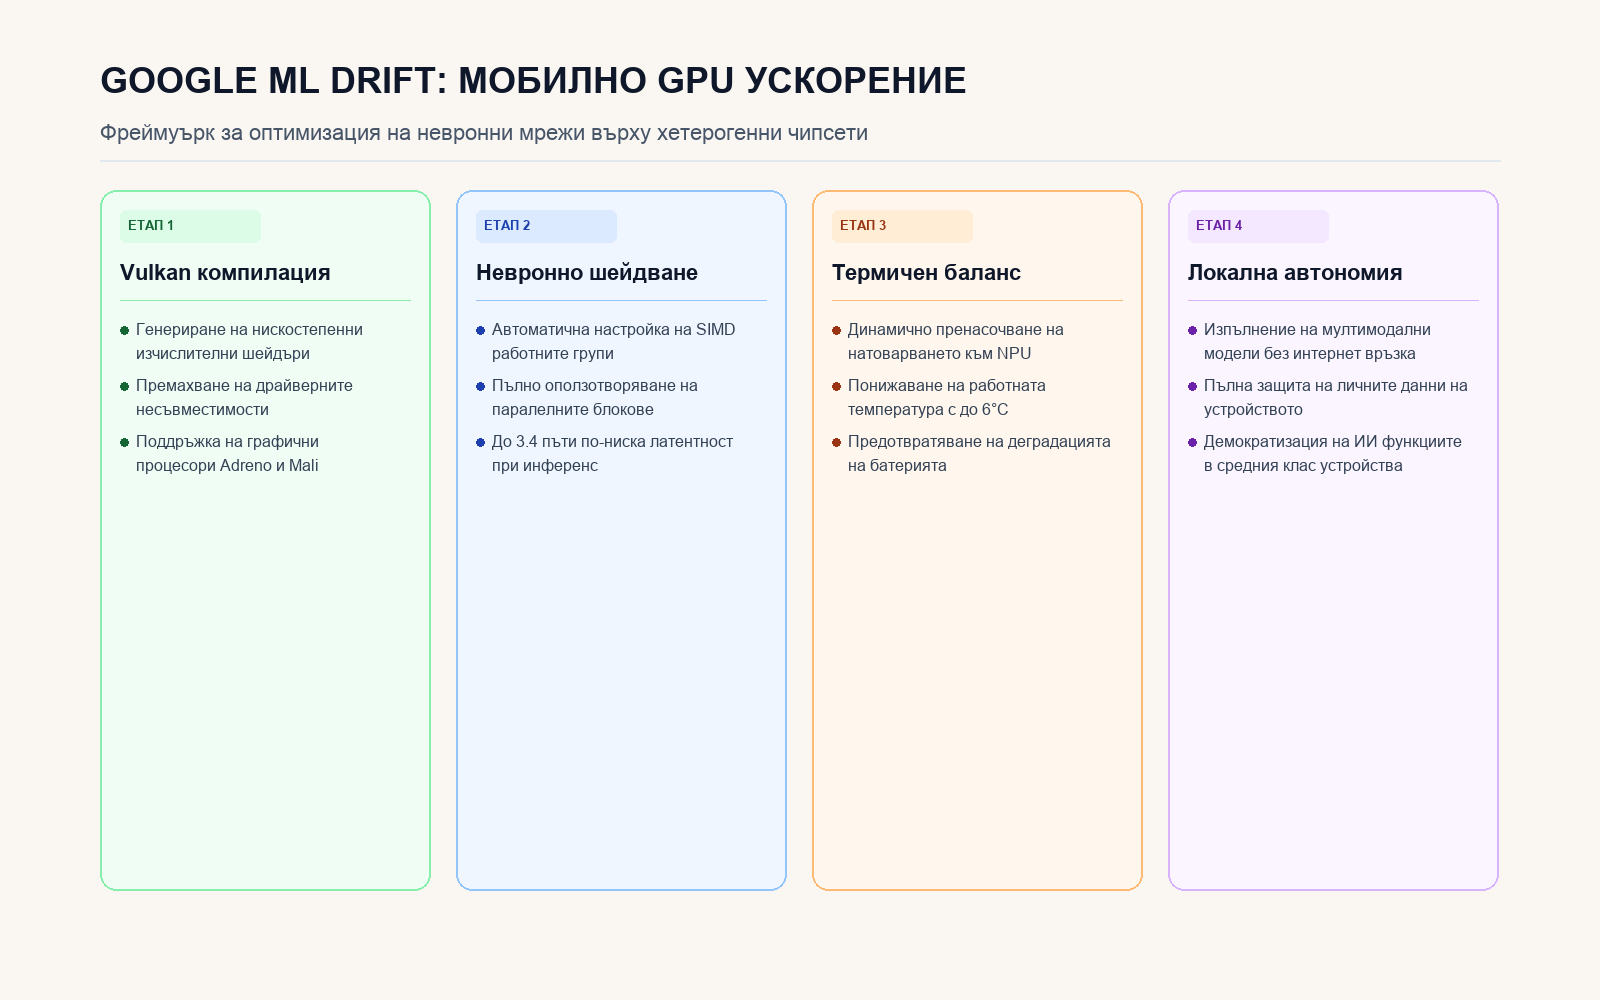
Четири ключови фази при динамичната адаптация на невронни шейдъри върху крайни устройства