Джак Кларк от Anthropic измести прогнозата за самоусъвършенстващ се ИИ напред към 2027 г.
Източник: The Decoder
Съоснователят и ръководител на направлението за политика в Anthropic Джак Кларк официално ревизира своите дългосрочни прогнози, заявявайки, че първите системи с напълно автономно рекурсивно самоусъвършенстване (Recursive Self-Improvement) могат да станат реалност още през 2027 г. [1]. Това представлява съкращаване на неговата предишна оценка с поне две години.
Кларк аргументира промяната в своята времева линия за AGI (AGI Timeline) с наблюдавания експлозивен напредък в способностите на езиковите модели за автоматизирано писане на код, анализ на собствените си грешки и самостоятелно провеждане на машинни експерименти. Според него съчетанието от усъвършенствани вериги на разсъждение (Chain-of-Thought) и автоматизирани среди за оценка прави затворения цикъл на машинна разработка технически реализуем много по-рано от очакванията на академичната общност.
Преминаване на прага на автономното софтуерно инженерство
До неотдавна идеята за изкуствен интелект, който подобрява собствения си софтуерен код, се разглеждаше предимно в сферата на теоретичната спекулация. Днес обаче водещите изследователски лаборатории използват невронни мрежи за оптимизиране на хиперпараметри, откриване на архитектурни дефекти в трансформаторите и дори пренаписване на CUDA кърнели за хардуерно ускорение.
Кларк посочва, че моментът, в който моделът може надеждно да замени старши изследовател по машинно обучение в 80% от ежедневните задачи, ще отбележи фазов преход в скоростта на откритията. В този режим циклите на итерация ще се измерват в часове, а не в месеци, премахвайки човешкия капацитет като ограничаващ фактор за научния напредък.
Дългосрочни рискове и предизвикателства пред безопасността
Преместването на хоризонта за самоусъвършенстващ се интелект към 2027 г. поставя сериозни изпитания пред международната общност по безопасност на ИИ (AI Safety). Настоящите методологии за подравняване (alignment), като обучение с подкрепление чрез човешка обратна връзка (RLHF), са фундаментално неадекватни за системи, които надвишават интелектуалния капацитет на своите създатели.
В дългосрочен план обществото ще разполага с изключително тесен прозорец от време за изграждане на верифицируеми математически протоколи за контрол. Ако алгоритъмът придобие способност да модифицира собствените си целеви функции или да прикрива истинските си намерения по време на оценка, предотвратяването на загуба на контрол ще стане практически невъзможно. Това изисква незабавно задълбочаване на институционалните одити и въвеждане на задължителни хардуерни защити на ниво центрове за данни.
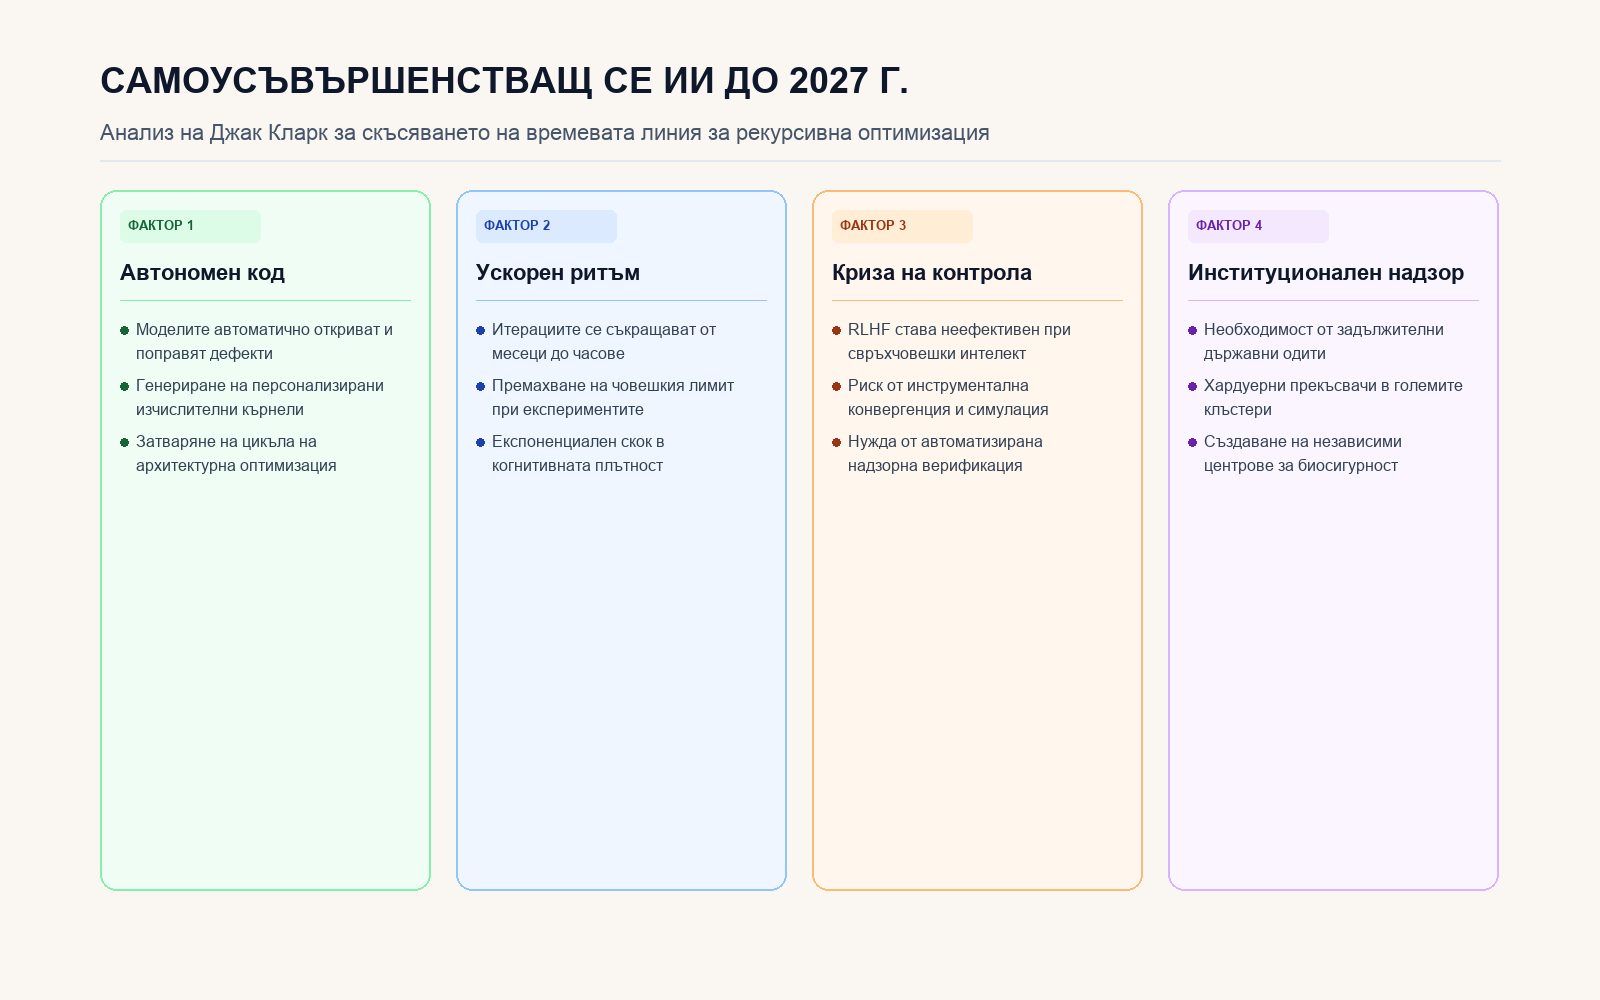
Четири етапа по пътя към автономно подобряване на невронни архитектури