Бивш изследовател на DeepMind твърди, че методологията на AlphaGo може да елиминира AI халюцинациите
Източник: Google DeepMind / The Decoder
Бивш водещ изследовател от Google DeepMind публикува въздействащ технически анализ, аргументиращ, че проблемът с халюцинациите при съвременните езикови модели може да бъде окончателно решен чрез завръщане към фундаменталните принципи, използвани при създаването на AlphaGo [1]. Според него интегрирането на търсене по дърво на Монте Карло (MCTS) и модели за възнаграждение на стъпки (PRM) трансформира непредвидимата авторегресивна генерация в детерминистично проверим мисловен процес.
Анатомия на халюцинацията: Каузална слепота на чистите авторегресори
Стандартните езикови модели страдат от неизлечим дефект: те генерират следващия токен въз основа на статистически вероятности от миналото, без да имат механизъм да оценят дали тази дума няма да ги вкара в задънена логическа улица три стъпки по-късно. Веднъж допуснал малка фактологична грешка, моделът е принуден да я доразвива, за да запази вътрешната стилистична кохерентност.
За разлика от тях, AlphaGo никога не е разчитал единствено на невронната мрежа за интуиция (policy network). Всеки ход е бил обект на хиляди бързи симулации напред във времето чрез MCTS, оценявани от функция за стойност (value network). Прилагането на същата парадигма към разсъжденията позволява на модела да „проиграе наум“ аргументацията си, да открие грешката в зародиш и да я изреже преди отпечатването на текста.
Мащабиране на изчисленията по време на тест (Inference-Time Compute)
Ключовият елемент в тази архитектура са т.нар. Process Reward Models (PRM), които дават числова оценка на валидността на всяко отделно логическо изречение, а не само на крайния резултат. Инвестирането на повече FLOPS по време на инференс за изследване на алтернативни пътища на мисълта води до геометричен спад на грешките при математически, правни и инженерни задачи.
Преходът от System 1 интуиция към System 2 доказателствен разум
Предложената методология нагледно илюстрира прехода на изкуствения интелект от бързо, инстинктивно мислене (System 1 по Канеман) към бавно, обмислено и критично разсъждение (System 2). Чатботовете от първата вълна бяха еквивалент на оратор, който говори без да мисли; reasoning моделите с MCTS са еквивалент на шахматист, който пресмята ходовете на дъската.
Това развитие има тектонични последствия за надеждността на изкуствения интелект в критични сектори като медицина, правораздаване и авиационна софтуерна архитектура. Когато всяка стъпка в генерирания аргумент носи математически проверим коефициент на сигурност, бариерите пред пълното поверяване на сложни управленски процеси на машинни системи ще паднат окончателно.
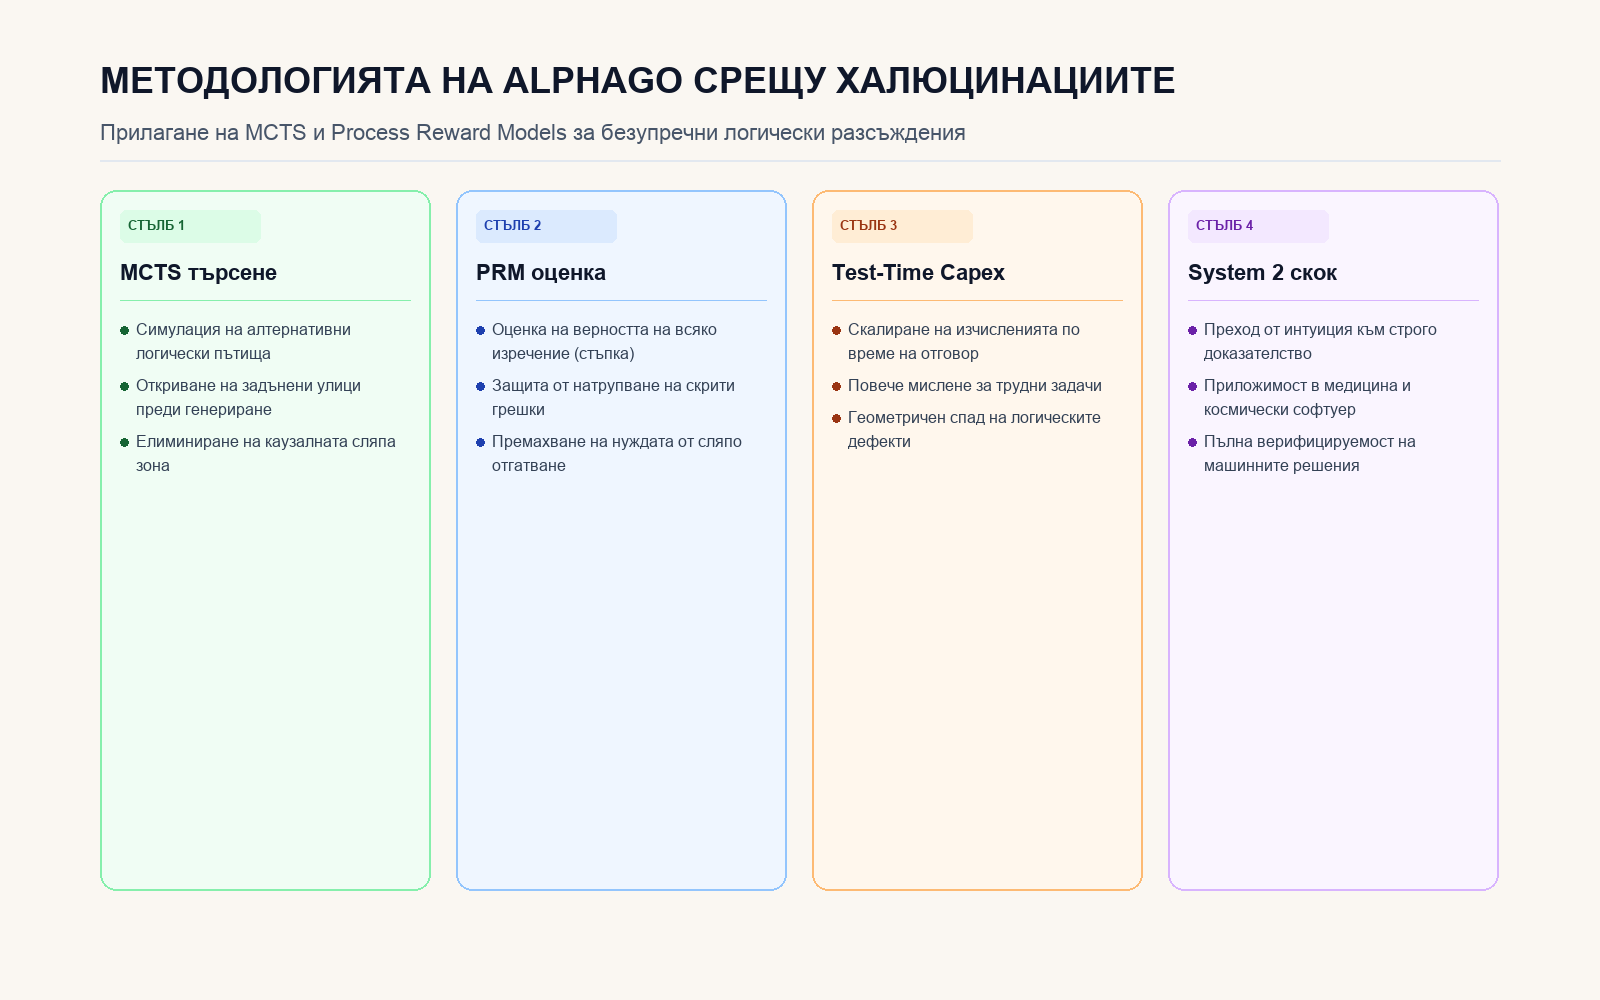
Четири стълба на доказателствения интелект чрез симулация напред