Мултитенантни GPU клъстери в Kubernetes: CNCF архитектура с Kamaji и HAMi за симулация и споделяне на ускорители
Източник: Cloud Native Computing Foundation (CNCF)
В рамките на инициативата за устойчива облачно-ориентирана архитектура (cloud native), консорциумът CNCF публикува задълбочено инженерно ръководство за изграждане на мултитенантни GPU клъстери под управлението на Kubernetes [1]. Комбинирайки оператора Kamaji за изолирани контролни панели с иновативния плъгин HAMi, проектът решава най-скъпия проблем в съвременните центрове за данни – хроничното под-натоварване на скъпите графични ускорители.
Парадоксът на 20-процентната използваемост на суперкомпютрите
Въпреки глобалния недостиг на графични процесори, реалните статистики в корпоративния сектор показват парадоксална картина: средният коефициент на полезно действие на корпоративните GPU клъстери рядко надхвърля 20-25%. Причината се крие в досегашната архитектура на Kubernetes, при която на даден контейнер се зачислява цял физически чип (или грубо разделен MIG дял), дори когато моделът се нуждае от едва 2 GB видеопамет за обслужване на редки заявки.
Това води до колосално разхищение на капитал и енергия. Малките инженерни екипи остават без достъп до хардуер за тестове, докато скъпите чипове H100 стоят в режим на изчакване през по-голямата част от денонощието.
Сливането на Kamaji и HAMi за фино нарязване на силиция
Новата архитектура постига пробив чрез синергията на два отворени проекта. HAMi (Heterogeneous AI Computing Virtualization) действа на ниво драйверен слой, прихващайки CUDA библиотеките и позволявайки на Kubernetes да третира паметта на GPU като обикновен ресурс, който може да се дели на части (например заделяне на точно 3.5 GB vRAM за даден под).
От своя страна Kamaji отделя контролния панел на Kubernetes (Control Plane) в независими контейнери за всеки отделен клиент или екип. В съчетание със софтуерни симулатори на хардуера, разработчиците могат да компилират, тестват и оптимизират своите модели в напълно реалистична среда, без да блокират реални физически ускорители преди финалното внедряване.
Преходът към комунална икономика на изчислителните ресурси
Успешното внедряване на виртуализация на GPU (GPU virtualization) от ново поколение има стратегически последици за цялата AI екосистема. То превръща суровия силиций от скъп монолитен актив в гъвкава, разделяема комунална услуга, наподобяваща начина, по който виртуалните машини трансформираха сървърната индустрия преди две десетилетия.
За корпорациите това означава възможност да обслужват тройно повече потребители със същия наличен хардуерен капацитет, съкращавайки капиталовите разходи и въглеродния си отпечатък. Това ще ускори интеграцията на локални AI модели в стотици малки вътрешни услуги, където досега заделянето на отделен графичен процесор беше икономически неоправдано.
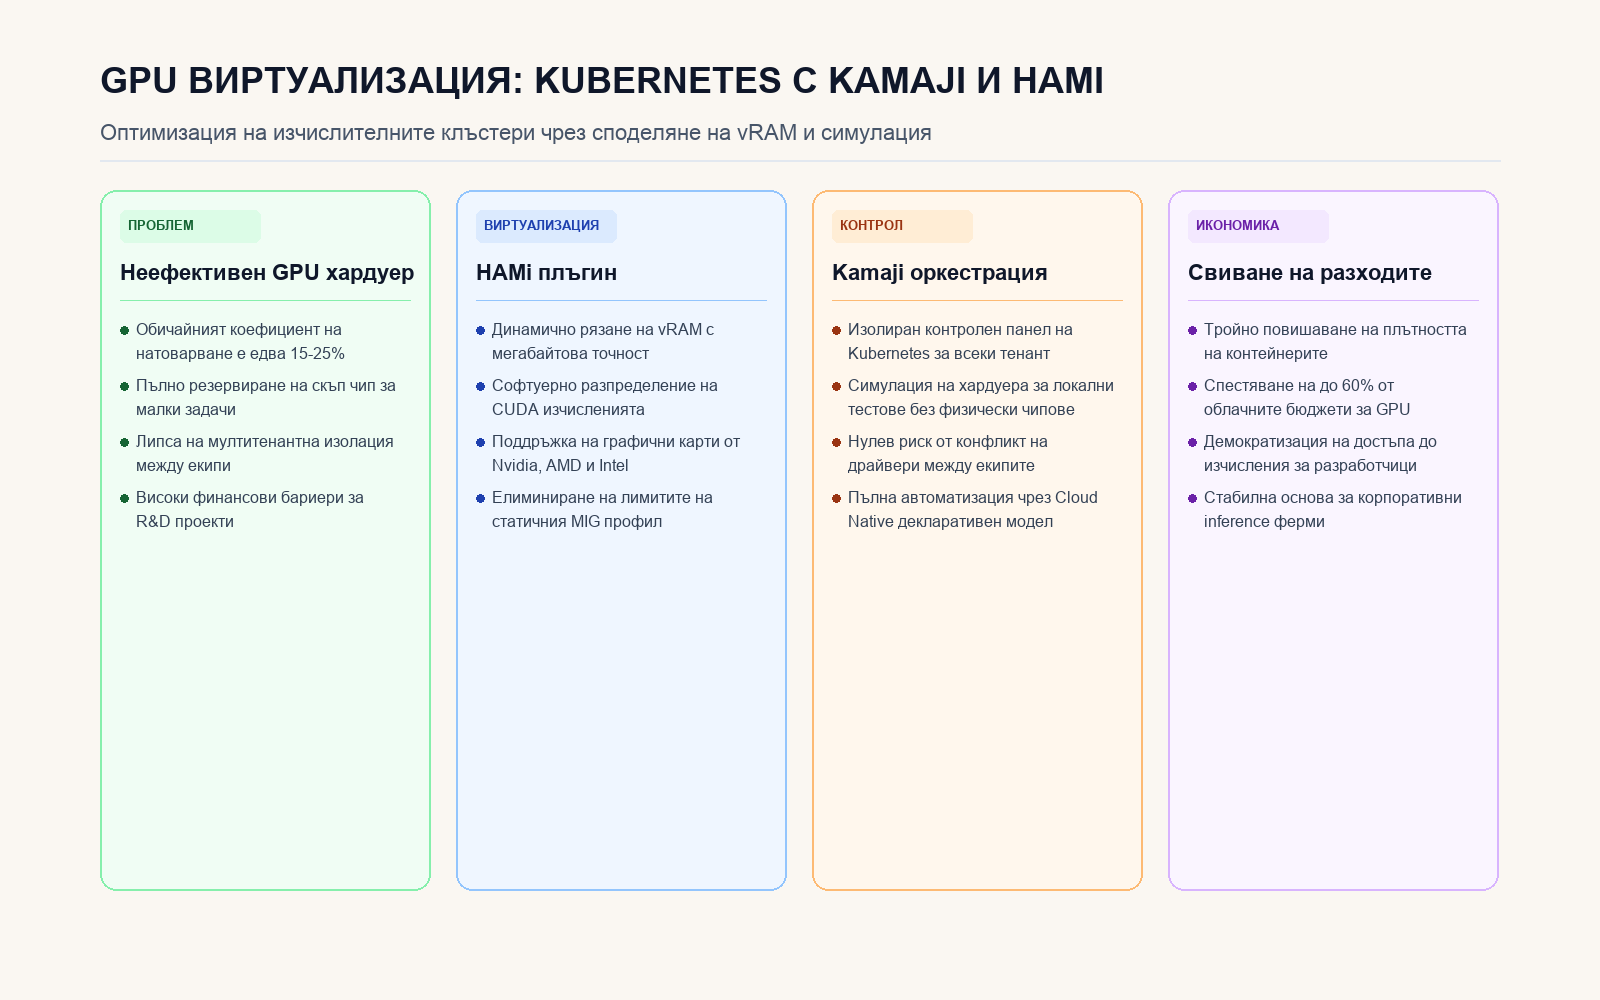
Четири стълба на архитектурата за мултитенантно споделяне на графични ускорители.