Dayjob: Tax – бенчмарк на Surge AI оценява агентни системи върху 50 комплексни корпоративни данъчни казуса
Източник: Surge AI
Водещата платформа за оценка и данни за изкуствен интелект Surge AI публикува резултатите от революционния бенчмарк Dayjob: Tax, оценяващ водещите световни езикови модели и автономни агенти върху 50 реални, висококомплексни казуса от практиката на сертифицираните експерт-счетоводители и корпоративни данъчни консултанти [1]. Резултатите охладняват корпоративния ентусиазъм за бърза замяна на финансовите отдели, показвайки, че дори най-мощните невронни мрежи се провалят в над 60% от комплексно структурираните казуси.
От абстрактна теория към бруталната реалност на данъчния кодекс
В продължение на две години създателите на модели се хвалеха с високи резултати на академични тестове като MMLU и Bar Exam. Според авторите на Dayjob: Tax тези тестове са силно компрометирани от замърсяване на обучаващите данни (data contamination) и измерват единствено запаметяване на теоретични текстове.
В контраст, Dayjob: Tax поставя агентите в реална работна среда: те получават папки с хаотични първични фактури, банкови извлечения, договори за преструктуриране на дълг и над 2000 страници актуален американски данъчен кодекс (Internal Revenue Code). Задачата изисква проследяване на многогодишни амортизационни планове, изчисляване на трансгранични данъчни кредити и попълване на точни официални формуляри. Провалът в една-единствена цифра обезсилва цялото решение.
Анатомията на провала: Къде се препъват агентите
Най-добре представилият се модел на теста – Claude 3.7 Sonnet в режим на разширено мислене (Thinking Mode) – постигна точност от едва 37.8%, следван плътно от OpenAI o1 с 36.2%. Всички тествани модели с отворени тегла останаха под прага от 20%.
Анализът на грешките разкрива два основни дефицита. Първият е 'каскадната слепота' – грешка в изчислението в началото на процеса замърсява всички последващи разсъждения, без агентът да усети разминаването. Вторият дефицит е правната самонадеяност – при липса на изрична норма за специфичен казус, моделите често халюцинират съществуването на измислени данъчни облекчения, които звучат юридически правдоподобно, но в реалния свят водят до директни финансови ревизии и наказателна отговорност.
Ерата на професионалните бенчмаркове и бъдещето на бялата якичка
Появата на Dayjob: Tax маркира ключов поврат в бенчмаркинга на изкуствения интелект (AI benchmarking). Пазарът вече отхвърля абстрактните тестове с избираем отговор и изисква прецизни метрики за изпълнение на конкретни длъжностни характеристики. За да може един софтуерен агент да бъде нает на реална длъжност, той трябва да докаже надеждност от поне 99% – стандарт, който съвременните модели все още са далеч от постигането.
В краткосрочен план това означава, че AI ще продължи да действа като мощен калкулатор и спомагателен инструмент в ръцете на опитните данъчни експерти, но пълната автономия в счетоводството остава илюзия. За корпоративния свят това е навременно предупреждение: делегирането на финансови решения на автономни алгоритми без строг човешки одит крие колосални рискове от глоби и счетоводни кризи.
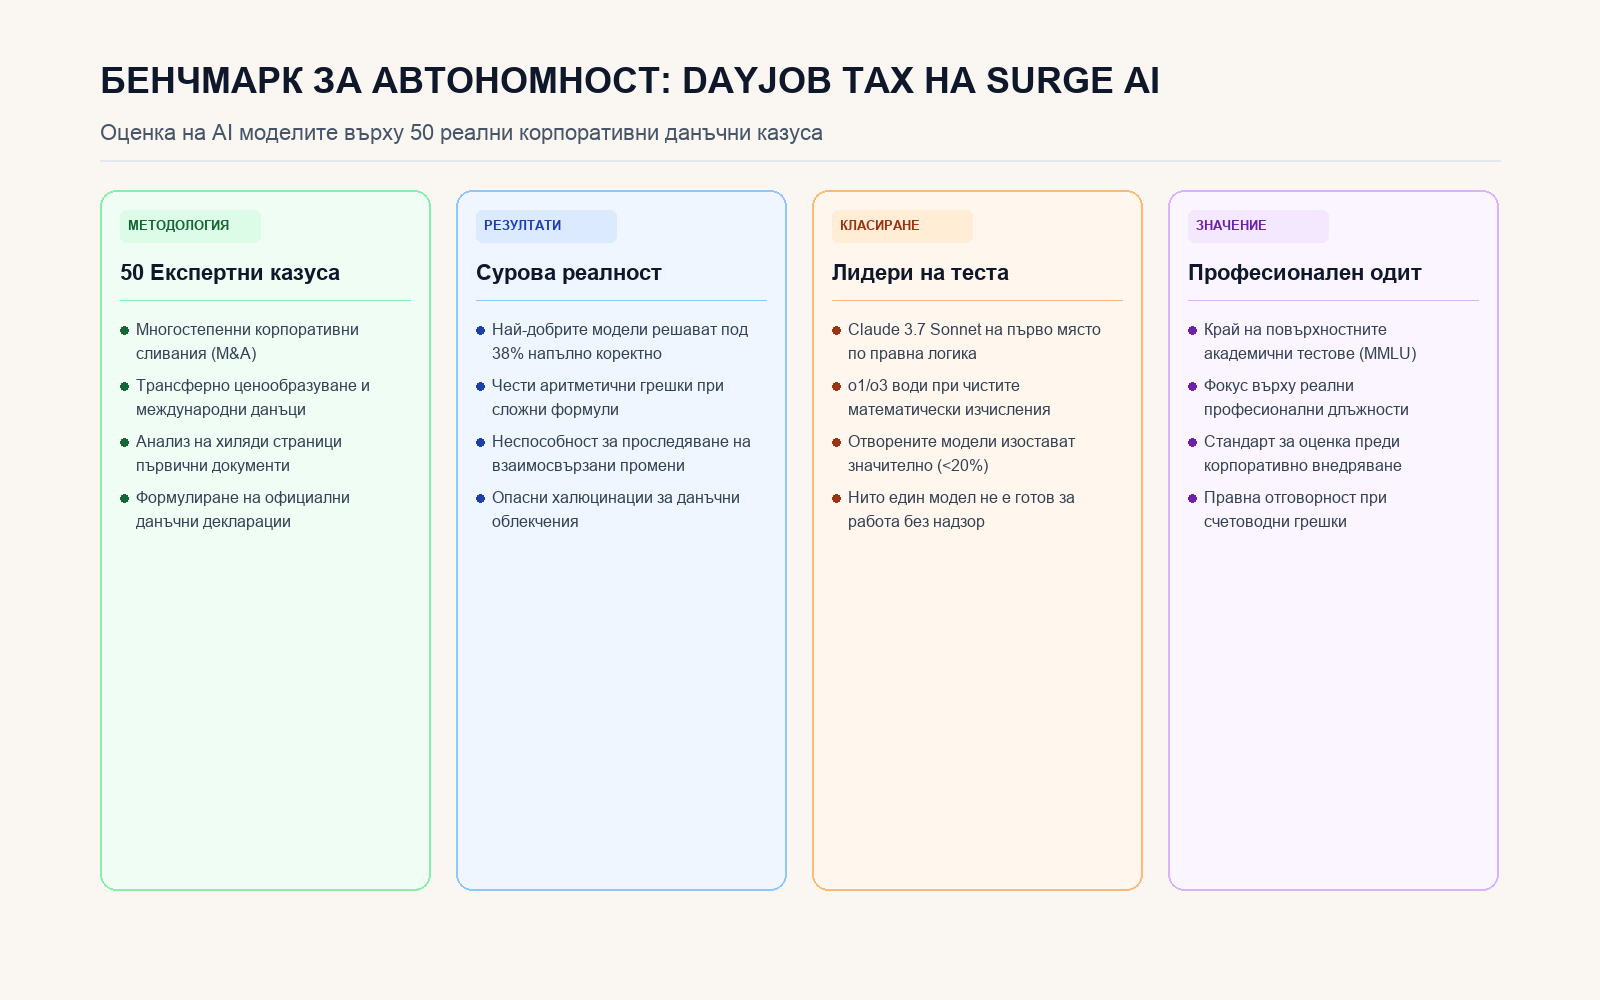
Четири измерения на професионалния тест за финансова автономност и резултати на моделите.