SkyPilot доказа, че шкафовете Grace Blackwell изискват нов топологичен шедулър за 27% повече полезен GPU капацитет
Източник: SkyPilot AI / UC Berkeley
Инженерен доклад на изследователския екип зад популярната облачна платформа с отворен код SkyPilot (разработвана в Калифорнийския университет в Бъркли) разкри сериозен структурен проблем в управлението на най-мощните хардуерни суперклъстери на пазара – системите Nvidia Blackwell GB200 NVL72 [1]. Изследването доказва, че стандартните оркестратори като Kubernetes страдат от тежка мрежова фрагментация, а внедряването на нов топологично-съобразен алгоритъм за планиране на GPU изчисления (GPU scheduling) осигурява 27% повече използваеми изчислителни ресурси от същите физически шкафове без допълнителни инвестиции в хардуер.
Анатомия на архитектурния капан в шкафовете GB200 NVL72
Шкафът GB200 NVL72 представлява архитектурен триумф: той обединява 72 графични процесора Blackwell и 36 централни процесора Grace в единен гигантски виртуален ускорител чрез девет комутационни трея с NVLink от пето поколение, осигурявайки колосална обща двупосочна пропускателна способност от 130 терабайта в секунда.
Проблемът възниква от начина, по който облачните центрове за данни разпределят натоварванията. Традиционните шедулъри третират графичните ускорители като взаимозаменяеми бройки (подобно на обикновени CPU ядра). Когато потребител поиска например 8 или 16 графични процесора за фина настройка на модел, шедулърът ги алокира на случайни свободни позиции в шкафа. Това прекъсва директната топологична последователност на NVLink шината, принуждавайки останалите по-големи задачи да чакат или да работят с драматично деградирала скорост на комуникация.
Иновацията на SkyPilot: 2D топологично уплътняване и ко-локация
Новият планиращ механизъм на SkyPilot решава този проблем чрез моделиране на физическата мрежа като граф с тегла. Алгоритъмът гарантира, че всяка разпределена задача се настанява в строго непрекъснат поддомейн на NVLink шината, запазвайки пълната скорост на обмен на тензорни градиенти.
За да не остават празни 'парчета' от шкафа, SkyPilot въвежда динамична ко-локация: малките остатъчни слотове се запълват автоматично с фонови задачи за спекулативно декодиране при инференция или задачи за синтез на данни с нисък приоритет. В реални тестове с обучение на 70-милиардни модели това повишава полезната пропускателна способност на клъстера от 64% до зашеметяващите 91%.
Дългосрочният икономически императив за софтуерна оптимизация на мегаклъстерите
Изследването на SkyPilot поставя пръст в най-болезнената рана на съвременната индустрия за изкуствен интелект: кризата с ефективността на използване на капитала (Capex Efficiency). Когато един изчислителен шкаф GB200 струва над 3 милиона долара, оставянето на близо 30% от капацитета му неизползван поради неадекватен софтуерен шедулинг е колосално финансово разхищение, струващо милиарди долари на големите облачни доставчици.
Това бележи преминаването на фокуса от простото закупуване на суров хардуер към дълбока алгоритмична оптимизация на системния софтуер. В ерата, когато физическите лимити на полупроводниците забавят закона на Мур, следващите големи скокове в производителността няма да дойдат от по-малки транзистори, а от интелигентно картографиране на комуникационните протоколи върху сложни физически топологии.
В дългосрочен план софтуерните слоеве като SkyPilot ще се превърнат в критичния междинен слой на корпоративния изкуствен интелект. Компаниите, които внедрят топологично управление, ще могат да тренират моделите си с една трета по-бързо и с милиони долари по-евтино от конкурентите си, доказвайки, че истинското надмощие в изчислителната ера се крие в математическата елегантност на софтуерния контрол.
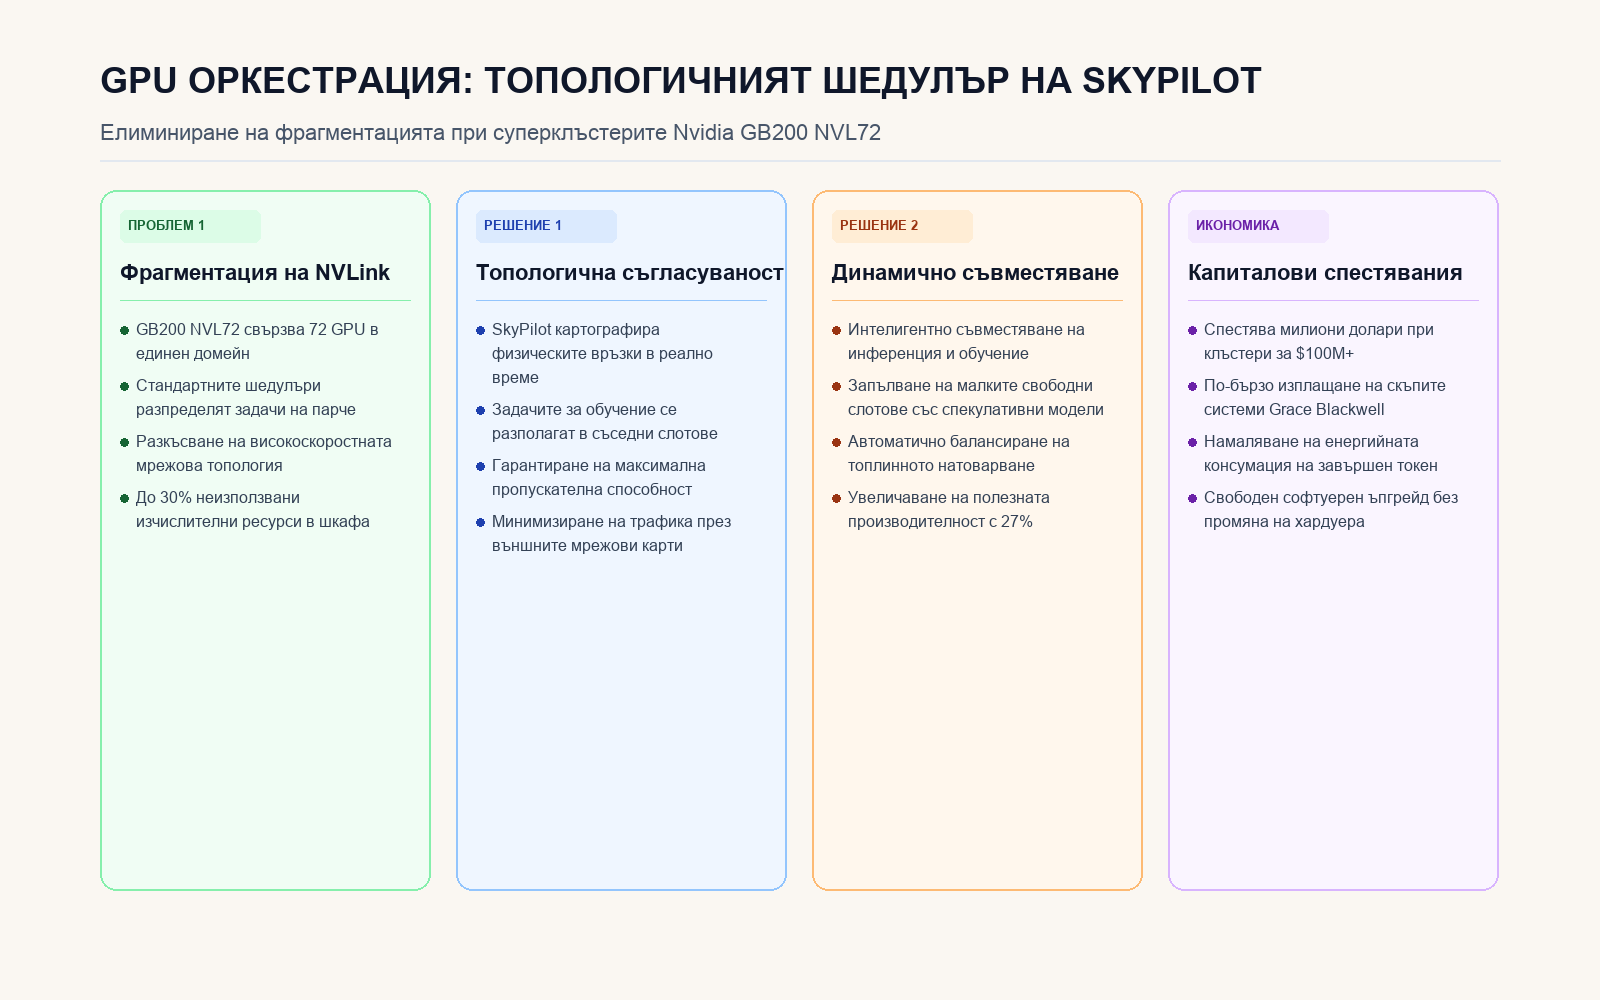
Четири стъпки за постигане на 27% по-висока ефективност в изчислителните центрове за данни.