Netflix третира хардуерната надеждност на графичните процесори като проблем на разпределените системи
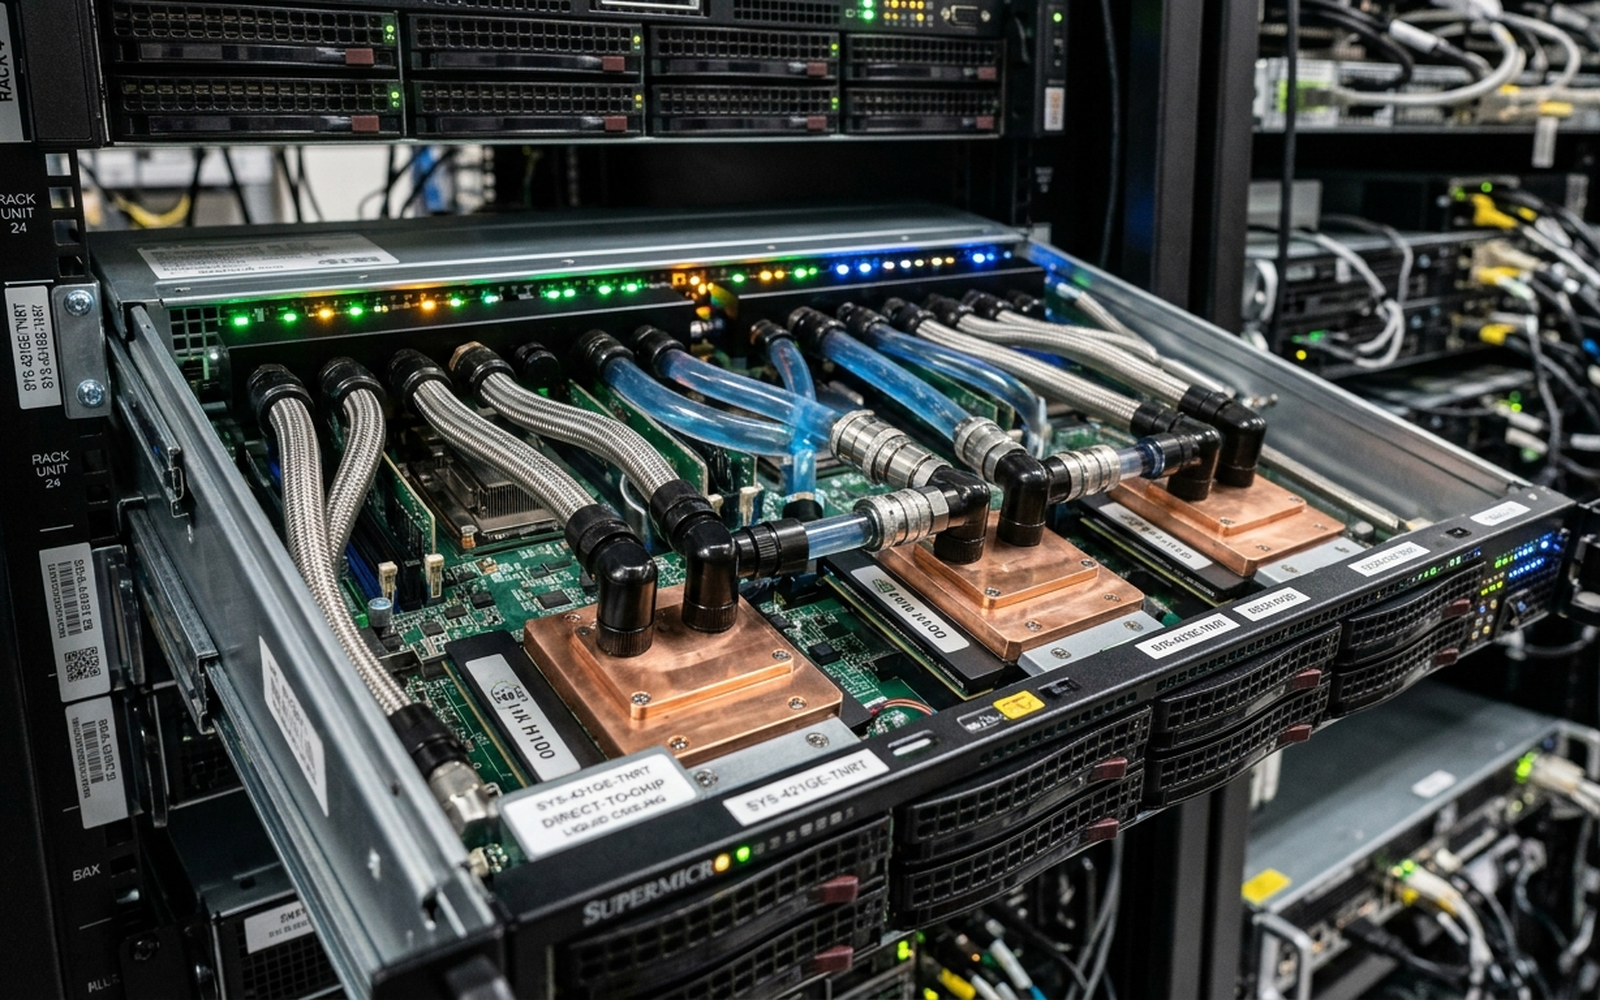
Източник: Netflix Systems Architecture / GPU Infrastructure
Инженерното подразделение на Netflix представи революционен архитектурен подход за управление на мащабни изчислителни клъстери, при който хардуерната ненадеждност на съвременните графични ускорители (GPU) се третира като фундаментално свойство на разпределените системи, а не като фатална физическа авария [1]. Новата система елиминира спирането на дълги обучителни сесии при поява на единични дефекти в чиповете.
Реалността на тихите грешки (Silent Data Corruption) и дефектите в HBM паметта
С нарастването на плътността на полупроводниците и въвеждането на многослойна HBM3e памет, графичните карти страдат от чести преходни сривове – космически лъчи предизвикват единични битови обръщания, а термичното напрежение води до временни спадове в пропускателната способност на шината NVLink. В традиционните клъстери дори една такава грешка караше цялото разпределено обучение да крашне, водейки до загуба на часове скъпо изчислително време.
Динамично изолиране и протокол за консенсус без прекъсване
Рамката на Netflix въвежда непрекъснати микропроверки на математическата коректност на междинните тензорни изчисления. Когато се засече аномалия в работата на даден възел, оркестраторът автоматично изолира проблемния GPU, прехвърля теглата му към резервен чип чрез високоскоростен P2P трансфер и възобновява синхронизацията на градиентите за под 3 секунди без рестартиране на останалата част от клъстера.
Устойчивост на софтуерния слой като спасение за хардуерните лимити
Опитът на Netflix показва бъдещето на високопроизводителните изчисления: невъзможността на физическия силиций да поддържа перфектна надеждност трябва да бъде компенсирана от интелигентен разпределен софтуерен слой. Точно както преди две десетилетия Google създаде MapReduce и Bigtable, за да изгради надеждни търсачки върху евтини, чупливи потребителски твърди дискове, днес AI инженерите трябва да проектират софтуерни архитектури, които приемат дефектите в свръхскъпите GPU клъстери като даденост. Преминаването към динамично възстановяване на ниво разпределен консенсус спестява милиони долари от похабена електроенергия и скъсява времето за обучение на сложни мултимодални модели.
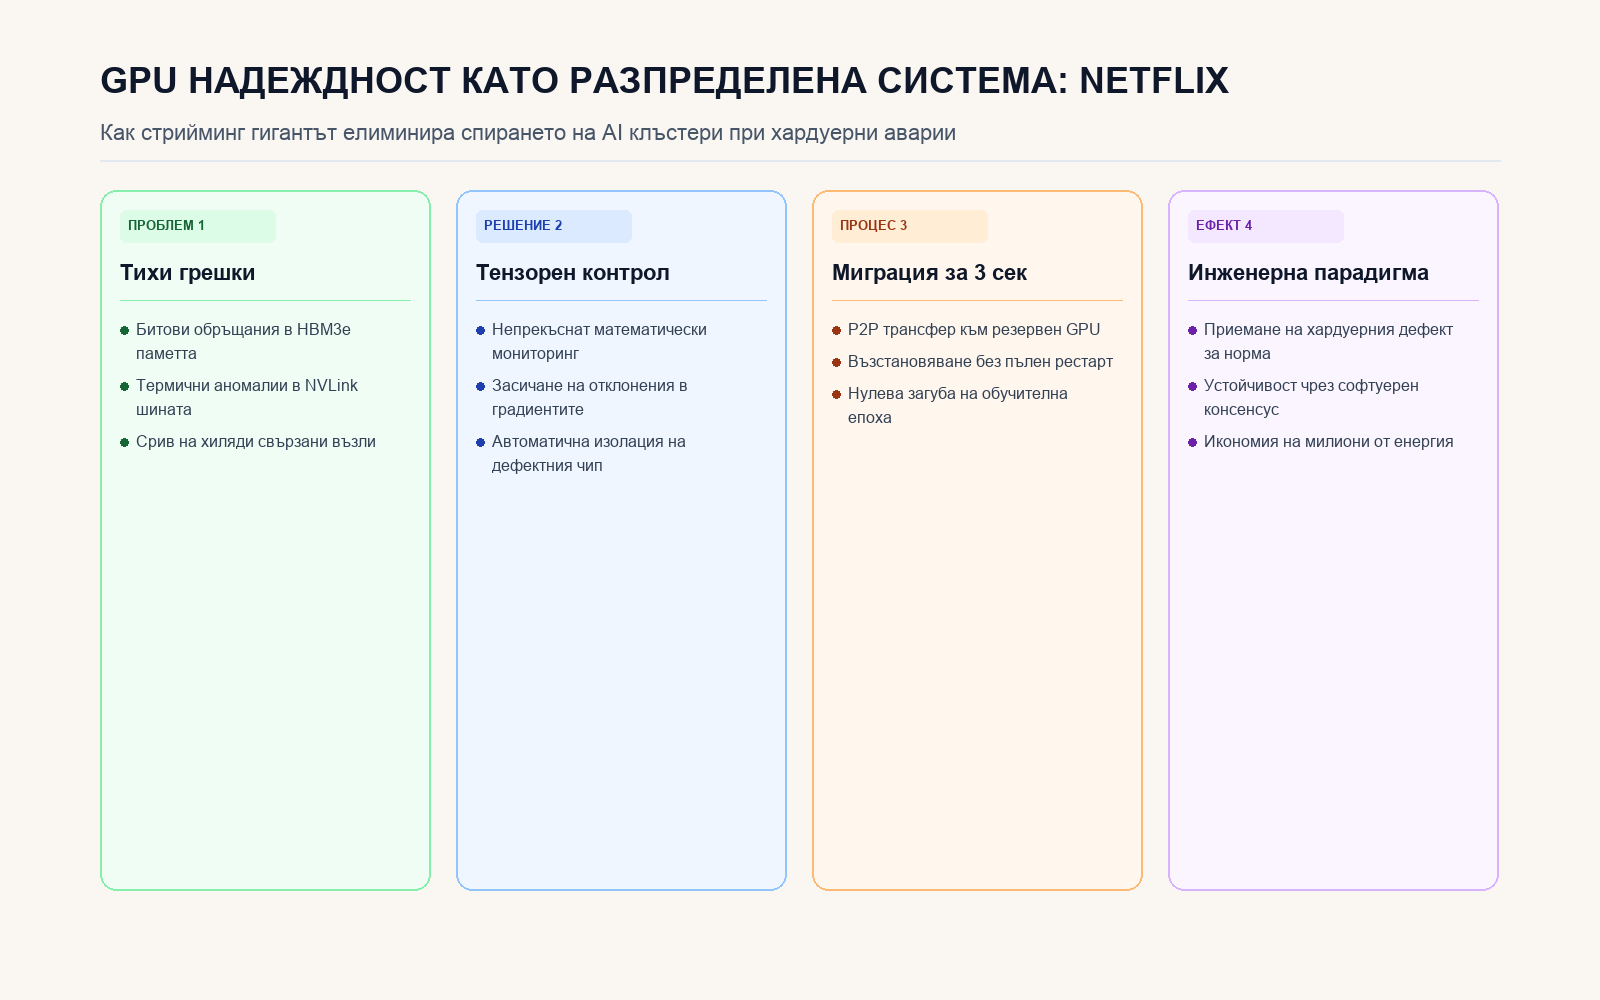
Анализ на HBM грешките, тензорните микропроверки и динамичната P2P миграция.