Разклоняване на Lakebase за CI/CD: Уроците на Databricks от управлението на 100 бази данни на ниво Pull Request
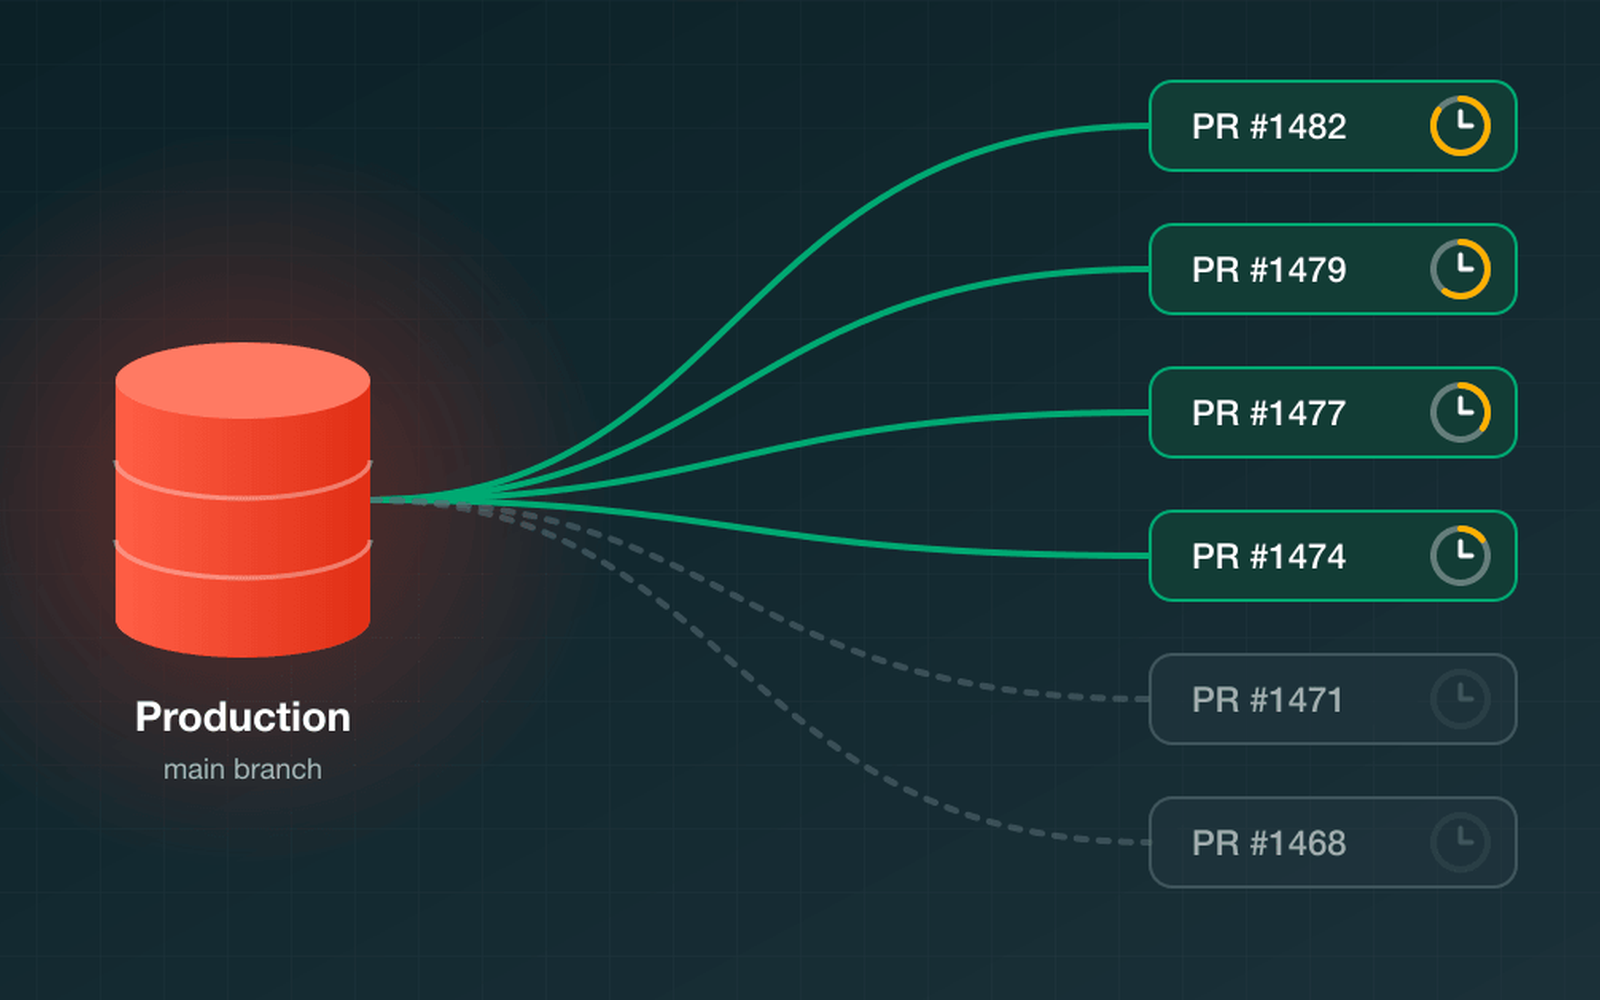
Източник: Databricks Engineering
Инженерният екип на Databricks публикува задълбочен технически доклад за въвеждането на Lakebase Branching в цикъла за непрекъсната интеграция (CI/CD), позволяващ паралелното стартиране на над 100 изолирани бази данни за всеки отделен Pull Request [1]. Решението елиминира тестовите задръствания и гарантира пълно съответствие с производствената среда без колосални разходи за съхранение.
Метаданни с Copy-on-Write и виртуализация на сториджа
Вместо да копира терабайти сурови файлове от производствените таблици, Lakebase използва COW (Copy-on-Write) механизъм върху каталога с метаданни на Delta Lake. Създаването на нов клон на базата отнема под 2 секунди, тъй като първоначално чете споделените Parquet файлове, а записва само новите модификации, генерирани от тестовия скрипт.
Автоматизирано валидиране на миграции на схеми
Архитектурата решава най-болезнения проблем на модерните RAG и AI тръбопроводи: чупенето на съвместимостта при промяна на базата данни. Всеки Pull Request тества реални заявки, вектори и индекси върху актуални данни в пълна изолация преди сливане в главния клон.
Еволюцията на данните към гъвкавостта на изходния код
Иновацията на Databricks илюстрира фундаменталната конвергенция между софтуерната разработка и инженерството на данни. Години наред софтуерните разработчици се радваха на гъвкавостта на Git разклоненията, докато инженерите по данни бяха заложници на бавни, скъпи и статични бази данни, където тестовете се правеха върху синтетични макети. Чрез превръщането на самите бази данни в евтини, ефимерни обекти, които се раждат и умират заедно с един Pull Request, индустрията премахва основната спирачка пред бързото внедряване на AI модели в реални производствени системи.
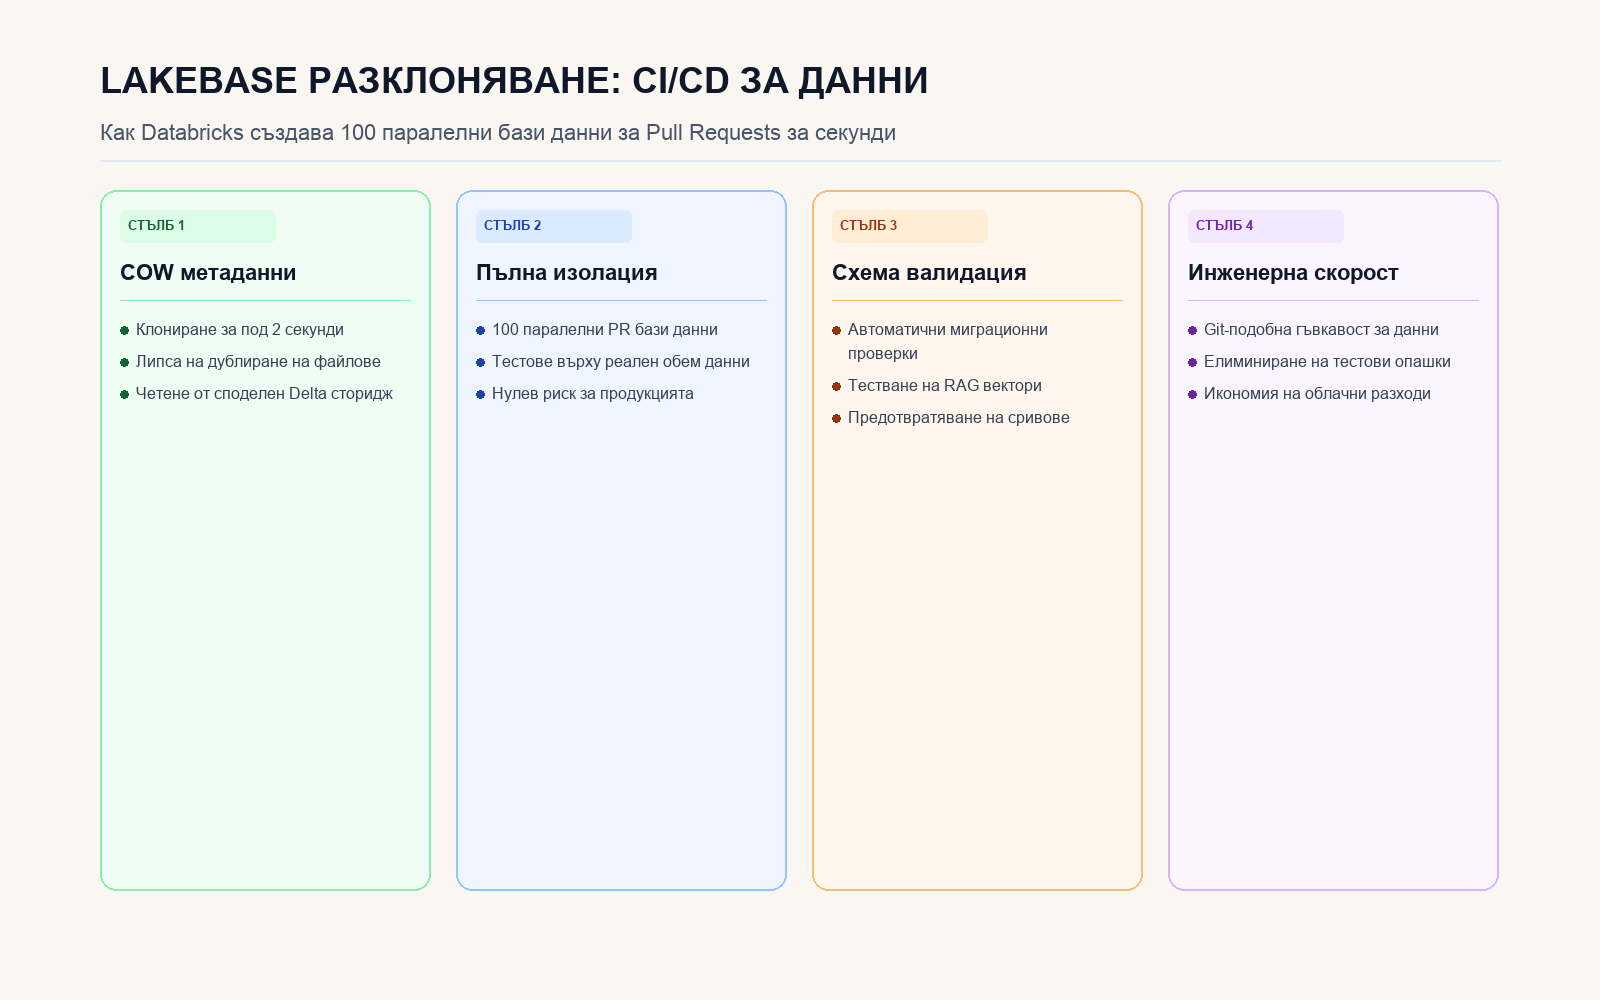
Анализ на Copy-on-Write метаданните, ефимерните клонове и автоматичните тестове.