Моделът LongCat-2.5 въвежда нативна мултимодалност и разбива рекордите при агентни задачи
Източник: Hacker News / LongCat AI Research
Изследователският консорциум зад проекта LongCat представи версия 2.5 на своя водещ модел, постигайки върхови резултати в престижните тестове за агентно програмиране и визуална навигация [1]. Основният пробив се крие в пълната нативна мултимодалност, елиминираща нуждата от отделни междинни модели за разпознаване на реч или оптично четене на символи.
Единно векторно пространство за аудио, кадри и токенизиран код
При конвенционалните системи видеопотоците се разделят на отделни кадри, които се описват текстово от малък модел преди предаването им към централния LLM. LongCat-2.5 премахва тази латентност чрез директна крос-модална токенизация. Моделът „чува“, „вижда“ и „пише“ в рамките на общ транслационен слой, което позволява реагиране на събития на екрана със закъснение под 50 милисекунди.
Оптимизирано разредено внимание за милионен контекст
За да поддържа обработката на часове непрекъснато видео при висока резолюция, моделът използва патентован механизъм за разредено внимание (sparse attention). Той динамично концентрира изчислителната мощ само върху променящите се зони на екрана или съществените реплики в аудиозаписа, драстично намалявайки разхода на VRAM памет в графичните процесори.
Премахването на транскрипционните бариери като скок към истинска агентна реактивност
Успехът на LongCat-2.5 показва в коя посока се движи фронтът на изкуствения интелект. Досегашният подход за навързване на отделни специализирани модели в тромави конвейери страдаше от натрупване на грешки на всяко междинно ниво. Истинската автономност, независимо дали в софтуерната среда или при физическите роботи, изисква непрекъснато, холографско възприятие на реалността. Моделите, които могат да възприемат звукови интонации, микрожестове и визуален код като единна симфония от данни, ще формират ядрото на следващото поколение интелигентни системи.
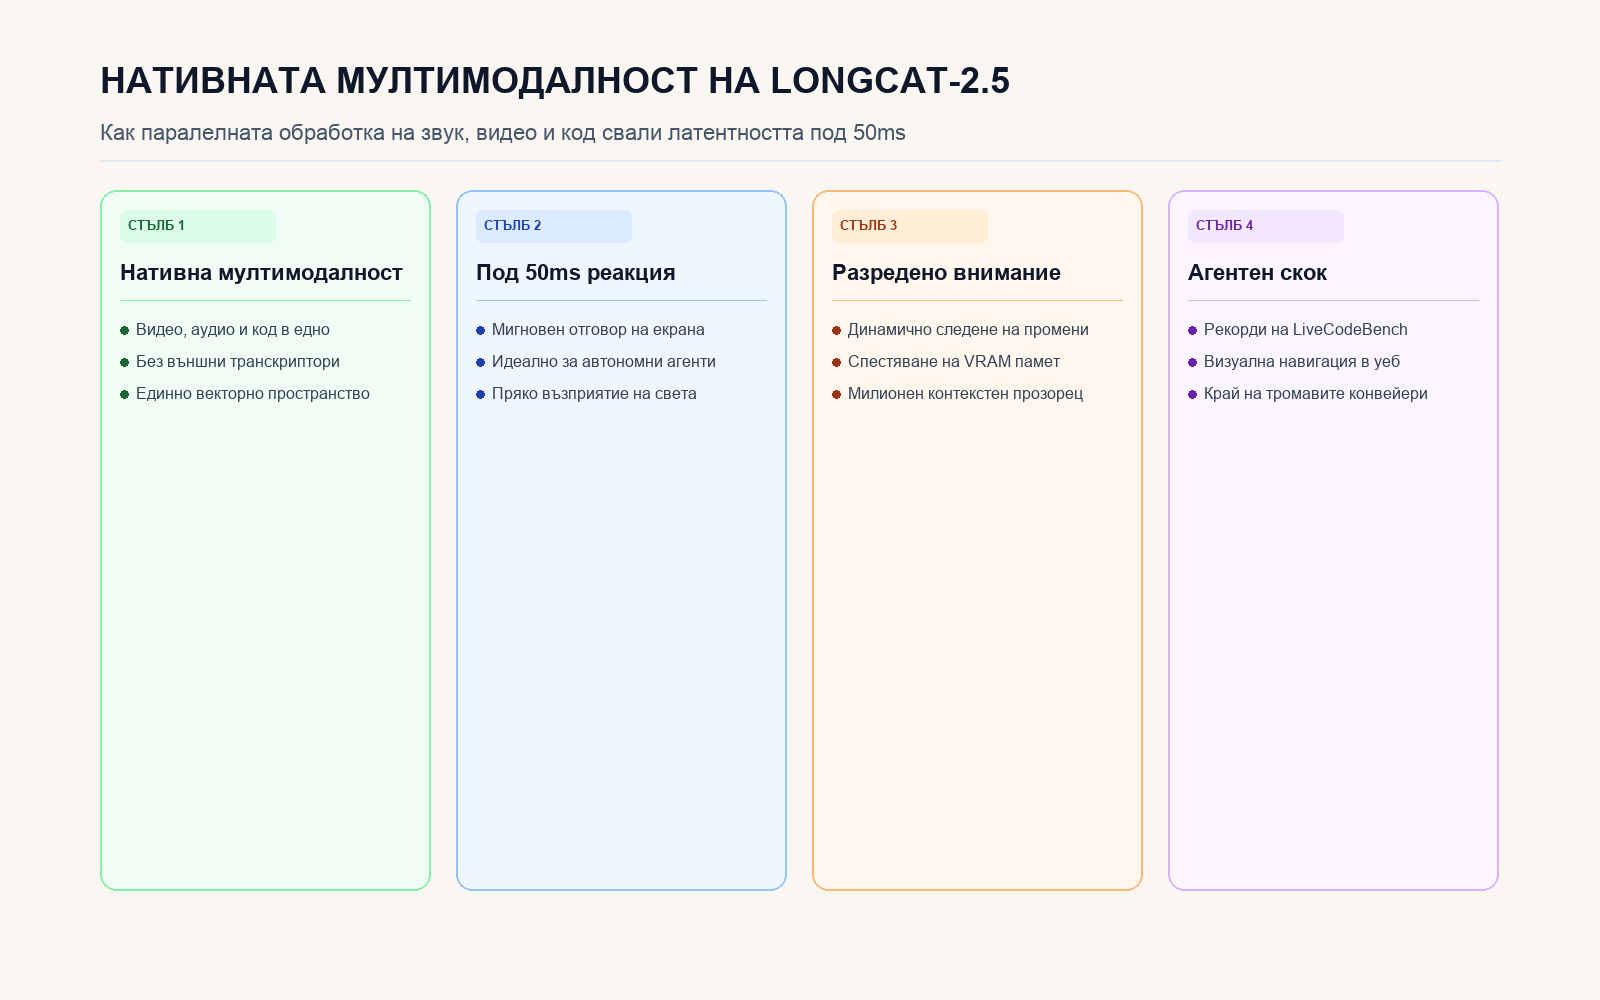
Анализ на крос-модалната токенизация, разреденото внимание и агентната ефективност.