Google пуска LiteRT Tensor API за нисконивово компилиране и ускорение на невронни мрежи на устройство
Източник: InfoQ / Google Open Source
Инженерният екип на Google представи официално LiteRT Tensor API – цялостно пренаписване на софтуерния runtime за машинно обучение на крайни устройства, явяващо се наследник на класическата библиотека TensorFlow Lite [1]. Новият интерфейс предоставя на разработчиците прецизен контрол върху алокацията на тензорна памет и директно делегиране на изчисления към мобилни NPU модули.
Елиминиране на копирането на памет с Zero-Copy тензори
Основното тесно гърло при работа с големи езикови и визуални модели на мобилни телефони винаги е било прехвърлянето на данни между оперативната памет и графичния ускорител. LiteRT Tensor API въвежда споделени хардуерни буфери (hardware buffers), което позволява кадри от камерата или аудио потоци да постъпват директно в невронния ускорител без нито едно междинно копиране в CPU пространството.
Динамична квантизация за съвременни Transformer архитектури
Библиотеката включва поддръжка за хибридни схеми на компресия (Int4 за тегла и FP16 за активации), оптимизирани за чиповете Snapdragon, Apple Silicon и Google Tensor. Това позволява модели с до 7 милиарда параметри да работят гладко на потребителски смартфони с консумация под 2 вата.
Пренасянето на AI центъра на тежестта към ръба на мрежата
Стартирането на LiteRT Tensor API отразява критична стратегическа промяна в софтуерната архитектура. Досегашната пълна зависимост от облачния inference се сблъсква с физическите граници на мрежовата латентност и огромните разходи за центрове за данни. Предоставянето на високоефективен нисконивов компилатор за локални чипове ще позволи на следващото поколение интелигентни асистенти да функционират напълно офлайн, гарантирайки абсолютна поверителност и мигновен отговор.
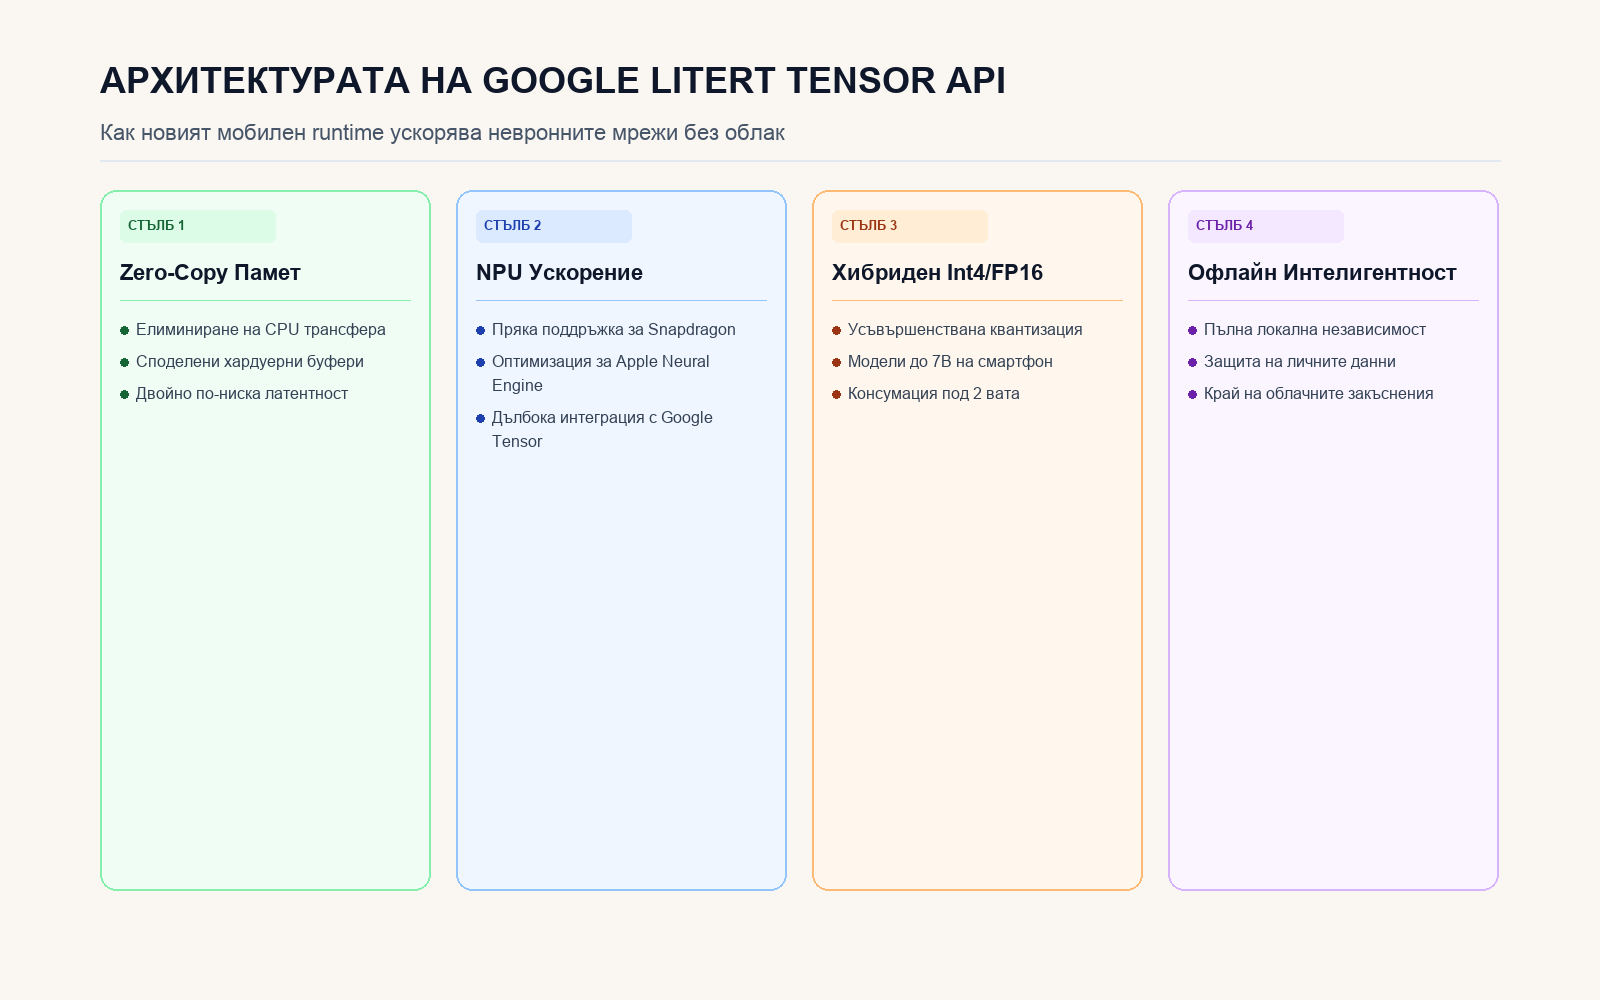
Анализ на Zero-Copy паметта, NPU делегатите и енергийната ефективност на мобилни чипове.