Разработчици алармират за фоново включване на обучение върху частни сесии в OpenAI Codex
Източник: Hacker News / Developer Community
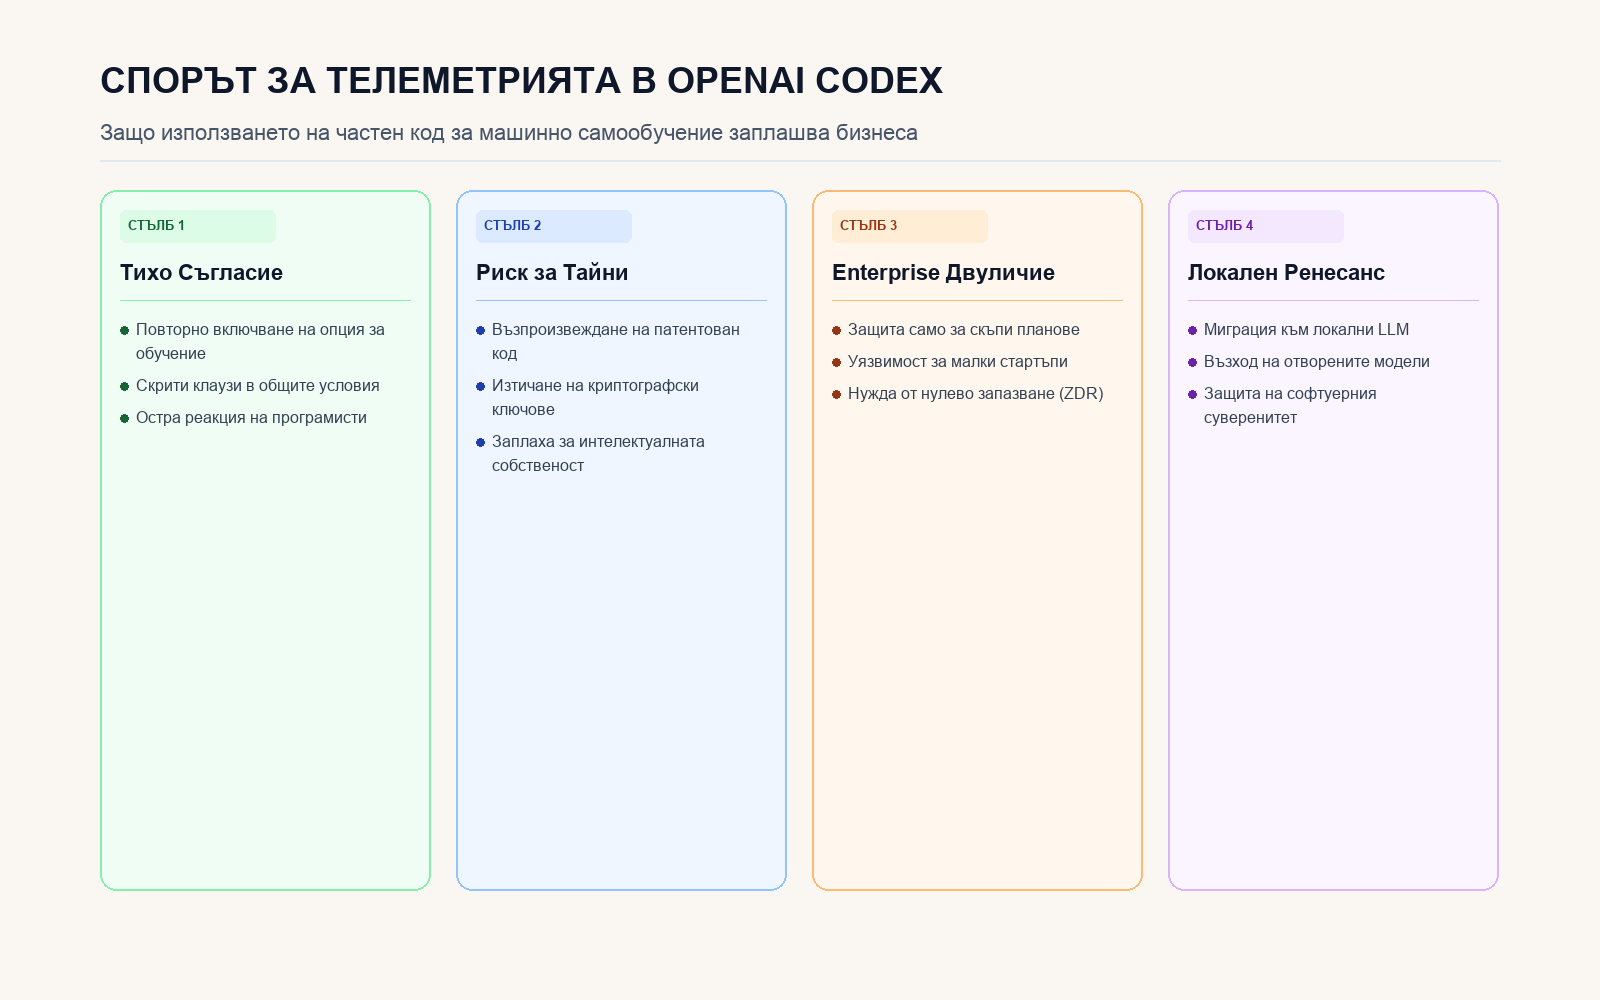
В инженерната платформа Hacker News избухна остра полемика, след като десетки разработчици установиха, че най-новите актуализации в условията за ползване на OpenAI Codex тихомълком активират повторно съгласието за използване на потребителски кодови фрагменти за бъдещо обучение на модели на OpenAI [1].
Опасност от изтичане на търговски тайни и архитектурен ноу-хау
Много технологични компании използват кодови асистенти за ускоряване на разработката на proprietary софтуер, включително финансови алгоритми и криптографски протоколи. Ако тези сесии бъдат включени в обучаващите масиви за следващото поколение модели, съществува реален риск алгоритъмът да възпроизведе патентован код при запитване от конкурентна организация.
Необходимост от прозрачни opt-out механизми в корпоративните договори
Въпреки че от OpenAI побързаха да уверят, че за платените enterprise клиенти данните остават строго изолирани, индивидуалните разработчици и малките стартъпи често биват изложени на риск поради неясни настройки в потребителския профил. Инженерни лидери призовават за въвеждане на задължителни одитирани гаранции за нулево съхранение на данни (zero-data retention).
Конфликтът за суровините на софтуерния интелект
Спорът около Codex разкрива фундаменталния глад на AI лабораториите за висококачествени данни за обучение. След като изчерпаха публично достъпния код в GitHub, създателите на модели отчаяно се нуждаят от сложен, модерен софтуерен контекст от реалния свят. Но превръщането на потребителите в безплатни донори на интелектуална собственост заплашва да счупи доверието в инструментариума и да ускори изграждането на изцяло локални, автономни кодови модели с отворен код.
Анализ на условията за поверителност, рисковете от изтичане на ноу-хау и корпоративния отговор.