Confluent представи Streamhouse: Сливане на поточни данни в реално време с Apache Iceberg за нуждите на ИИ
Източник: Confluent Blog / Confluent
Лидерът в управлението на поточни данни Confluent представи фундаментална нова парадигма за корпоративна инфраструктура под името Streamhouse, обединяваща потоците в реално време от Apache Kafka и Apache Flink с отворените таблични формати Apache Iceberg [1]. Решението е проектирано специално за захранване на модерни системи за контекстно извличане (RAG), гарантирайки, че автономните модели разполагат с информация, обновена преди секунди, а не преди часове.
Край на разделението между транзакционни и аналитични хранилища
Традиционната архитектура изискваше тромави ETL процеси, които прехвърляха данни от оперативните бази към езера от данни през нощта. Streamhouse записва пристигащите Kafka събития директно в Iceberg метаданни в рамките на субсекундни интервали. Това позволява на векторните индекси и аналитичните заявки да четат единен източник на истина без дублиране на съхранението.
Елиминиране на халюцинациите чрез абсолютно свеж контекст
За финансови приложения, динамично ценообразуване и вериги за доставки остарелите данни са основен източник на фатални грешки при AI агентите. Със Streamhouse агентът може да направи справка за наличност или борсова котировка и да получи потвърждение от преди милисекунди, гарантирайки бизнес прецизност.
Данните в движение като гръбнак на автономната икономика
Появата на концепцията Streamhouse бележи узряването на информационната инфраструктура за ерата на изкуствения интелект. Един модел, независимо колко милиарда параметри притежава, е безполезен, ако е изолиран от пулса на реалния бизнес. Сливането на стрийминга и мащабните отворени хранилища превръща данните в жив, непрекъснато циркулиращ поток, който захранва дигиталните асистенти с точното знание в точния момент. Това ще промени драстично архитектурата на корпоративните софтуерни гиганти.
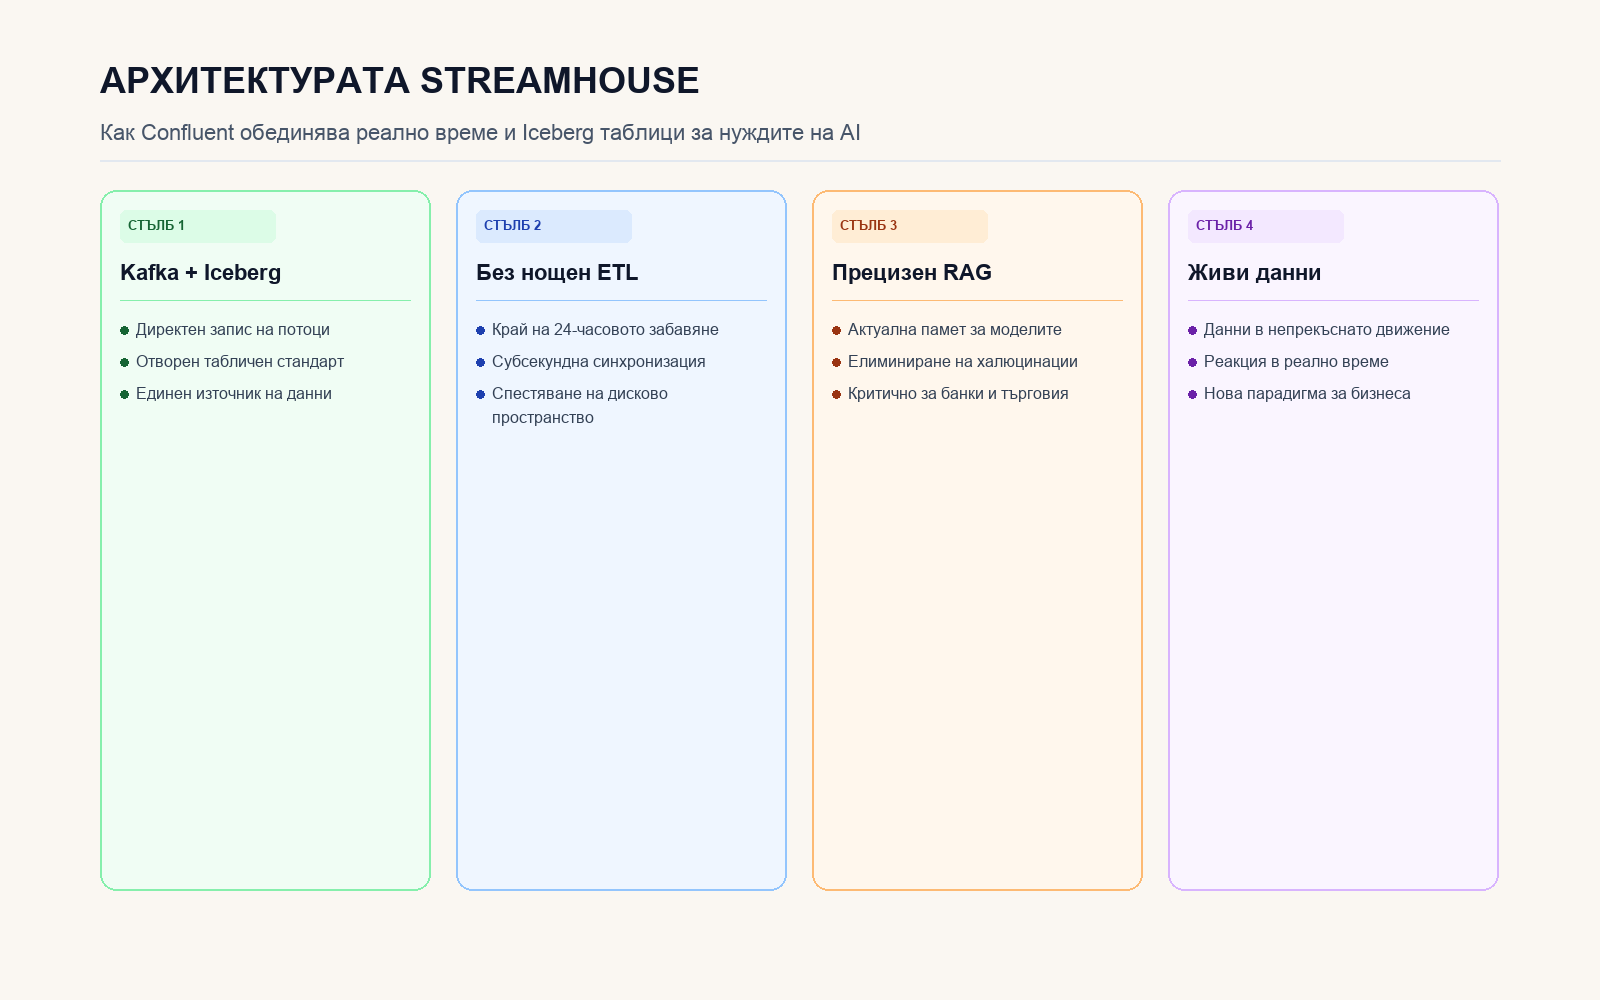
Сравнение между традиционен бачов ETL и непрекъснат стрийминг с нулево закъснение.