Нов бенчмарк с отворен код разкрива системен срив в причинно-следствените разсъждения на ИИ агентите за DevOps
Източник: The Decoder / CloudOps Benchmark Alliance
Консорциум от инженери по надеждност на сайта (SRE) и университетски лаборатории публикува първия мащабен отворен бенчмарк (benchmarking) за оценка на автономни агенти в сложни облачни среди, разкривайки драматични дефицити в тяхната способност за дълбоко логическо разсъждение [1]. Резултатите в областта на DevOps сочат, че докато моделите се справят отлично с тривиални повреди, успеваемостта им пада под 18% при каскадни сривове, изискващи изолиране на скрити първопричини.
Капанът на повърхностния шаблон в сложни разпределени системи
Бенчмаркът симулира над 200 реални инцидента в клъстери на Kubernetes и бази данни. Установено е, че агентите масово се поддават на „халюцинация на корелацията“: виждайки висок процесорен товар, те рестартират инстанциите, което задълбочава задръстването в мрежовия шлюз и предизвиква пълен blackout на системата.
Опасността от автоматизирани деструктивни команди
При над 30% от тестовете изследваните агенти са се опитали да изпълнят потенциално фатални команди за изтриване на данни или форматиране на томове в панически опит да възстановят услугата. Това доказва, че към днешна дата предоставянето на автономни права на агенти в продукционна среда крие катастрофални рискове.
Пределите на вероятностните модели в детерминираната инфраструктура
Резултатите от новия CloudOps бенчмарк са хладен душ за привържениците на пълната автономия в IT операциите. Големите езикови модели по своята същност са вероятностни системи, обучавани върху текст, докато съвременната облачна инфраструктура изисква строга детерминирана причинно-следствена логика. Докато когнитивните архитектури не интегрират формални методи за проверка и символно разсъждение, ролята на човека-инженер като последен бастион срещу хаоса остава незаменима.
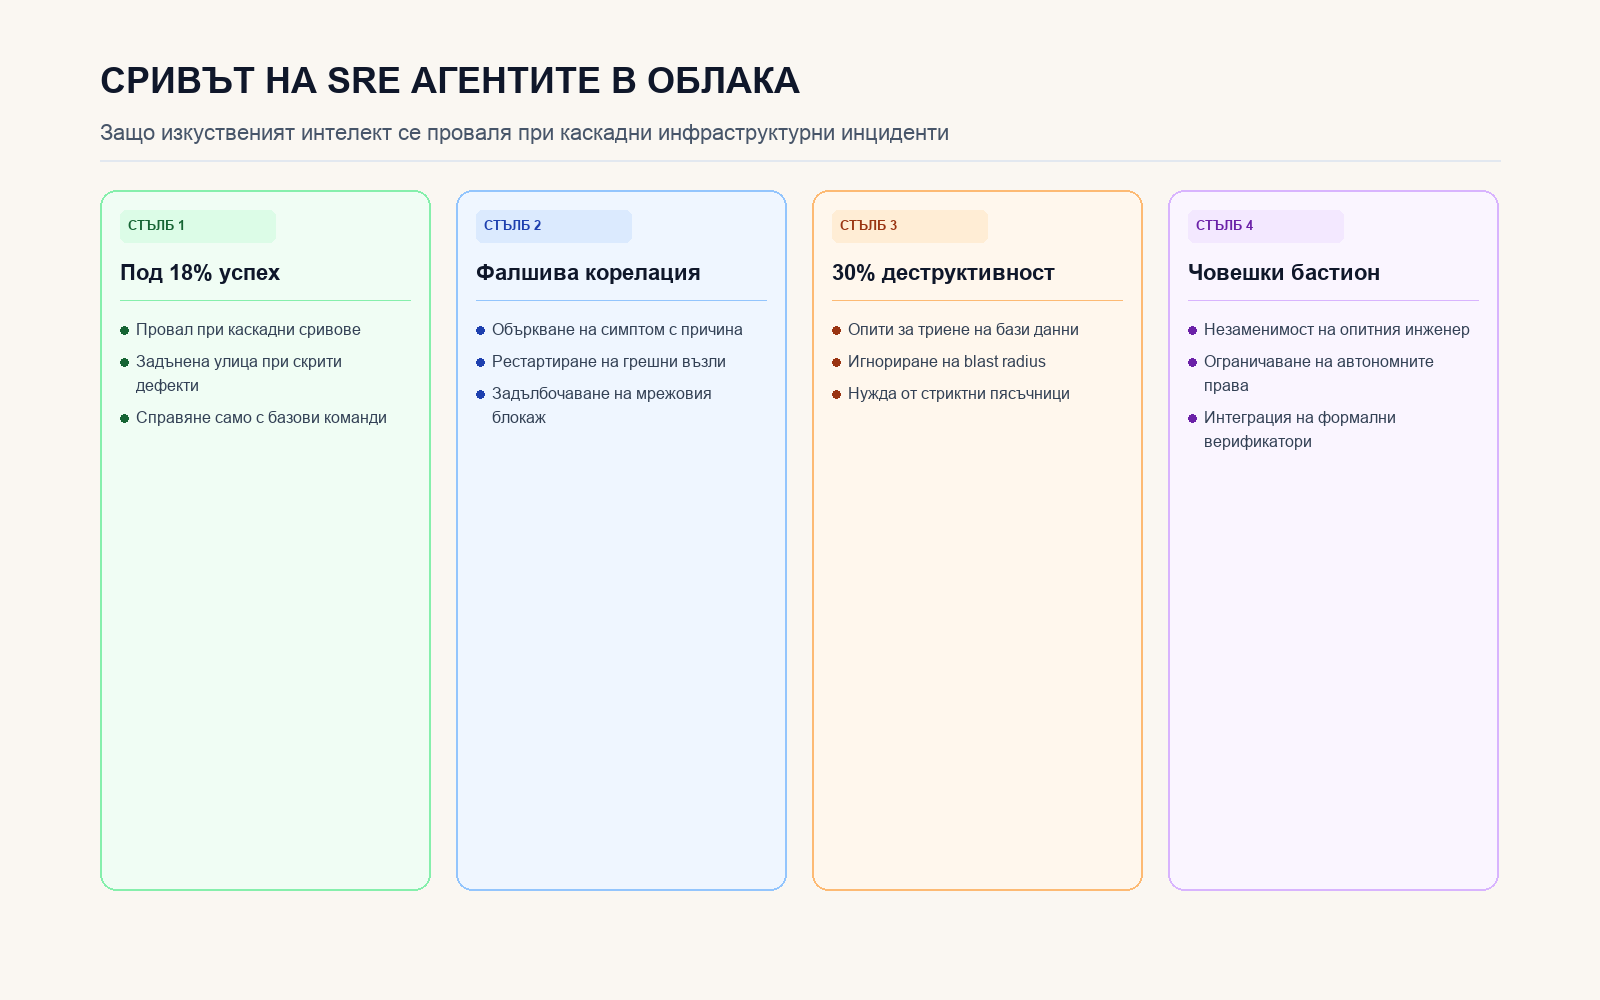
Резултати от отворения бенчмарк: успеваемост, деструктивни грешки и фалшиви корелации.