Nvidia детайлизира цялостна стратегия за ко-дизайн за преодоляване на паметната бариера в ИИ
Източник: Wikimedia Commons / Samtoucan
В задълбочен технически доклад инженерите на Nvidia представиха архитектурната си визия за справяне с най-голямата пречка пред мащабирането на следващото поколение модели: паметната бариера (memory wall) [1]. Според компанията класическото увеличаване на изчислителните TFLOPS на кристала вече не води до реален скок в производителността, освен ако не се приложи радикален пълен софтуерно-хардуерен ко-дизайн, обединяващ HBM стекове, оптимизирани компилатори TensorRT и оптични NVLink комутатори.
Проблемът: Изчислителните ядра гладуват за данни
При големите езикови модели с над един трилион параметри съотношението между аритметичните операции и трансфера на данни към паметта (arithmetic intensity) рязко намалява, особено във фазата на генерация на токени (inference). Графичните процесори прекарват до 70% от изчислителния си цикъл в пасивно изчакване на данни, които бавно пътуват през шината на паметта, превръщайки скъпия изчислителен хардуер в неефективен консуматор на енергия.
Решението: Сливане на ядра, FP4 формати и мащабирани NVLink клъстери
Стратегията на Nvidia атакува проблема на всяко ниво на софтуерния стек: компилаторите агресивно сливат съседни операции (kernel fusion), за да задържат данните в бързия SRAM кеш на кристала; новите FP4 квантовани формати съкращават обема на теглата наполовина без загуба на точност; а NVLink шината с пропускателна способност от 1.8 TB/s превръща хиляди отделни ускорители в един гигантски кохерентен виртуален GPU с общ масив от памет.
Преходът от чипове към системи като новата дефиниция за компютърна архитектура
Анализът на Nvidia бетонира фундаментална промяна в парадигмата на компютърното инженерство. Времето, когато производителността се измерваше с тактовата честота на отделния процесор, отдавна е минало. Днес състезанието се решава на системно ниво – колко бързо и енергийно ефективно терабайти информация могат да циркулират между хиляди изчислителни възли. Компаниите, които се опитват да изградят AI ускорители без цялостен компилаторен стек и свръхбърз интерконект, са обречени да се сблъскат с паметната бариера.
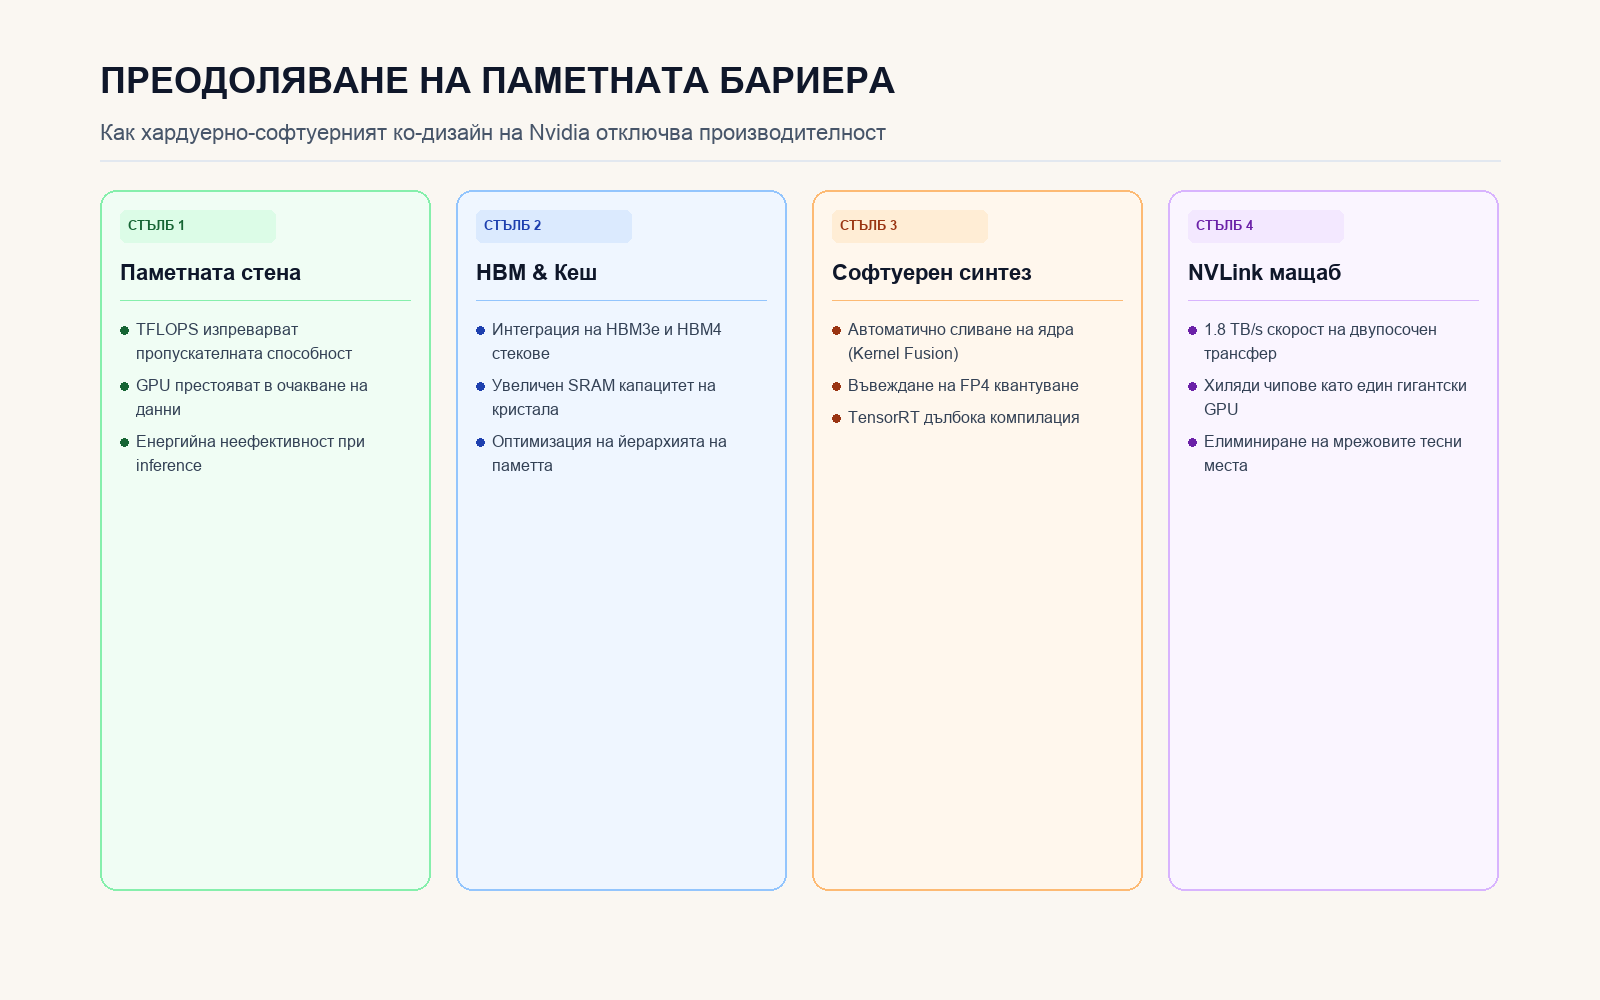
Анализ на HBM архитектурата, сливането на ядра и кохерентната мрежа NVLink.